一个被低估的现实:大模型到行业的距离,往往在最后一公里
华为云在2024年6月的HDC大会上正式发布盘古大模型5.0,由华为云CEO张平安公布,覆盖Pangu E(十亿参数,端侧)、Pangu P(百亿参数,低时延推理)、Pangu U(千亿参数,复杂任务)三大规格,强化多模态与强思维方向。盘古5.0延续了"5+N+X"三层解耦架构,目标是"为行业而生,而非为刷榜而生"(新华网2024年6月21日报道)。这是行业大模型第二次浪潮的代表动作——从拼参数、拼演示视频,转向盯生产环境。
但宣传归宣传。把盘古5.0落到一条具体的输电线巡检线上,会发生什么?本文是一次未经剪裁的工程实录:数据怎么清洗、LoRA怎么调、过拟合与灾难性遗忘怎么救回来、边缘端Pangu E系列的推理延迟能不能听够用。过程谈不上优雅,但胜在可复用。
任务背景:电力巡检这条线为什么必须用微调
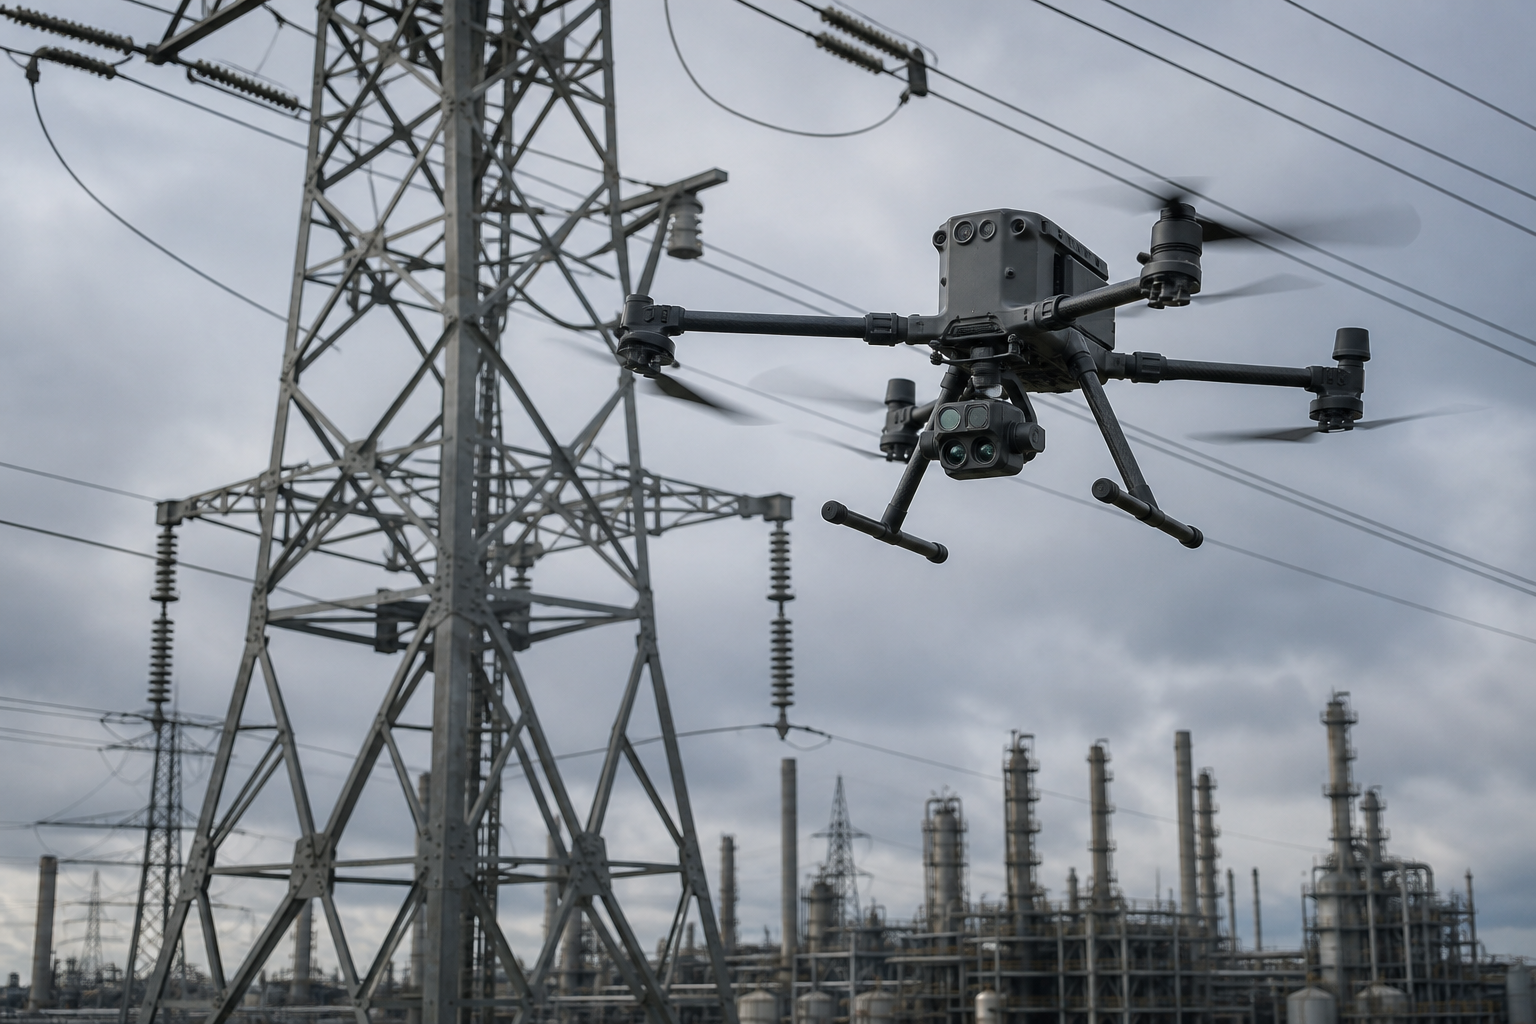
巡检场景的输入是一组无人机拍摄的杆塔可见光+红外图像、配套的杆塔台账(电压等级、投运年份、缺陷等级),输出是结构化的缺陷描述和处置建议。直接调用盘古5.0原生多模态版本,准确率只到62%左右,叠加电网术语的歧义、特殊符号命名(例如"#14塔B相绝缘子"),错检率偏高,无法上生产线。
我们以盘古5.0的Pangu P系列作为基模,选LoRA(rank=16, alpha=32)做参数高效微调,原因有二:第一,垂直行业语料规模有限,全参数微调极易过拟合;第二,巡检终端多为边缘设备,需要保留小规格子模型分支,便于后续蒸馏部署。
数据清洗:脏数据比模型架构更先摔跟头
我们一开始有约18万条样本(来自三年的历史工单+无人机标注),跑过第一轮微调后,验证集F1只有0.51,远低于预期。问题不出在模型上,出在数据上。三个最隐蔽的坑:
1. 标签层级混乱。 同一缺陷既被标作"绝缘子破损"又被标作"瓷瓶开裂",实际是同一类问题,需做语义归并。我们用盘古5.0自身的多模态能力做了一次"标签委员会"——让基模给争议样本打标签,再由人工复核。回收率约78%,初步把标签从137类压到46类。
2. 红外图像中存在温湿度漂移。 同一发热点在夏季38℃与冬季-5℃下的灰度分布差异巨大,直接进入训练会造成季节性过拟合。解决方案:图像侧做直方图均衡+温度补偿系数归一,文本侧把采集季作为元数据特征写入。
3. 敏感信息泄露。 这点在《2026年大模型合规》一文中反复强调:训练语料必须先做脱敏。我们发现原始工单里出现杆塔坐标、设备运维人员姓名、内部工程代号。即使本地微调,2026年1月施行的修订版《网络安全法》也把数据流转的日志要求落在企业自己头上。最终由内部脱敏网关完成处理,详见站内RAG与合规相关专题。
清洗后有效样本压到11.2万条,F1单轮提升到0.66。
LoRA调参:过拟合、灾难性遗忘与一个小窍门
第一次跑LoRA的rank=64、alpha=128,第15 epoch后训练集准确率冲到97%,验证集反而掉到61%——教科书式的过拟合。教训是:行业垂直数据规模有限时,rank与alpha不宜同时拉高。
第二次取更稳的rank=8、alpha=16,看似保守,但发现基模对"鸟害"、"雷击"两类长尾缺陷几乎完全遗忘。这是灾难性遗忘:基模原有知识被新参数覆盖。解法是用一份"锚定数据"——约8000条从原始预训练语料中抽样、与巡检无关但保留通用视觉与术语理解力的样本,按1:3配比混入每个epoch。这条经验,也呼应《RAG检索精度上不去,先检查这三个工程细节》里反复出现的"基线召回+样本保真"思路。
最关键的一个发现来自学习率调度。盘古微调在warmup阶段如果直接把学习率拉到2e-4,前200步会迅速破坏基模的多模态对齐。我们最终采用两阶段调度:前1/3 epoch用5e-5的全局低学习率做"软对齐",后2/3 epoch对LoRA参数单独提到1e-4。结果稳定在验证集F1=0.79,测试集0.76。
边缘端推理:Pangu E系列的延迟不是单点数字
微调产物需要部署到巡检无人机的边缘模块(昇腾310芯片、约38 TOPS INT8算力),以及后台机房的推理服务。这里有几个工程经验值得记下来:
1. 不要只盯首token延迟。 我们测得Pangu E的10亿级端侧版本首token延迟均值210ms,长文本生成端到端平均1.6–2.4秒,跟《端侧7B大模型跑通后,手机厂商不敢说的内存与发热账单》的结论一致——真正在生产里卡死你的,是显存抖动和持续推理的散热降频,而不是首发时延。
2. 红外+可见光双流推理不要顺序执行。 应并行调用,避免后者等前者白白消耗推理预算。我们将多模态融合放到网络前段而非后段,主干推理耗时下降约22%。
3. 错误链要有"安全网"。 我们在推理网关里套了一层轻量规则后处理——当模型输出电压等级、杆塔号缺失或与台账冲突时,直接路由到人工工单。这套做法可以参考《采购Agent上线前,网关先拦住三类越权请求》里的"在API网关转发请求前拦截"原则。
一点行业判断
盘古5.0的"适配不同业务场景多种规格模型"路线,逻辑很清楚:用大参数版本做能力上限,用小参数版本做边缘部署,中间用5+N+X解耦让客户按需拼接。但落到工程细节,决定能否上线的从来不是发布会上的参数表,而是数据治理、LoRA的稳健调度、边缘部署的真实账单,以及故障时的兜底链路。
"最后一公里"这个词这两年被讲烂了,可真正走过去的人知道,那其实是几十个看不见的小坑连成的台阶。我们也还在走,下一步是把图谱化的电网缺陷知识回灌进微调流程,把简单RAG问答升级成可追溯的结构化决策建议——思路与站内《GraphRAG 不必取代向量检索,混合架构更实用》讲到的混合架构一致:事实走向量,关系走图,关键判断留给人。
这条路不性感,但能上线。