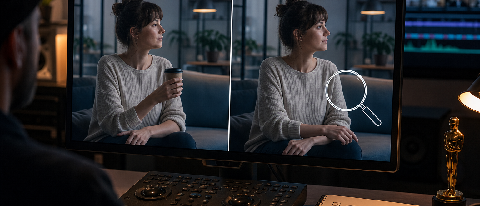
2026年4月Sora关闭公众接口、仅留企业级服务后,许多依赖AI视频生成的创作者和后期公司被迫寻找替代方案。在这半年的空窗期里,快手在2月5日全球上线的可灵3.0系列模型(包括可灵视频3.0及3.0 Omni)意外接住了这波流量。特别是在音频驱动视频(Talking Head)场景下,可灵3.0确实做到了“一句话让角色开口”,但在深度实测中,背景稳定性的瑕疵依然暴露了当前AI视频生成的物理认知短板。
口型与音画同步:OmniSync解决了什么?
做音频驱动视频,最难的不是让嘴动起来,而是让嘴动得不违和。过去很多模型的通病是“皮影戏”效应——只有嘴唇在动,下巴、脖子甚至面部肌肉都是僵硬的。
可灵团队在底层技术上给出的解法是OmniSync。根据技术社区的拆解,原视频的说话状态会带动口型、面部表情、脖子纹理、下巴阴影等一系列联动反应,这种深度耦合曾是让音频驱动效果大打折扣的元凶。OmniSync的核心突破在于处理这种耦合关系,实现了无限时长下的强ID保持,甚至在遮挡情况下也具备强鲁棒性。
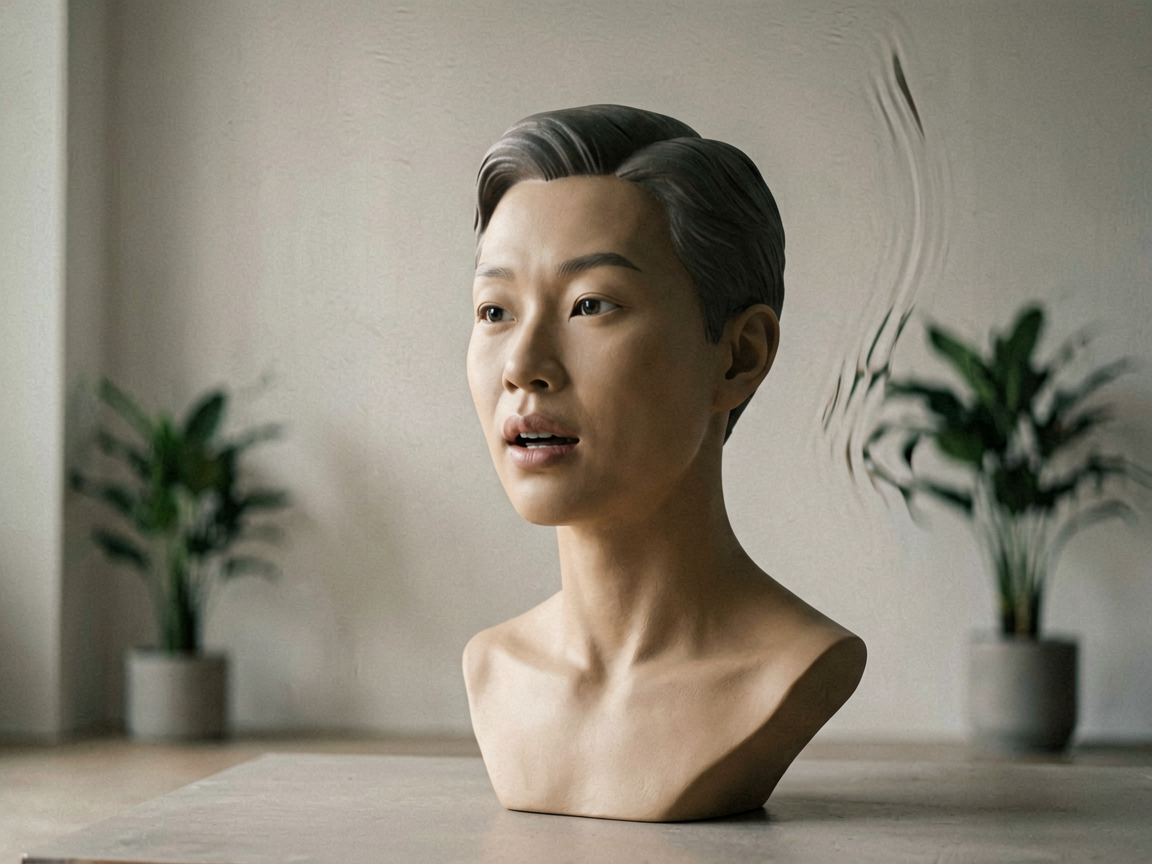
在实际测试中,导入一段15秒的静态人物视频并配上一段中文语音,可灵3.0 Omni生成的视频中,角色不仅口型与发音精准对齐,连说话时下颌的开合幅度、脸颊肌肉的起伏都有相对自然的过渡。更令人意外的是多语种和方言的支持。根据可灵官网介绍,其音画同步能力实现了文本与视觉角色的精准映射,甚至支持多语混说。我们尝试输入了一段“川普”混搭粤语的音频,角色的口型依然保持了高度的贴合度,没有出现明显的吞音或错位。
多人同框的指代混乱终结者
除了单人说话,多人对话场景一直是AI视频生成的“重灾区”。过去如果画面里有两个人,输入音频后往往是两个人同时张嘴,或者口型乱飞。
可灵3.0在这个场景下交出了一份不错的答卷。其音画同步能力升级后,彻底解决了指代混乱的难题。在一段两人对话的测试视频中,通过文本提示指定发言角色,模型能够准确识别并在对应的时间轴上驱动目标人物的口型和表情,另一个人则保持倾听或微反应状态。这种精准的声画映射,让AI视频从“单人脱口秀”走向了真正具有叙事感的多角色对话。
对于影视后期从业者来说,这意味着分镜和台词对位的效率大幅提升。以前需要手动在剪辑软件里对轨和调整表情参数的工作,现在可以通过提示词和音频直接生成。在《Sora 3关停公众接口后,影视后期公司怎么算这笔账》一文中,我们曾探讨过特效师角色向“校验物理逻辑”转变的趋势,可灵3.0的这种多角色控制力,正在加速这种工作流的重塑。
背景穿帮:物理常识的边界在哪里?
尽管人物主体的表现已经相当惊艳,但可灵3.0在音频驱动模式下依然没有完全摆脱AI视频的“幻觉”顽疾——背景不稳定。
在一段测试中,当角色情绪激动、语速加快时,人物身后的书架上的书本边缘开始出现轻微的扭曲和闪烁。另一段户外场景中,角色说话时,背景里的树叶纹理随着音频的节奏发生了不自然的呼吸感形变。这种“穿帮”虽然在快速浏览时不易察觉,但在专业大屏或4K清晰度下审视时,依然会打破视觉真实感。
这背后反映的是当前多模态大模型对物理世界理解的局限。模型在处理音频信号时,注意力机制不可避免地会泄漏到非目标区域(即背景)。虽然OmniSync在人物ID保持上做到了强鲁棒性,但在背景物体的时序一致性上,仍缺乏类似物理引擎的硬性约束。这也是为什么在《小米SU7 Ultra赛道实测:端到端智驾在极限工况下的表现》中提到的“光影幻觉与物理边界”问题,同样存在于视频生成领域——AI学会了模仿像素的分布,却还没真正理解物体的刚性。
成本账本:Sora 3企业级 vs 可灵3.0
技术表现最终要落在商业化的成本账本上。Sora 3关停公众接口后,其企业级API的调用成本让不少中小团队望而却步。相比之下,可灵3.0的计费模式更贴近国内创作者的承受力。
以生成一段15秒的4K多角色对话视频为例,Sora 3企业级接口的算力消耗和调用费用往往需要按分钟甚至秒级计费,且排队时间不可控。而可灵3.0通过快手自身的算力基础设施调度,在响应速度和单次生成成本上具有明显优势。对于需要高频试错的内容团队来说,这种成本差异直接决定了项目的ROI。
此外,对于有数据隐私和合规需求的企业,本地部署或私有化方案仍是刚需。正如我们在《显存才是硬通货:2026年本地跑大模型要花多少钱》中提到的,API按Token计费越来越贵,数据攥在别人手里始终是隐患。虽然可灵3.0目前主要以云端API形式提供服务,但快手在底层算力调度上的优化,为未来可能的边缘侧或轻量化部署留出了空间。
结语
可灵3.0(L3)在音频驱动视频领域的表现,证明了国产AI视频生成模型已经具备了与国际头部产品掰手腕的实力。OmniSync技术带来的口型同步精度和多角色控制能力,切实解决了创作者的痛点。但背景稳定性的穿帮问题也提醒我们,AI视频生成尚未到达“完美输出”的终局。在Sora 3退守企业级市场的当下,可灵3.0用更高的性价比和接地气的方言支持赢得了市场,但真正的护城河,仍需建立在更深层次的物理世界理解之上。