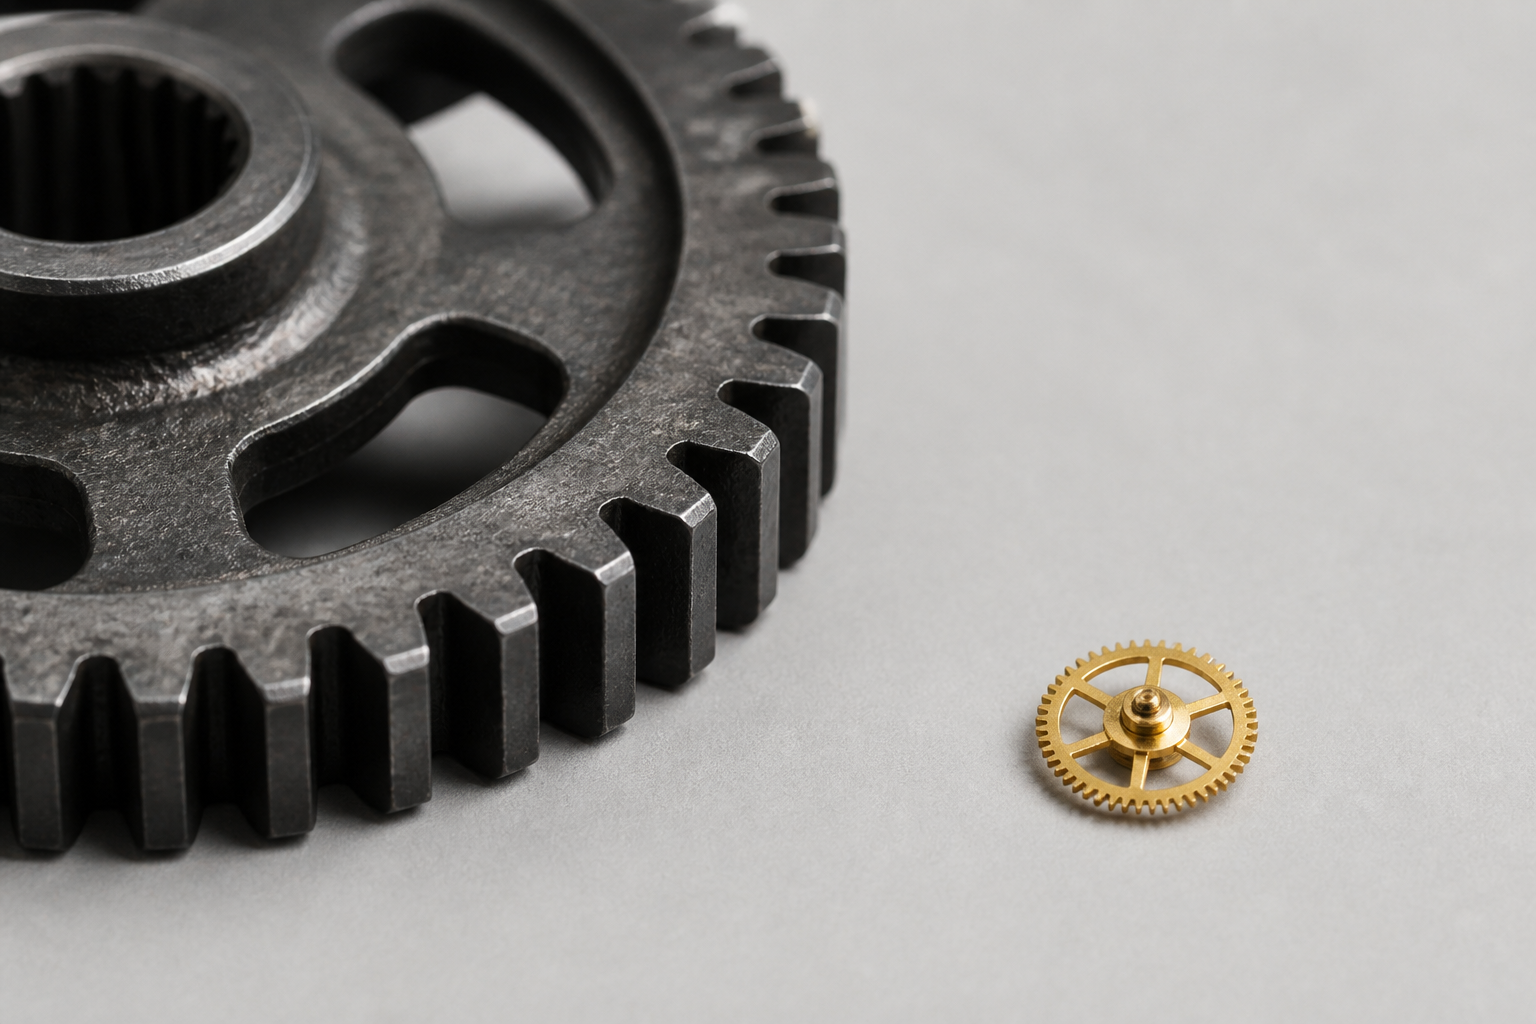
一边是2.8万亿参数,一边是3B(30亿参数)。放进同一张企业选型表,它们解决的往往不是同一类问题。
据《参考消息》2026年7月18日转述,月之暗面于7月16日推出开源模型Kimi K3,参数规模达2.8万亿。月之暗面称其为全球参数规模最大的开源模型,主要面向软件开发、知识密集型工作和深度研究。这类模型负责抬高复杂任务的能力上限。
企业日常还有另一批活:客服意图分流、字段抽取、固定格式生成、RAG问答。这里先看的通常是响应速度、并发能力、部署条件和持续账单。说“3B已经成为企业首选”仍然太满。更合适的判断是:任务边界越清楚,3B越值得先测。
先把“15倍”放回来源里
“推理成本暴涨15倍”很抓眼球。一篇二次解读文章以此为题,并援引信通院2026年报告。但在现有素材中,没有可供核验的原报告链接、统计周期和计算口径,15倍不能直接写成行业定论。
另一条信息来自腾讯云开发者社区。该文给出“2026年AI推理成本占比超过80%”的判断。由于摘要没有展开分母,这个数字也不该被扩写成“占企业IT预算80%”。
数字需要谨慎,账单问题却绕不开。训练是一段时期的投入,推理会随着每次请求重复发生。RAG上下文有多长、输出多少Token、并发多高,都会改变最终成本。企业真正怕的,是低价值请求被反复送进昂贵模型。
3B赢的不是总分,是任务边界
模型蒸馏并不是把万亿参数完整塞进3B。它让小模型学习教师模型在特定任务上的输出方式,再配合微调、剪枝和量化,把能力集中在一类问题上。
Nanbeige4-3B这类模型进入候选名单,靠的也不只是参数小。分类标签固定、输出格式固定、知识范围可控,错误还能被规则或人工发现,这些条件比模型跑分更重要。客服意图分流、信息抽取、固定流程校验和特定工控指令生成,都适合按这个思路测试。
“达到旗舰模型90%以上准确率”听上去明确,却缺少统一测试集和可核验来源。即便平均指标接近,漏检类型也可能完全不同。合同审查、医疗处方等高风险任务,仍要保留大模型复核或人工兜底。站内此前讨论3B模型时也强调过:先测漏检,再谈平替。
同样是3B,采用INT4还是FP8、上下文多长、批量多大,显存占用和吞吐都会变化。能否在RTX 4090或昇腾卡上稳定运行,不能只看参数量。“单卡能跑”和“生产环境扛得住并发”是两回事。
vLLM能省显存,不能替企业做选型
腾讯云开发者社区文章把vLLM的PagedAttention 3.0列为重要优化,称其可以缓解显存碎片化,并降低50%以上的推理成本。这个数字有明确出处,但不能当成所有业务都能直接领取的折扣。
请求长短、并发方式、硬件、量化精度以及LoRA切换,都会影响优化结果。vLLM和TensorRT-LLM该选谁,也要拿真实负载压测,而不是只比较发布数据。站内此前的选型讨论可以归结为一句话:别脱离负载谈性能。
还有一种常见误判:小模型单次调用便宜,就等于整条业务链便宜。如果3B需要更长提示词、反复重试,或者频繁转交人工,表面上的成本优势会被吃掉。更有用的指标是完成一次合格任务花了多少钱,而不只是单个Token的价格。
端侧省下云调用,也躲不过散热
3B对端侧AI有吸引力,原因很直接:手机、AI PC、工业设备和人形机器人如果能在本地完成推理,就能减少网络传输和云端调用,敏感数据也不必频繁离开设备。
但本地运行不自动等于合规,也不自动等于稳定。内存、功耗和散热会影响持续性能,模型文件、日志和权限仍需管理。一次短时演示能跑,不代表设备在长期负载下不会降频。端侧测试必须把高温和持续运行纳入压测,而不能只看峰值速度。
更实用的做法是分流:短指令、固定任务和隐私敏感请求留在端侧;长文本和开放式任务交给云端;结果不确定时,再升级到更大的模型或人工审核。云边混合的重点是调度,不是强行让所有节点都运行3B。
企业要选的不是参数,而是一套分级规则
模型上线前,至少要回答几个具体问题:
- 业务有没有可复现的测试集,哪些错误绝对不能出现?
- 3B经过微调或模型蒸馏后,能否达到业务门槛?
- 当前成本主要花在算力、网络,还是人工复核?
- 小模型答不稳时,能否自动转交大模型或人工?
2025年3月19日,汤道生在腾讯新闻的报道中提出要打造“好用的AI”。同一份材料提到,腾讯2023年推出的混元旗舰模型已达万亿级参数;介绍混元Turbo S时,又强调大多数通用任务的“秒级响应”。追求模型上限和压低实际使用门槛,本来就可以同时进行。
Kimi K3适合探索复杂任务,3B适合承接边界清楚、重复频繁的请求。企业没有必要让小模型取代所有大模型,也没必要让每个请求都调用最大的模型。把请求交给成本最低且能够达标的那一档,并留好升级通道,这才是推理成本战里更稳妥的做法。