宁波一家转向节工厂的质检Agent上线第一天,因为读不懂老ERP的DBF文件,直接把良品当次品退了回来。这不是段子——2026年上半年我在制造企业走访中反复听到类似的开场。
径硕科技在《制造业AI Agent:六大场景与落地策略全解》中统计过:超过七成的试点企业在AI落地第一阶段就被遗留系统绊倒,其中ERP系统年龄超过15年的占63%。这意味着,当多模态质检Agent试图主动读取物料规格、工单信息和历史缺陷记录时,它首先要面对的是一套连HTTP都不认的二十年前数据库。
转向节工厂的“数据断层”
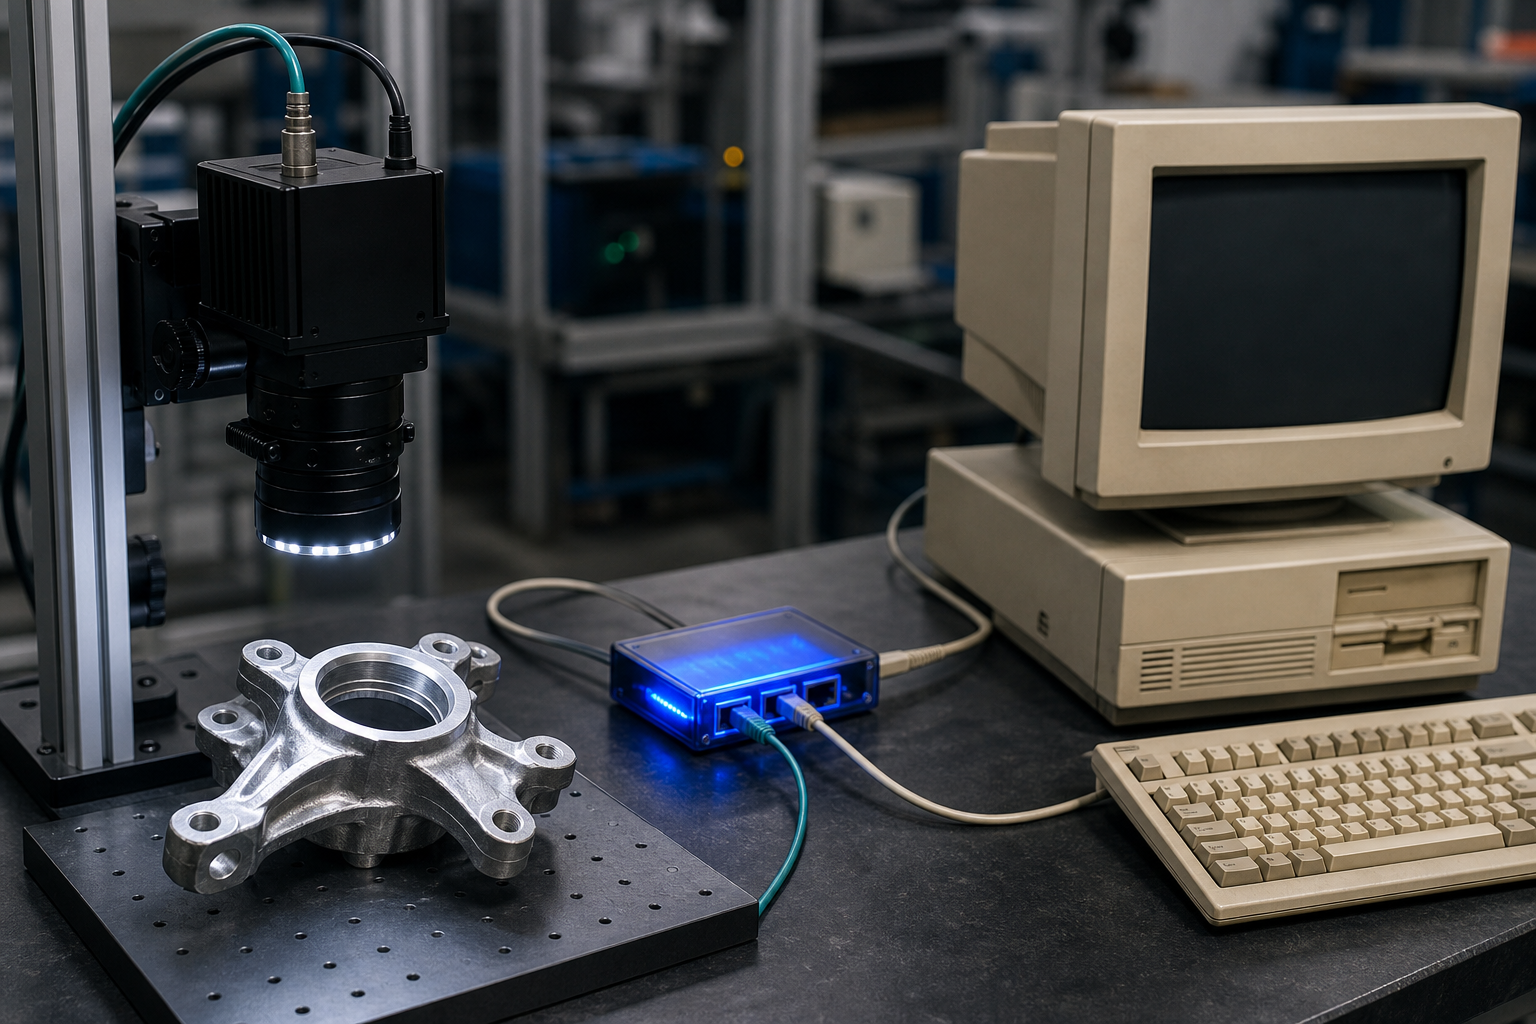
我们拆解的对象是宁波一家给大众供应转向节的中型工厂。2026年3月,该工厂上线了一套基于多模态大模型的质检Agent,用于检测转向节表面的裂纹、砂眼等缺陷。Agent的视觉部分搭载了工业相机和边缘计算盒子,推理一个样本需要200ms,精度达到98.5%。但问题出在数据供给侧——Agent在判断缺陷是否超标时,需要实时查询ERP系统中的BOM表,确认该物料允许的划痕深度、气孔直径等公差。
这台ERP是1999年部署的IBM AS/400,运行着DB2数据库,对外只支持5250终端协议和定时DBF文件导出。没有REST API,没有ODBC桥接,甚至连编码都是GB2312。车间每天下班后导出一份CSV,第二天上班再导入新系统。Agent等不了24小时——它要在每件产品流经时立刻知道规格。
这恰好呼应了CSDN上那篇《AI Agent概念满天飞,但真正的工业智能体已经在中国工厂跑起来了》的观点:工业AI落地最难的从来不是算法,而是如何让新模型“听懂”老系统的方言。
中间件:一条协议转换的“呼吸管”
我们的解决方案是在质检Agent和老ERP之间部署一层中间件。它承担三个职责:
- 协议转换:将DB2的SQL查询封装为REST API,供Agent按需调用。
- 编码桥接:自动识别老系统的字符编码(GB2312/GBK/Latin1),统一转成UTF-8输出。
- 缓存与限流:老数据库并发能力弱(最大连接数仅16),中间件用Redis缓存热点数据,并设置查询间隔不低于2秒。
核心代码并不复杂。下面是中间件的一部分——一个查询物料规格的Flask端点:
from flask import Flask, jsonify
import pyodbc
import redis

app = Flask(__name__)
cache = redis.Redis(host='localhost', port=6379, db=0)

def get_db_conn():
    conn_str = (
        "DRIVER={IBM DB2 ODBC DRIVER};"
        "DATABASE=ERP01;HOSTNAME=10.10.1.50;PORT=50000;"
        "PROTOCOL=TCPIP;UID=agent;PWD=secret;"
    )
    return pyodbc.connect(conn_str, timeout=5)

@app.route('/api/spec/<part_no>')
def get_spec(part_no):
    cached = cache.get(f"spec:{part_no}")
    if cached:
        return jsonify(eval(cached))
    conn = get_db_conn()
    cursor = conn.cursor()
    try:
        cursor.execute("SELECT SPEC, TOLERANCE FROM PART_SPEC WHERE PART_NO = ?", (part_no,))
        row = cursor.fetchone()
        if row:
            spec_raw = row[0].encode('latin1').decode('gbk')
            tolerance = float(row[1])
            data = {"part_no": part_no, "spec": spec_raw, "tolerance": tolerance}
            cache.setex(f"spec:{part_no}", 300, str(data))
            return jsonify(data)
        else:
            return jsonify({"error": "not found"}), 404
    finally:
        conn.close()

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5001)
这段代码是上线第一版的原型,但第一次测试就暴露出好几个坑。
避坑记录:与19年古董DB斗智斗勇
坑1:编码陷阱。AS/400默认EBCDIC编码,但导出到ODBC时被映射为Latin1,而数据实际是GB2312。直接decode('gbk')会崩溃,必须先用Latin1读取字节,再转GBK。上面的encode('latin1').decode('gbk')就是为此。这种隐式依赖正是《自然语言编程,卡在旧系统里》一文中强调的“遗留系统的隐形炸弹”。
坑2:连接耗尽。老数据库允许的并发连接极少,测试时Agent并发查询10个规格就直接把连接池打满,导致其他终端卡死。最终加了连接池(SQLAlchemy的pool_size=3)和请求限速。
坑3:数据滞后。生产计划变更后,BOM表每天更新一次,但Agent读到的是前一天的数据。我们增加了手动刷新API,并在Agent决策中加入“数据时间戳校验”,如果规格数据超过8小时未更新,则暂停自动判定并告警。
坑4:事务隔离。默认读未提交,加上SET TRANSACTION ISOLATION LEVEL READ COMMITTED确保读到已提交数据。
这些坑在《自然语言编程,卡在旧系统里》一文中也有类似映射——AI编程工具生成代码容易,但遗留系统的隐式依赖才是真正的陷阱。
从“能跑”到“好用”,中间件只是开始
经过三周开发和两周联调,这套中间件成功让质检Agent实时读取到了ERP数据。装上缓存的版本平均查询耗时从1.2秒降到80毫秒,老系统的连接压力也控制在合理范围。更重要的是,Agent终于能在缺陷发生时,立刻知道当前零件是否允许0.1mm的划痕,从而做出放行或返工的决定。
工厂产线经理给出了一组对比:上线前,人工质检漏检率约6%,且每天50件需要二次返工;上线后,Agent将漏检率压到0.7%,误检率也低于2%。这个数字与《一份宁波工厂的账本,把“人工智能+”逼回了车间地板》中提到的“通专融合方案误检率2.1%”非常接近。
但中间件本身也变成了新的维护节点。数据库变更、编码问题、网络抖动……任何一处波动都可能中断Agent的数据流。我们最终将中间件重构为基于EdgeX Foundry的微服务,把设备接入标准化,但那是另一个故事了。
几个教训
- 不要指望老系统开API。适配成本由新系统承担,中间件是最佳选择。
- 编码是隐形炸弹。在处理中文字段前,先确认老系统实际使用的编码,而不是相信文档。
- 别让Agent直接联数据库。即使有JDBC驱动,也应通过中间件做一层缓存和连接管理。
- 测试要带“真实脏数据”。老数据库里常有无值、特殊字符、超长字段,开发环境无法模拟。
回到开头的问题:工厂里的质检Agent怎么跟老旧ERP系统对话?答案是:靠一层丑但能用的胶水代码。秀模型是第一步,真正的工程在那些看不见的协议转换和异常处理里。如果你也在算类似的技术账,可以参考我们之前写的《昇腾910D之前,先算清CUDA迁移账》和《本地部署Sora 3开源平替》——跨系统集成的底层逻辑是相通的。