架构师发来警告,单靠堆Token已经带不动业务线了
上周三下午,某头部物流企业的IT总监把一份长达40页的月度算力账单甩在了我的桌上。2026年6月,他们的API调用成本环比激增了320%,而业务转化率却持平。这不是个例。就在几天前,微软正式收回了对内部员工开放的Claude Code许可,转而引导员工使用自家的Copilot CLI。理由很直白:仅仅半年,Token消耗量让成本失控,但产出质量并未匹配这种指数级的资源投入 [1]。
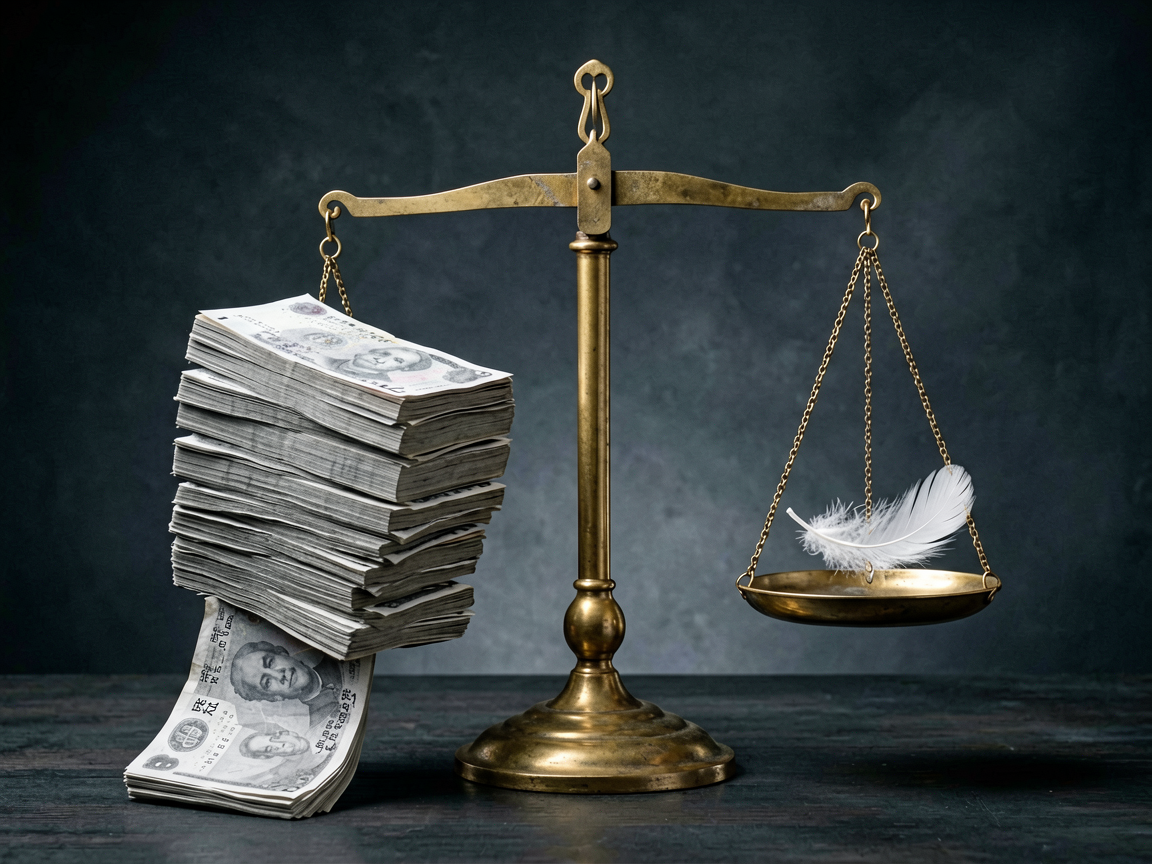
这标志着AI商业化进入了一个残酷的转折点。过去两年,我们迷信“更长上下文=更强智能”,但现在的现实是,Token不经济正在反噬企业的利润表 [2]。
为什么便宜的Token变得更贵了?
直觉上,2023年初每百万Token 30美元的定价,如今已跌至0.1到0.25美元,降幅超过90%。按理说,AI账单应该缩水。但事实恰恰相反 [3]。
矛盾的根源在于两股力量的错位。一方面,巨头们正在重新调整定价策略。2026年2月至6月间,OpenAI发布的GPT-5.5直接将Token价格翻倍,输入端达到每百万5美元,输出端更是高达30美元 [4]。另一方面,企业内部的AI使用场景发生了质变。不再是简单的问答,而是多智能体(Multi-Agent)的复杂协作。每一次任务分解、每一次工具调用、每一次记忆检索,都在成倍地消耗Token。正如Digitimes分析指出的,“在哪裡推论、用什麼规模推论”已从技术选项变为经营决策 [3]。
对于架构师而言,最大的误区在于试图通过增加上下文窗口来解决所有问题。当你在Prompt里塞入几百页的历史文档,模型确实能“看见”更多信息,但它也需要付出巨大的计算代价。更糟糕的是,冗长的上下文往往引入噪音,导致模型幻觉率上升,进而引发更多的重试和返工。
三个失败案例:当Token变成黑洞
案例一:Uber的“预算爆炸”
据Huxiu报道,Uber在2026年仅用了4个月,就耗尽了全年的AI编程工具预算 [2]。工程师们热衷于让AI生成代码,但由于缺乏严格的质量门禁,生成的代码充满了边缘逻辑错误。架构师起初认为这是模型能力不足,于是不断更换更贵的模型、增加Token配额。结果,Token消耗像无底洞,而代码缺陷密度并未显著下降。最终,他们被迫引入了类似《Agent误操作导致资金损失?》中提到的“安全刹车”机制,在代码生成前增加静态分析和逻辑校验层,才止住了出血点 [5]。
案例二:亚马逊内部的“Tokenmaxxing”排行榜
Meta悄悄撤下了内部员工的Token消耗排行榜,因为数据显示大量Token被浪费在无意义的闲聊和无效查询中 [2]。亚马逊的部分团队也曾陷入类似的陷阱:为了追求所谓的“全知全能”助手,将企业内部所有数据库的Schema直接注入Prompt。这不仅拖慢了响应速度,更导致每次调用的Token成本呈几何级增长。后来,他们转向了基于LangGraph的状态机管理,只将当前任务所需的碎片化信息送入模型,成本瞬间下降了60% [6]。
案例三:某金融机构的“长文本幻觉”
一家银行试图用GPT-5.5处理复杂的合规审查,将整年的监管文件作为Context输入。虽然模型记住了每一条细则,但在具体案例判断上,由于上下文过长导致的注意力分散,出现了多次“张冠李戴”的错误。更致命的是,人工复核这些错误的时间成本,远超Token本身的费用。这印证了《AI成本痛点不在于Token,而在于返工》的观点:底层技术栈未理顺时,低成本模型也可能带来高昂的综合成本 [7]。
从“拼参数”到“拼流程”的组织阵痛
面对这种局面,企业架构正在发生静默的重构。2026年的AI落地,不再是谁家的模型参数更大,而是谁的编排流程更高效。
首先,混合架构成为标配。正如《拒绝重复造轮子》中所对比的,Dify、Coze Studio与LangGraph等工具正帮助企业摆脱单体架构的束缚 [6]。通过3B的小模型进行初步的路由分发,判断用户意图是简单查询还是复杂任务,再由大模型介入核心推理。这种“小模型前置过滤”的策略,能有效拦截掉大量无效的Token消耗。
其次,记忆的分层管理至关重要。《Agent重启后还能接着干》一文指出,上下文窗口负责眼前,状态机保存进度,向量库承接知识,三者必须严格隔离 [8]。许多失败的案例正是混淆了这三者,导致无关的历史对话干扰了当前任务的执行。
最后,FinOps治理成为刚需。《2026年企业部署AI Agent的成本控制》提供了一套实操方案:通过MCP协议对工具调用进行审计,实时监控每个Agent的生命周期 [9]。一旦检测到异常的高频调用或死循环,立即切断连接。这不仅是技术问题,更是财务合规问题。
结语
Token账单的失控,本质上是企业AI战略从“玩具阶段”迈向“生产阶段”的阵痛。单纯堆砌Token不仅带不动业务线,反而会成为财务的黑洞。未来的赢家,属于那些懂得在模型之外,精心设计工作流、严格管控记忆边界、并将AI成本纳入精细化财务管理的架构师们。
如果你正在为日益增长的API费用头疼,或许该停下来看看,你的AI是在帮你干活,还是在替你烧钱?
参考链接:
- [1] https://www.huxiu.com/article/4871362.html
- [2] https://www.epochtimes.com/gb/26/6/11/n14786728.htm
- [3] https://www.digitimes.com.tw/col/article?id=17480
- [4] https://finance.cnr.cn/ycbd/20260516/t20260516_527622708.shtml
- [5] https://www.aijiyuan.com/articles/agent-risk-audit
- [6] https://www.aijiyuan.com/articles/agent-orchestration-tools
- [7] https://www.aijiyuan.com/articles/agent-cost-control
- [8] https://www.aijiyuan.com/articles/agent-memory-layering
- [9] https://www.aijiyuan.com/articles/ai-finops-practice