2026年7月中旬,618大促已经结束。下午2点的上海,室外体感接近32℃。
我分别打开淘宝和京东的AI导购入口,输入同一句话:
我要去海边度假,需要防晒且透气的穿搭。
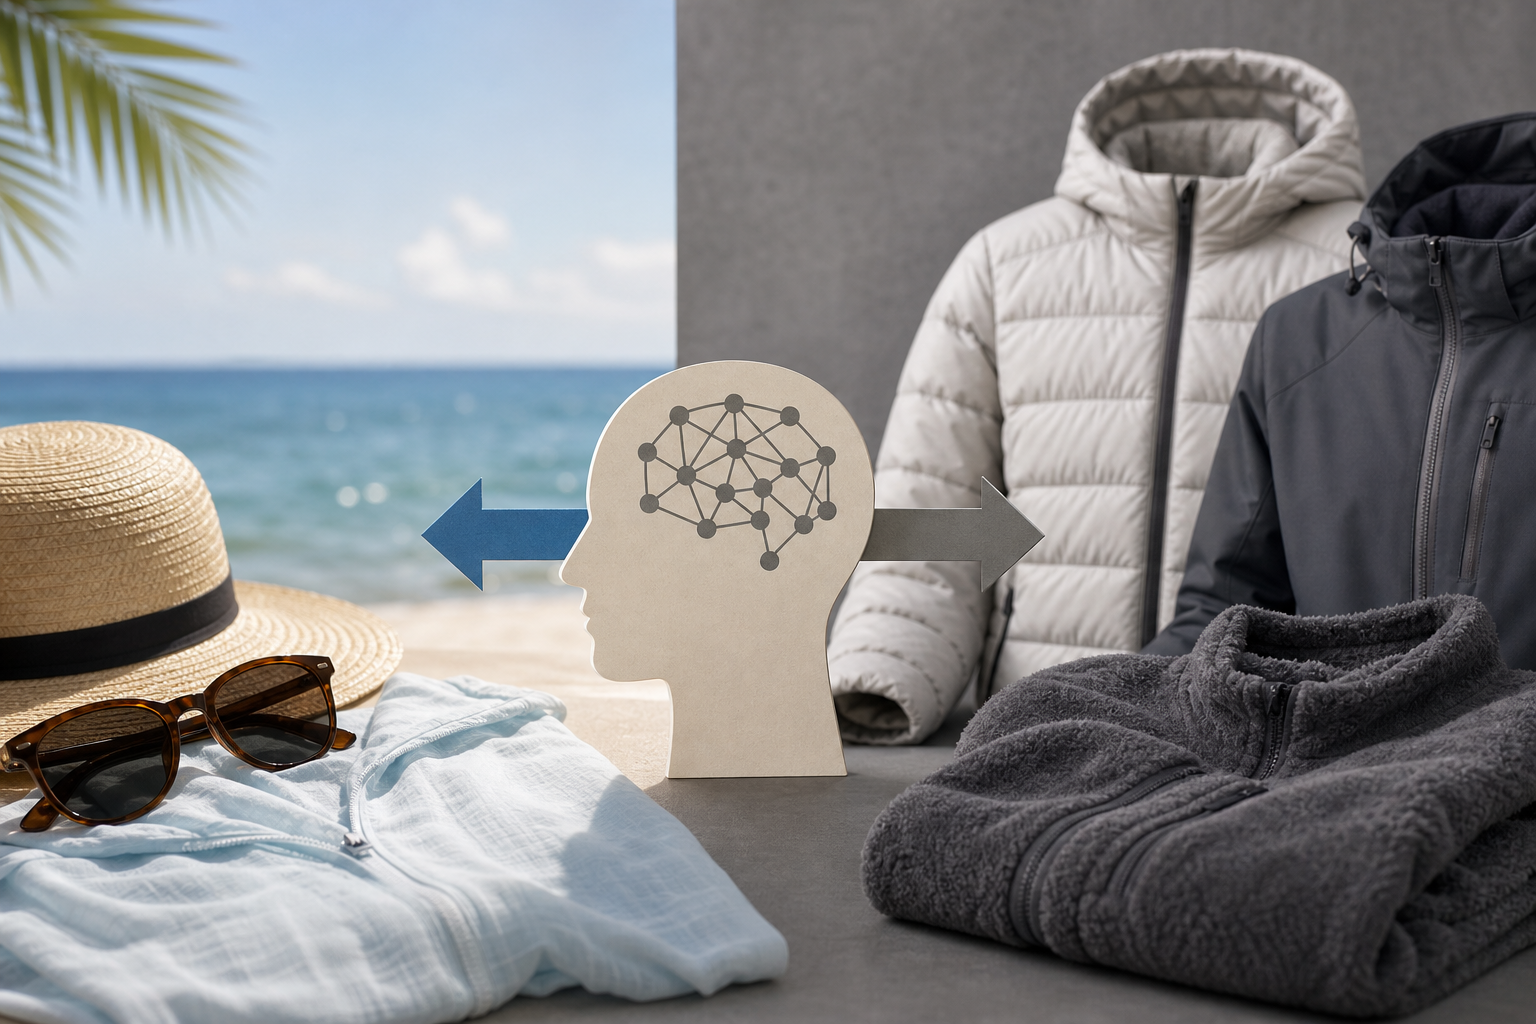
两边返回的前三条推荐里,都出现了厚实的羽绒服和抓绒冲锋衣。我又补了一句“现在是夏天”,助手仍围绕“防风保暖”解释推荐理由。话说得很顺,衣服却完全不对季节。
这只是一次前台测试,不能代表两个平台的全部结果,也看不到后台日志。不过,错误已经足够具体:海边、夏季、透气没有成为真正的筛选门槛。羽绒服进入前三条后,再流畅的解释也救不回这次推荐。
一句“防晒”,把推荐带偏了
2026年5月6日,新华网在《从“人找衣”到“衣懂人”,AI正在改写你的衣橱》中写到,25岁的林女士给一件米色西装拍照,再问豆包参加重要会议该怎么穿。照片、衣服和场合放在一起判断,是穿搭助手吸引人的地方。
那篇报道里的助手有照片可看。我的测试只输入了文字,所以把这次错误直接归为“多模态识别看错面料”并不严谨。现有结果能说明的是:系统没有同时执行季节、场景和透气要求。
从回复倒推,一种可能是“防晒”被扩成了“户外防护”。如果商品标题里的“户外”“探险”“全天候”等词排得更靠前,冲锋衣就可能先进入候选列表,回答模块再沿着这些商品生成“防风保暖”的理由。这一推测符合现象,却不是平台公开的技术结论。
系统也未必拿得到上海定位和实时气温,不能指望它凭空知道32℃。但在我明确补充“现在是夏天”之后,冬装仍没有被排除,这才是更扎眼的地方。
RAG、Qwen3、MiCo,解释不了一次前台测试
把错误归到简化RAG、长上下文的Token成本,或拿Qwen3接企业知识库、MiCo多模态框架作类比,听上去专业,证据却不够。淘宝和京东没有在这次对话中公开具体链路。一次推荐结果无法告诉我们问题出在商品标签、候选召回、排序,还是最后的回答生成。
羽绒服是否因为历史热销、高客单价或退货率进入前列,同样无从确认。用户真正能检查的只有结果:输入已经包含夏季、海边和透气,候选商品就该先排除羽绒、抓绒和加绒款。商品页没有面料或适用季节时,助手应直接标注“无法确认”,别用一段完整回答把信息缺口盖过去。
把提问写成一张筛选单
平台改好之前,可以把提示词写得更像电商筛选器:
当前约32℃,去海边度假。只推荐夏季防晒穿搭,要求轻薄、透气;排除羽绒、抓绒、加绒和保暖型冲锋衣。优先查看亚麻、真丝或速干涤纶。逐件列出商品页标明的面料成分、适用季节和推荐理由;页面没写的项目请标注“无法确认”。
这段话把保留项和排除项放在一起,系统更难只抓住“防晒”两个字自由发挥。
还可以加上“厚度不超过0.5cm、透气性A级以上”,但先确认商品详情确实提供这些字段。页面没有数据时,要求越精确,回答越容易只剩表面上的精确。
拿到推荐后,再追问一次:
为什么没有推荐这件短袖T恤?请逐条列出排除理由,并引用商品页信息;不能确认就明确说明。
这一步不会让模型突然变聪明,却能更早暴露它的判断缺口。
穿搭助手最容易制造的错觉,是回答完整就等于理解了场景。接近32℃、海边、透气,本来都是很直接的条件。系统若还递来羽绒服,先修筛选,别忙着润色文案。等它能稳定排除明显不合时宜的商品,“衣懂人”才算落到日常使用里。
资料来源
- 新华网,2026年5月6日:《从“人找衣”到“衣懂人”,AI正在改写你的衣橱》