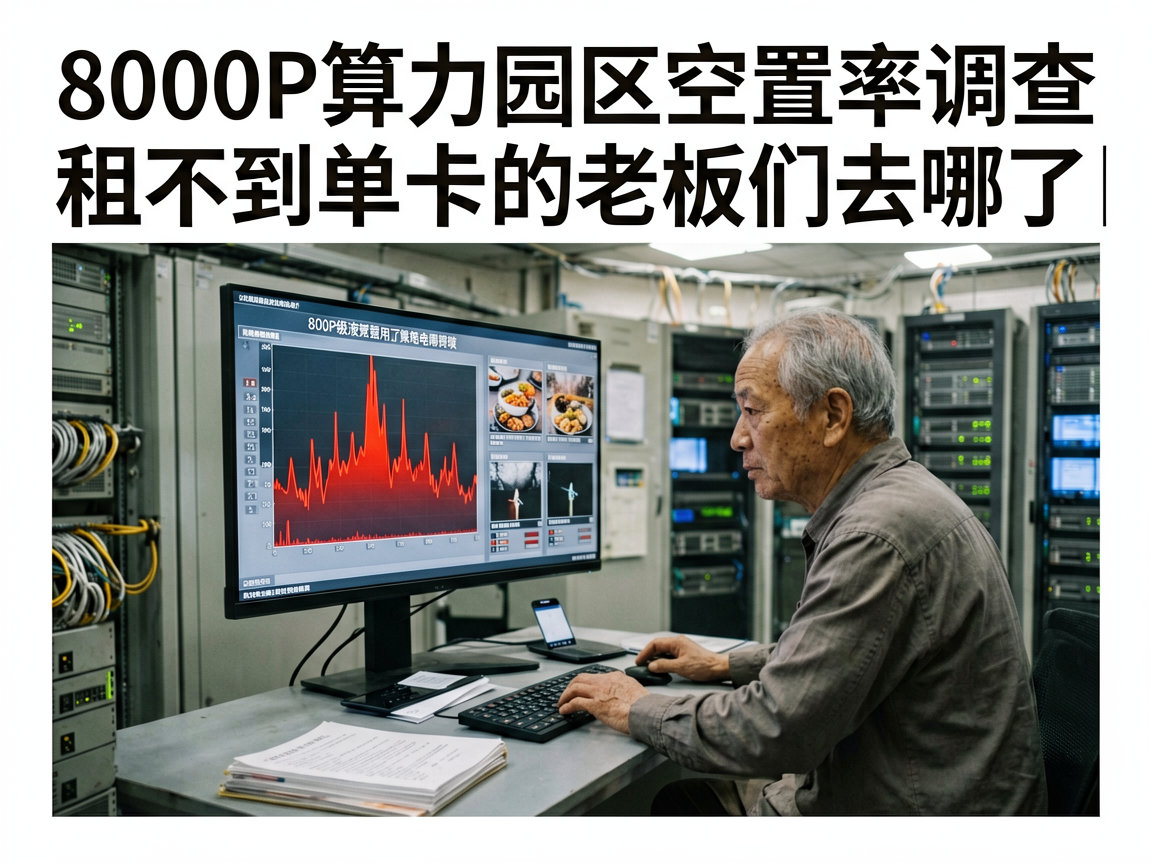
凌晨两点,华东某8000P级液冷算力园区的配电室里,运维老陈盯着监控屏上的红色峰值曲线,长舒了一口气。
就在十分钟前,一批原本处于“休眠”状态的集群被唤醒。这不是因为有了突发的大模型训练需求,而是因为当地电网刚刚切换到了低谷电价时段。这套被称为“间歇性调度”的方案,成了目前这些庞大智算中心填补空置期的唯一救命稻草。
这是一个极具撕裂感的夏天。一边是GPT-5、Sora 3等新一代多模态模型对千卡、万卡集群的吞噬,导致高端单卡算力一“卡”难求,中小创业者在各大租赁平台上排队数月;另一边,据财联社2025年9月的一线调研显示,部分已建成的智算中心实际利用率仍徘徊在40%以下,甚至有早期盲目上马的项目利用率仅三成,大量算力在“沉睡”。
被挤出的中小开发者
对于很多做Agent(智能体)或垂直行业应用的中小团队来说,8000P园区的门槛不仅是钱,还有“包租”模式带来的沉没成本。
2026年初,随着“AGI四杰”在上海AI实验室提出的“通专融合”范式逐渐落地,行业风向变了。智谱、月之暗面等头部玩家的注意力,全部集中在万亿参数模型的基座迭代上。正如我们在《WAIC后冷思考》中分析的,中型企业开始放弃购买昂贵的万亿大模型API,转而寻求百亿级垂直微调方案。但对于更底层的初创者,连微调的算力都成了奢望。
“以前租一张A100能跑通Demo,现在园区只接整柜订单。”杭州一家做跨境电商AI选品的创始人林萧无奈地表示。他的团队每月需要处理数万张商品图的生成任务,对延迟敏感,但对显存连续性要求不高。然而,8000P级别的集群为了追求极致互联效率,通常采用全互联拓扑,拆单租赁不仅价格极高,还面临复杂的算子兼容问题——就像《从910B迁移到910C》里提到的那些坑位,跨芯片、跨拓扑的通信开销足以拖垮整个推理链路。
于是,这批老板们去了哪里?
边缘侧的“流浪”
一部分人退守到了端侧。Arm高管在2026年曾明确指出,移动芯片的真正瓶颈不再是TOPS堆叠,而是总线与内存带宽。这促使大量轻量级推理任务向边缘转移。许多中小企业开始采用“云边协同”架构,将耗时的高精度训练留在云端,而将高频、低精度的实时推理下沉到本地服务器甚至高性能PC上。
另一部分人则转向了更灵活的“二手算力市场”。尽管美国商务部在2026年7月升级了出口管制,导致昇腾910D等国产芯片价格波动剧烈(详见《美国AI芯片出口管制升级》),但在国内二手交易圈,大量闲置的上一代GPU被重新打包。这些算力虽然稳定性不如新园区,但对于非生产环境的测试和调试,性价比极高。
园区的生存算术题
对于园区运营方而言,空置是最大的敌人。根据《8000P算力园区实探》中的数据,即便采用先进的冷板式或浸没式液冷技术,PUE做得再低,机柜底座设备在闲置期的结构性能耗黑洞依然惊人。一张高达860万的月度电费单,往往有一半花在维持服务器“待机”状态。
因此,“间歇性调度”应运而生。这种策略本质上是利用电力市场的峰谷差来套利。在白天高峰期,园区优先保障高溢价的头部客户(如大厂基座模型训练);而在深夜低谷期,通过软件层面对算力进行碎片化重组,承接那些对时间不敏感、对价格极度敏感的批处理任务,如数据清洗、长尾场景离线推理、模型量化测试等。
这不仅是为了填满机柜,更是为了摊薄折旧。21经济网报道指出,2026年上半年,润泽科技、中科曙光等头部企业市值狂飙,背后正是这种精细化运营能力的体现。资本市场不再相信“跑马圈地”的故事,而是看重每一瓦电力的产出效率。
产能过剩还是结构性短缺?
表面上看,是产能过剩。工信部数据显示,通用算力相对过剩,智能算力相对短缺。但这其实是一种错配。8000P园区提供的,是高度标准化、同质化的“裸金属”算力。而市场真正需要的,是能够解决长尾场景、具备软硬一体优化能力的“服务化”算力。
当《人工智能+》进入深水区,单纯靠堆砌显卡无法解决业务痛点。那些试图用大模型直接取代整个部门的尝试,往往因为模型能力与业务流程脱节而遭遇效率反弹(见《‘人工智能+’进入深水区》)。相反,那些能够深入企业“毛细血管”,将算力转化为特定行业解决方案的团队,即使在算力紧张的环境下,也能找到稳定的生存空间。
对于中小开发者而言,未来的出路或许不在于争抢那稀缺的单卡,而在于如何更聪明地使用算力。是通过微调降低参数量?是利用端侧带宽优化推理效率?还是通过分布式架构规避单点故障?
在GPT-5和Sora 3构筑的高墙之下,算力租赁不再是简单的“租机器”,而是一场关于架构设计与成本控制的综合博弈。园区里的灯光在深夜亮起,那些被“间歇性调度”唤醒的服务器,正默默消化着这个时代溢出的算力焦虑。而对于租不到卡的老板们来说,真正的战场,早已不在机房,而在代码与业务的缝隙之间。