单卡每小时4.2元——这是北京8000P算力园区给首批入驻企业的GPU租用单价。
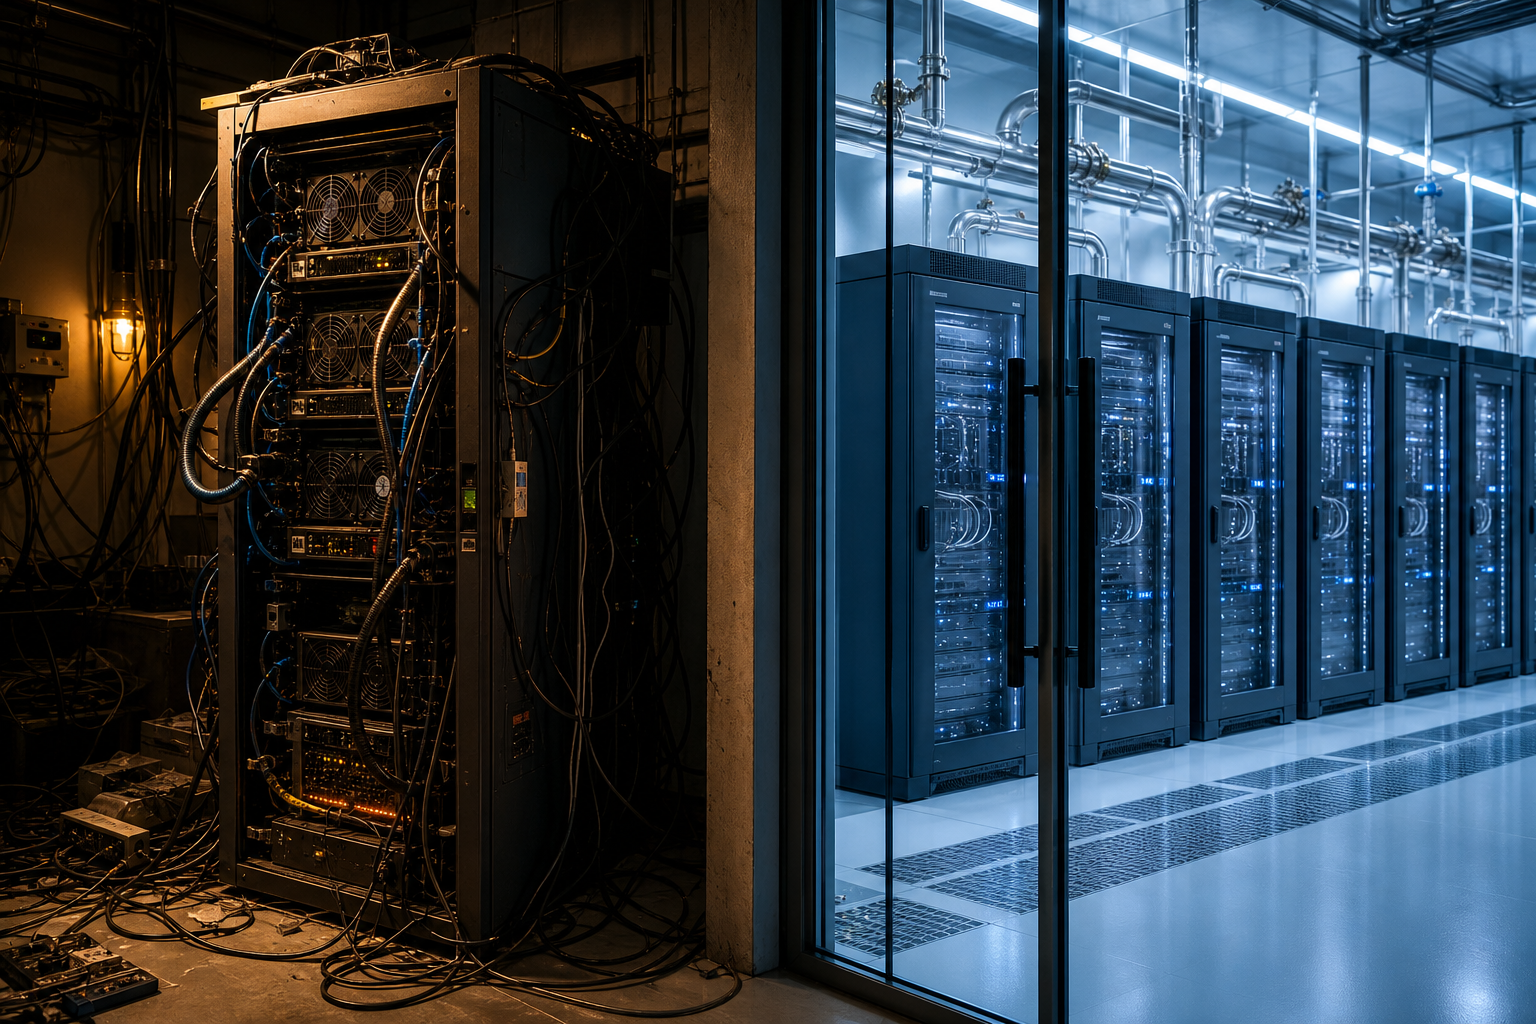
对比去年某家视频生成公司自建机房的成本:NVIDIA H800单卡每小时约42元(电费、散热、运维摊销后)。补贴后的园区价格,让这家公司果断关掉了自己的小机房,把所有训练负载搬进了中关村科学城北区这栋灰白色建筑里。
一个月下来,他们光显卡租金就从63万降到6.3万。算上存储和网络,总算力账单从月均82万缩到9.8万。
这不是孤例。据《21世纪经济报道》2026年1月报道,北京市已明确“全面实施人工智能+行动,建设国家人工智能应用中试基地”。这座8000P园区正是中试基地的核心算力节点。新华社在2025年6月的报道中称其为“打造通用人工智能(AGI)策源地”。一年过去,入驻企业从最初的5家扩张到17家,涵盖大模型、具身智能、AI Agent、视频生成四个方向。
我们拿到了其中3家企业的上云前后账本,拆开来看补贴到底补在哪儿,以及那些没写在政策文件里的隐性成本。
账本一:补贴怎么把单卡成本打到4.2元
先看明账。园区运营方(某国资平台)对入驻企业实行阶梯补贴:
- 算力券:前6个月算力费用补贴50%,之后按训练量梯度削减。
- 空间租金:前三年免租(含机房空间,不含电费)。
- 网络带宽:按需分配,月费封顶2万元(市价同等带宽约8万)。
以一家做法律大模型的创业公司为例:他们需要长期占用512张昇腾910C卡训练基座模型。
自建机房对比:
- 服务器采购(512卡×4.8万/卡):245.76万元(一次性)
- 机柜、电力改造、液冷系统:180万元(一次性)
- 月均电费:约32万元(单卡功耗310W,含制冷)
- 运维工程师:2人 x 4万/月 = 8万元
- GPU折旧(按3年直线):6.83万元/月
- 月均实际使用成本:约46.8万元
入园后:
- 算力租用:512卡×4.2元/小时×720小时(满负荷)≈ 15.48万元/月
- 补贴后前6个月实付:7.74万元/月
- 机房免租,电费含在算力单价里(园区统一供液冷,能效比1.1,已分摊)
- 网络带宽:封顶2万元/月
- 运维:园区提供基础运维,企业只需1人做调度监控,成本2万/月
- 月均实际支出(前6个月):7.74+2+2 = 11.74万元
结论:前6个月月省35万元,约75%的成本削减。 6个月后补贴减半,月成本升至约20万,仍比自建低57%。
不过该企业CTO透露:“我们原本计划用NVIDIA H100,但园区只部署了昇腾910C。虽然买了昇腾适配服务,前两周还是碰到了算子缺失和通信卡死——和《昇腾910C集群微调实录》里写的一模一样。”
账本二:视频生成企业最怕的“隐性成本”
第二家是某视频生成模型公司(旗下产品曾登顶国内榜单,参考《豆包视频模型登顶国内榜单之后,影视公司怎么用它剪院线预告片》)。他们入驻后主要跑文生视频长序列训练,每批任务用1024张卡,训练周期约两周。
明面省下的钱:
- 此前用公有云GPU:按需价约15元/小时/卡,1024卡跑两周(336小时)≈ 516万元
- 园区补贴后定价:6元/小时/卡(比4.2元高,因为视频训练对显存和带宽要求更高),实付约206万元
- 单次训练节省310万元,约60%
但隐性成本冒出来了:
- 液冷故障:2026年5月园区因冷媒切换导致单批次掉卡,1024卡中有37卡温度超标自动降频,训练中断后重新Checkpoint恢复,浪费约11小时。参考《昇腾 910C 万卡集群的液冷巡检:哪些信号需要提前 30 天报警》,这类问题可以通过提前30天监测冷媒离子浓度来规避。园区尚未部署该监控体系。
- 网络拥塞:多企业同时提交大任务时,HCCL通信出现抖动,一次训练因AllReduce timeout失败。运维排查发现是AI计算网络与存储网络共享同一张HCA卡导致,后来通过MPI参数调整和独立网段解决。
- 版本兼容:某次CANN版本更新后,视频模型中的FlashAttention算子编译失败,回滚到上一版本才恢复,耽误2天。
这家公司的AI训练负责人算了一笔账:“隐性成本折算到每次训练大约多花8-10万元(微调+时间折算)。但相比公有云,还是省了300万。只要园区把液冷监测和网络QoS做好,我们愿意签长期合同。”
账本三:Agent公司的“FinOps”账单局
第三家是做企业级AI Agent平台的。他们的业务不是训练基础模型,而是大量调用大模型API做编排推理。入驻园区后,他们租了100台推理服务器(昇腾310B),部署几十个客户Agent。
明面变化:
- 推理卡月租:单卡600元/月(含电),100台×8卡×600元 = 48万元/月
- 之前用云端推理API:按Token计费,月均约75万元
- 月省27万元,36%
但Agent的账单麻烦在于:自动扩容和循环调用可能把省下的钱吃回去。参考《AI Agent的账单危机:自动续费背后的FinOps治理新解法》,他们为每个客户Agent设置了Token每月上限(5000万Token),并编写了前置过滤规则:先用轻量模型(如7B)判断问题是否需要调用大模型。结果,实际Token使用量仅为预估的45%,客户投诉率反而下降——因为过滤后客户只收到高质量回复。
尽管如此,他们的CTO提到一个尴尬细节:“园区提供的虚拟机镜像里预装了CentOS 7,但我们用的Agent框架依赖GLIBC 2.28以上。自己编译三天才搞定。希望园区能出一个‘Agent环境包’。”
补贴是杠杆,但工程细节决定留存率
综合三家账本可以看出:
明面成本降幅:60%–78%。这直接推动了北京AGI策源地的企业入驻速度。据朝阳区2024-2026年行动计划,到2026年要建设100个以上人工智能应用示范场景,形成3个以上人工智能特色产业园区。8000P园区显然是其中的标杆。
但工程适配成本不低:昇腾生态仍在完善,液冷稳定性、网络配置、软件兼容性都需要企业额外投入人力和时间。好消息是,园区运营方已在2026年Q2公开了《昇腾910C集群的硬件故障排查指南》,并计划在Q3上架自助式算子适配服务——这正是从《昇腾910C集群微调实录》这类实战文章中总结出的需求。
另一个值得注意的方向是电力扩容。8000P满负荷运转时,峰值功耗接近6.4MW。北京2026年夏季电力供应偏紧,园区已配置了两台柴油发电机作为备用,但上个月一次短时电网波动仍导致算力集群降频10%。《万卡集群跑三个月,电力、调度和液冷的真实账本》中提到的“冷媒切换+电力冗余”问题,在这里同样存在。
剩下的问题:生态怎么闭环
园区首批企业趋同于“训练型”和“推理密集型”两类。但AGI策源地的目标是让AI落地到实体场景。我们走访时注意到,园区一楼展示厅里摆着三台人形机器人——和《三台人形机器人进家30天》里描述的那类产品很像。现场测试时,机器人能把咖啡杯端到指定位置,但遇到一个椅子腿就停住了——地图识别没做那个障碍物。
园区CTO告诉我们,他们正在和几家具身智能公司谈入驻,计划在六层划出一块“物理世界验证区”,铺上典型家居环境,让机器人在真实物理条件下跑测试。但《机器人会收拾客厅了,坏了谁修仍没人说清》里的那个问题——故障后维修周期和成本——至今没有公开答案。
这可能就是算力开闸之后,下一个需要拉通的账本。
数据来源:新华网2025年6月报道《8000P算力与空间赋能,这座园区打造通用人工智能策源地》;21世纪经济报道2026年1月《瞄准“全球人工智能第一城”,北京要将AI卷到底》;朝阳区三年行动计划(2024-2026);以及入驻企业匿名访谈。