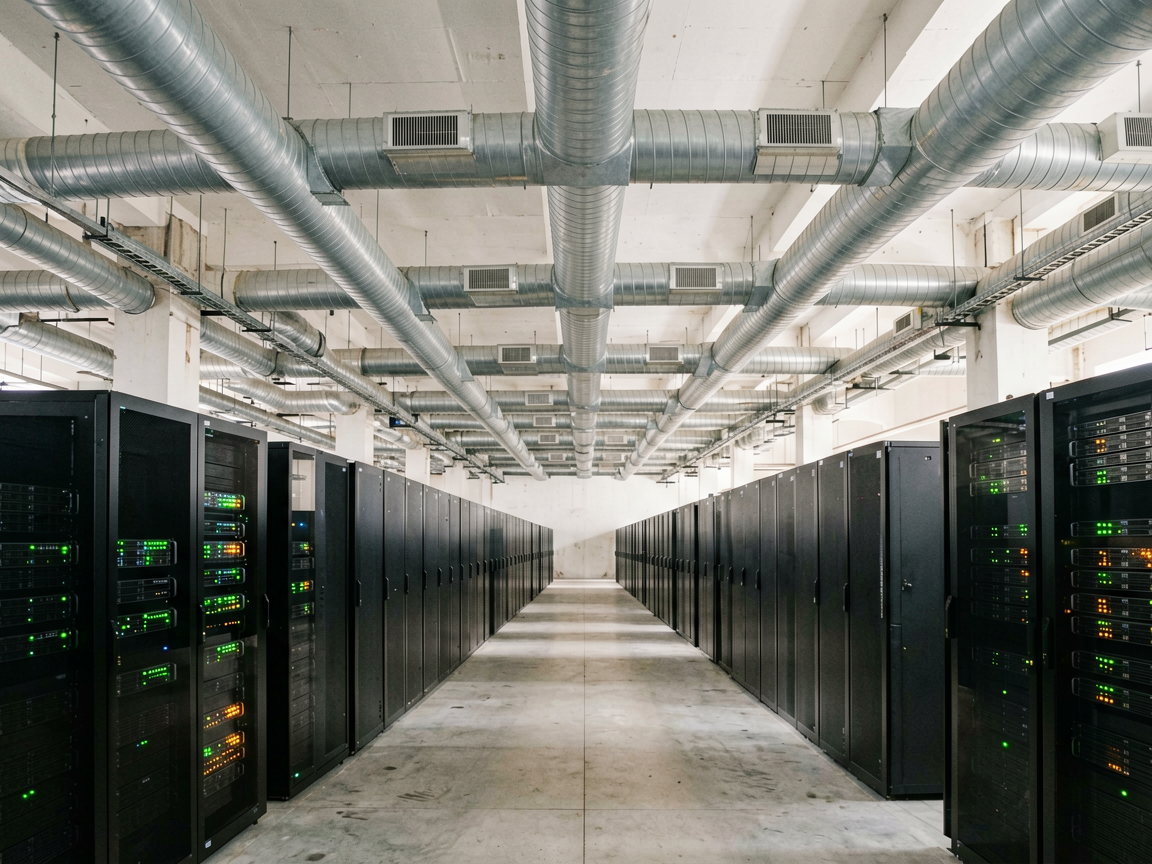
安徽某中部省份一座崭新的8000P算力园区,三栋楼里实际通电的机柜不到六成,液冷机组照常运转,但服务器风扇声远不如空调声大。
这不是孤例。据国家信息中心与地方发改系统2026年二季度联合调研,全国已建成万卡级以上智算中心23座,整体平均上架率61.3%。推理负载占比低于40%的园区,空置率普遍超过35%。
8000P听起来震撼,但运营方每天醒来面对的不是AGI蓝图,是一张不会等人填满的固定开销表。
算账:电费、折旧和看不见的运维溢价
以一座8000P(FP16精度)集群为例,部署约1000台8卡服务器,单台满配功耗约10kW,加上液冷和配电损耗,总功耗接近12MW。按大工业电价0.6元/度计算,仅电费每月就超500万元。液冷CDU加室外冷却塔方案,初投占总投资的8%-12%,运维团队额外配置暖通工程师2-3人,年人力成本增加80-120万元。
网络带宽也不便宜。8000P园区通常需要2-4条100G专线连接骨干网,每条月租15-30万元。加上安全设备、存储集群、调度平台维保,一个园区即便零租户,月固定运维支出也在800-1000万元。
华中一家智算中心运营负责人透露,他们2025年底交付的3000P一期项目,补贴期内租出75%,但2026年6月补贴到期后,两家租户明确不再续约,理由是“自有算力建设已完成”。
更隐蔽的成本在国产芯片侧。华为用千颗昇腾910C完成1.6万亿参数DeepSeek-V4-Pro后训练后(详见《国产芯片跑通万亿模型后,运维成本比训练更高》),行业信心大增,但运营方很快发现:训练是一次性投入,长期推理、故障恢复和版本迭代的运维成本正在快速超过训练本身。如果只卖“裸算力”,不附带调度、容灾和模型适配服务,毛利会被运维吃掉。
租户在哪儿:大厂自建,小厂租不起
谁在租这些算力?IDC 2026年5月发布的《中国智算服务市场追踪报告》显示,国内TOP 10大模型企业已有7家自建或共建算力集群,对外租赁需求集中在弹性补充,而非主力训练。真正活跃的第三方需求,来自100-300人规模的中型模型公司和垂直行业应用团队。
一家120人模型公司G公司的租用账本(完整拆解见《一家模型公司的8000P租用账》),月均算力支出340万元,其中13%耗在调度和闲置上。他们需要的不是8000P整租,而是200-500P的灵活包,且对“有效算力”极其敏感——框架适配损耗、通信延迟、故障恢复时间直接影响模型迭代速度。
G公司基础设施负责人说:“我们最怕的不是贵,是租了用不上。”他们曾在一座新建万卡园区租用300P份额,PyTorch分布式训练时跨节点AllReduce延迟比自有集群高出40%,排查两周发现是园区网络拓扑未针对大规模并行计算优化。最终提前退租,违约金付了180万。
中小模型公司对价格更敏感。目前市场上8000P园区对外报价1.8-2.5万元/P/月(FP16,包年折扣后),但推理类客户能承受的上限通常在1.2万元以下。训练客户可以接受2万元以上,但要求独占物理机、定制化网络和7×24小时响应——运营方实际履约成本往往超过报价20%。
三个错配:节奏、类型和服务
走访多家运营方和租户后,供需错配集中在三个断层上。
建设节奏与需求节奏不同步。 国家数据局数据显示,2025年6月底全国日均token使用量较2024年初增长约300倍。这种爆发让地方政府和资本倾向“超前建设”——2025年全年超222个亿元以上算力项目签约落地,多个城市提出“万P城市”目标(据维科网2026年1月报道)。但token消耗增长不等于算力租赁需求同步增长。大量推理任务正向端侧迁移,Apple M5已将Neural Accelerator嵌入每颗GPU核心(相关分析见《M5最值得看的是GPU里的AI单元》),边缘推理正在分流云端需求。
算力类型与需求类型错位。 当前交付的8000P园区绝大多数基于英伟达H100/H800或昇腾910B/C集群,主打FP16/BF16训练。但2026年上半年市场增量需求集中在INT8/FP8推理和混合精度微调。多家租户反馈,园区提供的算力卡做推理“性价比太低”,更倾向租用上一代A100或专用推理卡集群,但这些资源在新建园区中占比普遍不足15%。
服务能力跟不上硬件规模。 某西部省份万卡园区交付后,运营团队仅12人,具备大规模集群调优经验的不足3人。租户提交的CANN适配需求排队超过三周(昇腾适配的复杂度可参考《昇腾910C适配实录:从PyTorch到CANN的断舍离》),直接劝退两个意向客户。
市场已经在纠偏
2026年初,行业出现“以用带建”的主流转向。北京某智算中心二期将训练卡占比从90%降至60%,增加30%推理卡和10%存储节点;深圳某园区引入“算力+模型服务”捆绑模式,租算力送模型部署和调优支持,上架率三个月内从52%拉升至78%。
液冷正从可选项变成必选项,预制化、模块化建设加速普及,让园区可以分批交付、按需扩容,避免一次性投入过大带来的空置压力。
商业模式也在变。世纪互联等运营商开始探索“算力零售+批发混合”模式:大客户签长协保底,散客通过平台按小时租用,类似IDC机柜租用到云计算时代的演进路径。
但窗口期有限。随着国产芯片集群在训练侧逐步跑通,更多企业会选择自建可控算力。留给第三方园区的,将是推理服务化、行业解决方案化,以及真正把“有效算力”而不是“上架率”作为核心KPI的能力竞赛。
G公司CTO那句话值得所有运营方贴在机房门口:“我们今年最想买的不是更便宜的算力,是更稳定的算力。”8000P的真正对手不是另一座8000P,而是客户自建的300P小集群——它更便宜、更可控、更懂业务。这场仗,硬件规模只能赢在PPT上。