2026年4月起,全球主流云服务商的AI算力定价出现了一个显著的拐点。从AWS的按需实例到阿里云的GPU计算型实例,价格下调幅度在15%到30%之间。对于很多初创公司来说,这意味着运行一个同等规模的推理集群,每月的账单可能减少数万美元。
这种降价在2023-2024年的“算力饥荒”时期是不可想象的。当时,H100等芯片被视为数字黄金,云厂商拥有绝对的定价权。但到了2026年7月,算力定价的逻辑已经从“稀缺性驱动”转向了“成本效率驱动”。
消失的“算力泡沫”与利用率陷阱
降价的首要驱动力是 GPU 利用率的真实回升。在2025年,很多算力园区陷入了一种诡异的局面:硬件全部配齐,但实际运行率极低。正如我们在《Sora激发的需求挤瘫园区:算力配齐后为何运不拉满》中所观察到的,由于视频大模型训练与推理的结构性错配,很多集群在深夜或非高峰期处于空转状态,导致单位算力的摊销成本极高。
但进入2026年Q2,情况发生了变化。一方面是推理框架的工程化突破,例如阿里云在 ecs.ebmgn8v 规格实例上通过 vLLM 和 SGLang 的深度优化,使得 Qwen3-235B-A22B 这种超大规模模型的推理吞吐量提升了近 40%。这意味着同样的硬件能承载更多的并发请求,单次 Token 的成本被摊薄。
另一方面,MoE(混合专家模型)架构的全面普及改变了算力消耗模式。虽然万亿参数模型在显存占用上依然是个挑战(参考《MoE 架构跑通万亿参数了,但显存碎片正在拖垮推理速度》),但其推理时的激活参数量远低于稠密模型。这种“按需激活”的特性,让云厂商能够通过更灵活的调度算法,在同一批 GPU 上揉入更多的小规模任务,将整体利用率从 30%-40% 提升至 60% 以上。
电费单上的“液冷红利”
如果说利用率是软件层面的优化,那么电力成本则是决定降价底线的物理约束。对于任何一个 AI 云服务商,电费是仅次于硬件折旧的第二大开支。
在传统的风冷数据中心,为了压住 H100 或 B200 等高功耗芯片,冷却系统的能耗往往占据总电费的 30% 以上。我们在之前的《8000P算力园区实探:机柜密度、液冷管道和一张看不懂的电费单》中分析过,单月 860 万的电费单中,很大一部分被低效的散热系统吞噬。
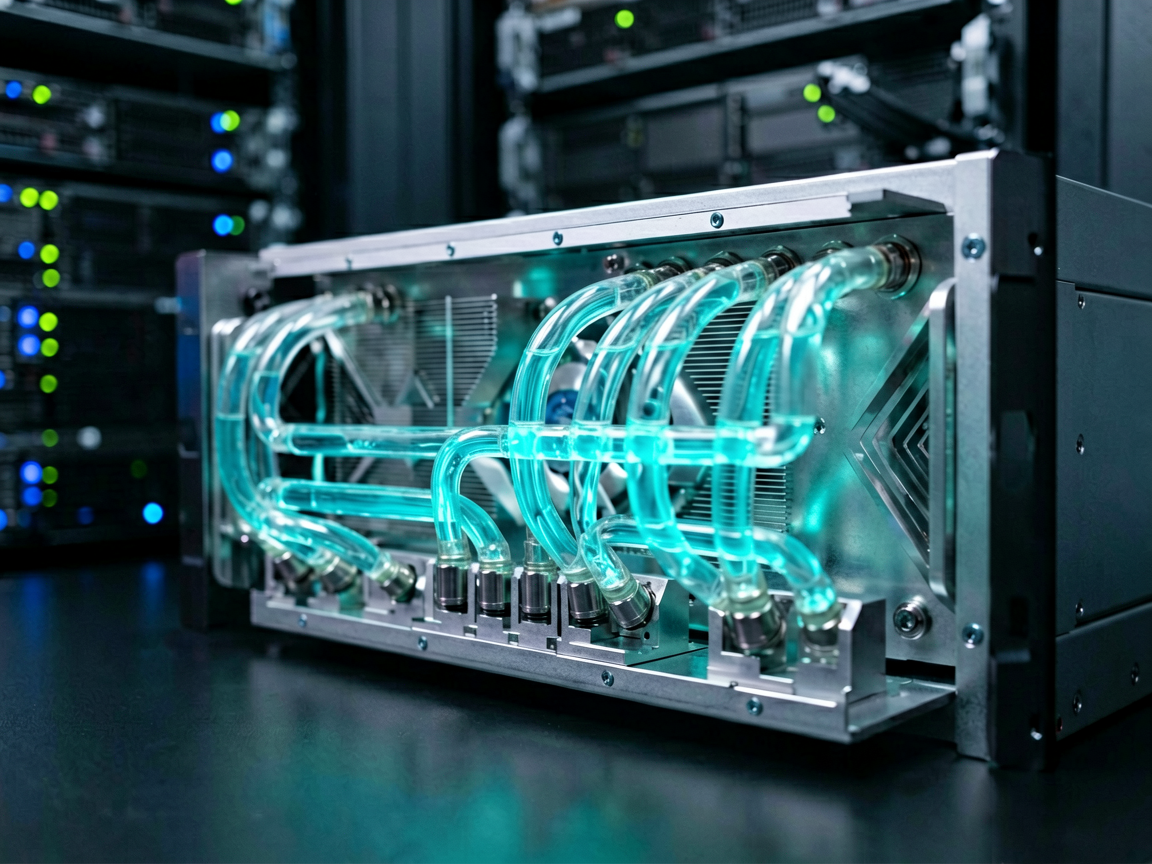
2026 年,冷板式液冷和浸没式液冷在头部数据中心的普及率达到了临界点。液冷技术将 PUE(电源使用效率)从 1.5 左右压低至 1.2 甚至更低。这意味着同样支撑 1000 颗 GPU 运行,电费开支能够直接下降 15%-20%。当这种基础设施的规模效应显现时,云厂商有了更大的空间将成本红利传递给用户,以换取更高的市场份额。
GPU 变成了“石油”:从资产到商品的逻辑切换
一个有趣的现象是,GPU 的价格波动开始呈现出类似大宗商品的特征。据 The Information 报道,GPU 服务器的价格已不再是简单的线性折旧,而是随内存芯片供应和市场需求剧烈波动,就像石油一样。
这种波动迫使云厂商改变商业模式。以 Oracle 为例,其 FY26Q3 的财报显示,OCI(Oracle Cloud Infrastructure)业务收入同比高增 84%,达到了 48.8 亿美元。Oracle 的成功在于它不再仅仅售卖“算力时长”,而是通过 GPUaaS(GPU 即服务)构建了一个高度弹性的租赁市场。当市场需求在低谷时,通过低价吸引长尾开发者;在高峰时,通过预留实例保障大客户。
这种“动态定价”机制在 AWS 和 Azure 中也得到了体现。它们开始引入更复杂的 Spot 实例定价策略,利用那些被闲置的算力碎片,将价格打到极低,从而吸引那些对延迟不敏感的离线训练任务。
企业应该在何时“梭哈”上云?
面对这一轮降价,很多企业在纠结:是现在大规模迁移到云端,还是继续维持私有化部署?
基于目前的成本曲线,我的判断是:推理业务全面上云,训练业务分级部署。
对于推理业务,云端已经具备了绝对的成本优势。依托于最新的推理加速框架和动态调度,云厂商提供的 Token 单价已经低于大多数企业自行维护私有集群的电费+运维成本。尤其是当你的模型需要频繁扩缩容时,云端的弹性是私有化部署无法比拟的。
但对于大规模预训练,逻辑不同。训练任务对带宽和互联延迟的要求极高,且运行时间长。在这种场景下,私有化部署或长期签订的算力租赁协议(Reserved Instances)依然是更稳妥的选择。因为在 2026 年的竞争环境下,云厂商虽然在降低“单价”,但通过 API 绑定的生态锁死(Vendor Lock-in)风险在增加。
算力降价不是因为 AI 需求萎缩,而是因为基础设施终于跟上了算法的进化速度。当 GPU 真正成为一种像水电一样廉价且可获取的资源时,竞争的重心将彻底从“谁有卡”转移到“谁能用这些卡创造出真正的业务价值”。