发动机异响诊断,过去很依赖经验。
维修技师会听怠速、听加速、听冷车和热车状态下的差别;产线检测则更多依赖传感器、阈值和规则。问题也很直接:经验难复制,规则难覆盖,轻微异常又容易被现场噪声盖住。
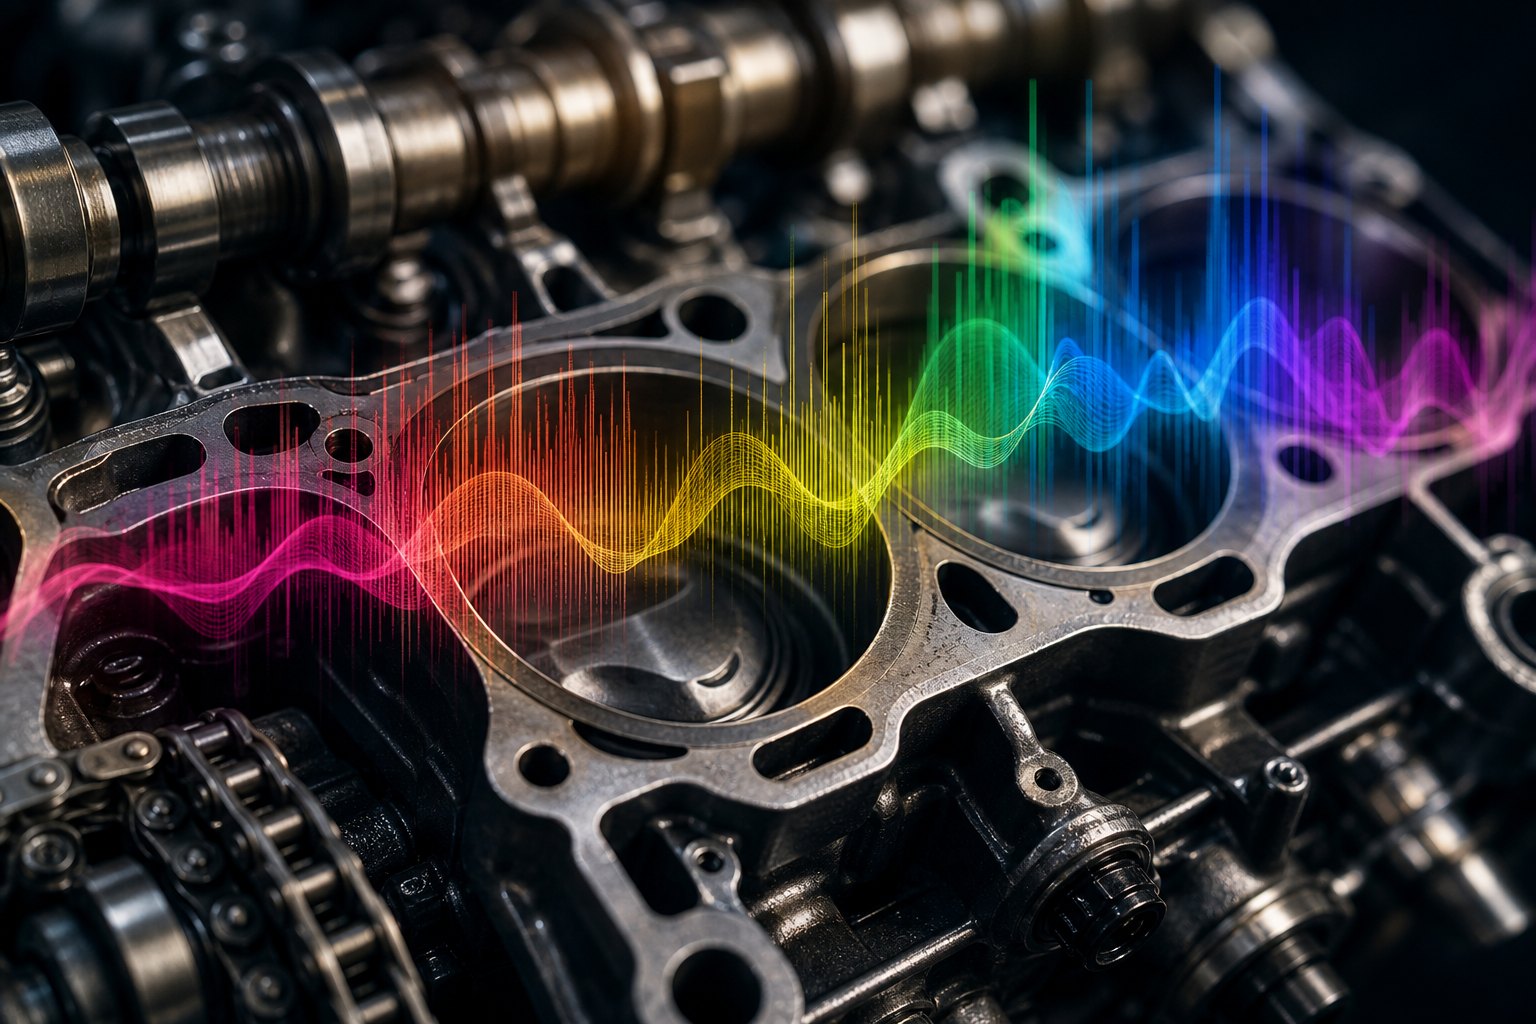
视觉大模型介入这件事,并不是模型真的长出了耳朵。更准确的说法是:把声音信号转成频谱图一类的二维表示,再借用视觉模型擅长的分类、检测、异常识别能力,去判断声音里是否存在故障特征。
这条路听起来绕,但在工业场景里有现实原因。
工业AI这些年积累最多的,不是声纹数据,而是图像数据。缺陷检测、分类、分割,是视觉模型最早落地的一批任务。凌云光在相关资料中提到,其 LusterLVM 大模型已用于工业缺陷检测、分类和分割等场景,并参与了中国电子技术标准化研究院联合35家代表单位编制的《面向智能制造的工业大模型标准化研究报告》。这说明,视觉大模型在工业现场已经有较多可复用经验。
发动机异响如果要直接训练音频模型,首先卡在数据上。不同车型、不同工况、不同零部件老化阶段,声音差异很大。真正高质量的故障声纹数据,采集难,标注也难。《工业大模型技术应用与发展报告1.0》也把“高质量工业数据”放在很重要的位置:硬件和数据会定义大模型能力边界,高质量工业数据是大模型从“能用”到“好用”的有效途径。
所以,把声音视觉化,本质上是一种借力:不是重新造一个完整声学体系,而是尝试复用视觉大模型已有的特征提取能力。
但这不等于马上就能在4S店里稳定使用。
发动机舱不是实验室。风扇声、皮带声、车间背景噪声、不同采集距离,都会影响声音质量。即便频谱图能把音频变成“图像”,模型看到的也可能是一张被噪声污染的图。异响诊断还涉及工况控制:怠速、加速、负载变化下的声音并不一样,采样流程如果不标准,模型判断就容易漂。
工业视觉公司现在强调的几个能力,放到声学诊断里同样重要。中科迪宏在介绍 TimesAI 大模型版时提到,工业AI视觉需要极高召回率、高实时性,并且要积累垂直领域数据。汽车维修里的异响诊断也是如此:漏报早期故障会影响维修判断,误报又会增加不必要拆检。
还有部署位置的问题。
《工业大模型技术应用与发展报告1.0》提到,工业领域对推理速度、峰值QPS等需求较大,未来有望向端侧、边缘侧推理发展。报告中还列举了爱芯元智 AX650N 芯片可达 361 FPS 的能力。这个数字不能直接等同于发动机异响诊断速度,但它说明一个方向:工业检测不可能所有数据都传到云端慢慢算,很多判断必须在现场完成。
如果发动机异响诊断要落地,边缘侧设备大概率会成为关键环节。它需要完成声音采集、频谱转换、模型推理和结果展示。对维修场景来说,等待时间不能太长;对产线场景来说,更不能影响节拍。
视觉大模型在工业检测里的成熟经验,确实给这条路线提供了基础。比如,金睛智慧工厂V1.0方案介绍了 CISDigital AI 金睛视觉大模型,并提到其自主构建千万级行业图像数据集;瑞松科技的 RSAI 则是一款集标注、训练、模型调优为一体的工业视觉平台软件,用于复杂缺陷定位、检测、分类等问题,尤其面向多品种、小批量、小样本数据场景。
这些案例都不是发动机异响诊断本身,但它们指向同一个事实:工业视觉大模型的价值,不只在“看图”,还在于把现场复杂问题拆成可标注、可训练、可部署的流程。
发动机异响也需要这样的流程。
先定义故障类别,再统一采集方法;先区分正常声音和异常声音,再逐步细分到零部件层面;先做辅助判断,再谈自动诊断。否则,模型即使给出一个漂亮的置信度,也很难让维修技师真正信服。
更合理的定位,是把它当成技师的辅助工具。
老师傅听到异响,靠的是多年经验形成的模式识别。视觉大模型做频谱识别,本质上也是模式识别。区别在于,AI可以把判断过程数据化,把相似案例、异常区域和置信度展示出来。它能帮助新人少走弯路,也能让疑难故障有一个额外参考。
但最终是否拆检、换件、复测,仍然要由人来决定。车辆历史维修记录、使用环境、驾驶习惯、零部件磨损情况,单靠一段声音很难全部覆盖。
所以,“视觉大模型听发动机”最值得关注的地方,不是噱头里的“听声辨位”,而是工业AI正在从单一视觉任务,走向更复杂的多模态现场判断。声音可以被转成图像,振动、温度、工况数据也可能和图像一起进入模型。
这会让工业检测更接近真实维修和生产现场。
但前提仍然朴素:数据要够好,场景要收窄,部署要稳定,结果要能被一线人员理解。没有这些,视觉大模型再强,也只能停留在演示里。