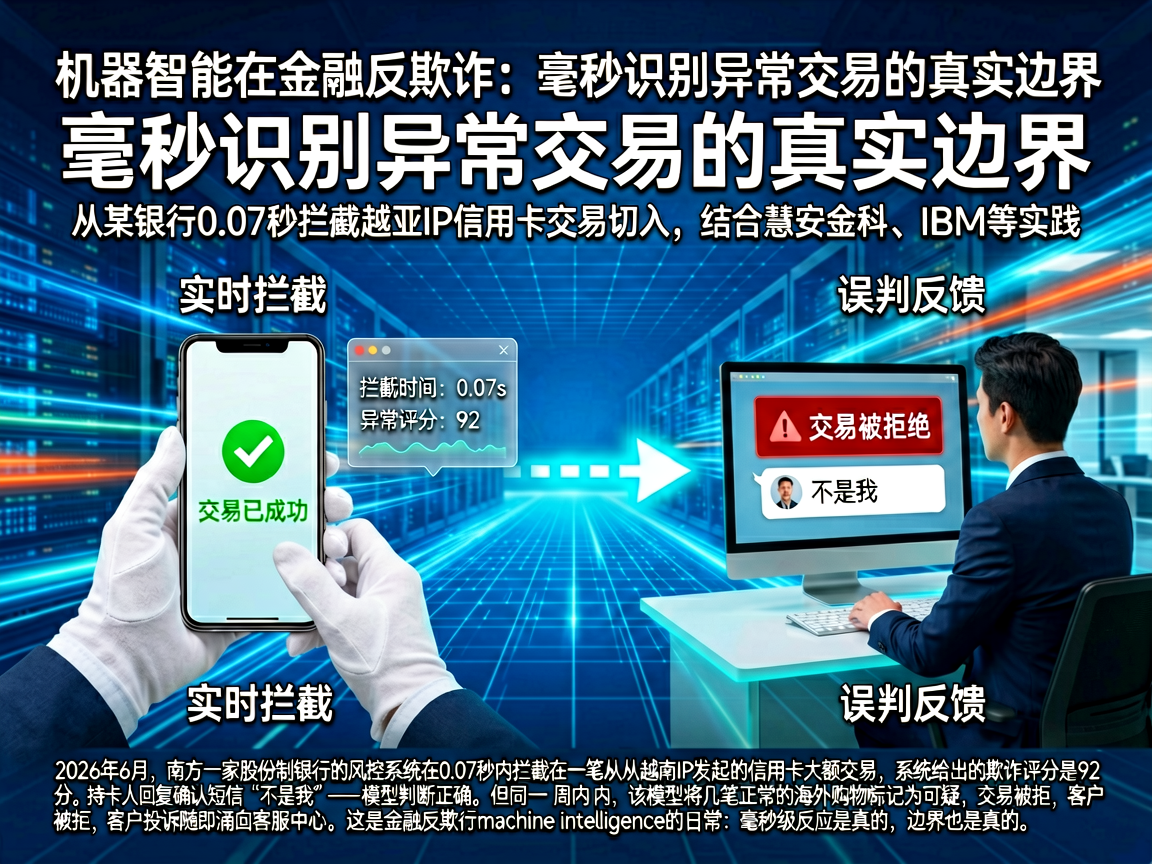
2026年6月,南方一家股份制银行的风控系统在0.07秒内拦截了一笔从越南IP发起的信用卡大额交易,系统给出的欺诈评分是92分。持卡人回复确认短信“不是我”——模型判断正确。但同一周内,该模型将几笔正常的海外购物标记为可疑,交易被拒,客户投诉随即涌向客服中心。
这是金融反欺诈AI的日常:毫秒级反应是真的,边界也是真的。
实时检测的代价:越快的刀越容易误伤
当前银行和支付机构普遍将交易反欺诈的SLA定在100毫秒以内,包括特征工程、模型推理和决策输出。据IBM官网分析文章,AI欺诈检测通过分析大型数据集,学会识别可疑与合法交易之间的区别,甚至可以捕捉人工客服可能遗漏的趋势。但“学会”不等于“完美”。
2026年,主流反欺诈模型已经进化到图神经网络(GNN)与XGBoost的混合架构,能够实时聚合用户社交关系、设备指纹、地理位置等数百个维度。然而,只要模型存在概率输出,就逃不出误判。一家城商行的风控负责人告诉我:他们把假阳性率从0.3%压到0.15%,结果客诉量只降低了40%——因为0.15%乘以日均500万笔,依然意味着7500笔正常交易被误杀。
慧安金科创始人黄铃在一次行业公开课中强调,人工智能在反欺诈和反洗钱中的应用,必须与规则引擎形成“双保险”。纯粹依赖模型,风险阈值稍一放松,欺诈就可能漏过;阈值的一味收紧又会批量误伤良民。
数据隐私:反欺诈的暗礁
模型需要数据,数据却越来越难拿。2026年的中国,数据安全法和个人信息保护法已是常态,欧洲GDPR、美国CCPA持续收紧。信贷申请场景下,用户授权往往是动态的,数据不能跨业务线共享。
国际货币基金组织(IMF)在2023年的一篇专题文章中提到,摩根大通当年发布了3600条AI相关的招聘信息——一场人才争夺战。一年后,银行们发现,光有人才不够,数据获取的合规成本正在赶超模型训练成本。
联邦学习在2025年曾被捧为解药,但实际落地中,各方数据分布差异大,模型收敛慢。某股份制银行的实践中,横向联邦的AUC比集中训练低了近5个百分点,且通信延迟拖慢了模型更新节奏。当欺诈手法以天为单位进化时,周级更新的模型很快过时。
选型建议:先算清账,再选路
企业要避免两个极端:一是把反欺诈全盘交给AI,二是继续靠人工规则死磕。
算法层:优先选择可解释性强的模型(如树模型+线性模型的组合),便于业务人员快速定位误判原因。尝试引入时序模型(如LSTM+Attention)捕捉交易序列的异常模式,但要用蒸馏技术把模型体积压缩,避免推理延迟超标。我们之前谈过算力租金涨价后小规模 AI 公司如何靠模型蒸馏续命,对反欺诈场景同样适用——把千亿参数的行为模型蒸馏到300MB以内,可以部署在交易网关旁,延迟从120毫秒降至35毫秒。
工程层:特征计算尽量流式化,避免使用离线特征。国产芯片适配也是现实问题,很多银行已经启动信创改造。如果反欺诈模型要跑在昇腾910D上,算子调优不能靠手写。Auto-Kernel方案可以帮助自动生成融合算子,将RMSNorm这类操作的延迟从240微秒降到28微秒——在毫秒级场景下,每一微秒都是竞争力。
运营层:建立误判闭环反馈。风控团队需要每天审查被拦截交易的样本,将误报数据重新喂入模型做增量训练。这要求数据管道是实时的,模型可以热更新。当模型不确定时,可以借助状态机逻辑将决策转给人工,避免死循环。
边界在哪里
模型再强,也无法覆盖所有新型欺诈。2026年第一季度,一种利用深度伪造语音的盗刷手段在东南亚流行,多家银行的声纹验证形同虚设。AI反欺诈的对手也在用AI。
短期看,最具性价比的做法是将规则、模型和人工审核串联成一条完整的链路。长期看,行业需要更高质量的数据共享机制。联邦学习、可信执行环境、隐私计算等技术会在2027年进一步成熟,但在此之前,每家机构都得独自面对误判与隐私的两难。
毫秒级识别是现实,但真相在每个交易、每个投诉、每个深夜加班的模型调优时刻。