6月的深圳,气温还没完全上来,一家跨境电商老板的心已经凉透了。618大促前夕,因为一个动态折扣Agent陷入了定价死循环,仅仅4个小时,GitHub Copilot转向Token计费后的账单就烧掉了52万元。这不是孤例,而是整个行业从“免费午餐”转向“精算时代”的缩影。
这一事件发生在一个极其微妙的时间节点。2026年1月,Arm发布了涵盖20项内容的技术预测,直言不讳地指出:全球计算格局正在发生深刻变革,算力重心正从集中式云架构,向覆盖各类设备、终端及系统的边缘节点转移。而到了6月下旬,苹果在WWDC2026上祭出的底牌,恰好为这一转移提供了最有力的硬件注脚。
稀疏架构:端侧算力的“作弊码”
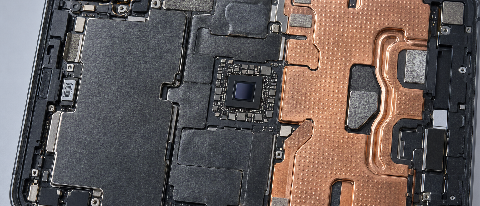
长期以来,端侧运行大模型被视为一种“不可能三角”——性能、功耗和体积很难兼得。但苹果的AFM3系列处理器与同期发布的M5芯片,试图通过硬件级的架构创新打破这个魔咒。
据《21经济网》在6月23日的最新报道,苹果的思路是从根本上设计省算力的结构。他们推出的约200亿参数的端侧主力AFM 3 Core Advanced,并没有盲目堆砌参数,而是引入了稀疏架构(Sparse Architecture)。这意味着,在进行推理时,模型不需要激活全部参数,而是只激活当前任务所需的那部分。这种“按需激活”的逻辑,让iPhone 17 Pro能够在不依赖云端的情况下,流畅运行此前必须借助云端才能处理的复杂任务。
这与Google的Gemini Nano策略异曲同工,后者也是通过从更大规模的Gemini模型蒸馏而来,专注于端侧部署。但苹果的优势在于软硬一体的封闭生态,使得这种稀疏计算能够真正落地到用户手中的设备上,而不是停留在实验室的报告里。
3D堆叠:摩尔定律的“续命丹”
Arm在预测中提到的另一个关键点,是创新依赖3D堆叠而非晶体管微缩。随着半导体物理极限的逼近,单纯依靠缩小晶体管来换取性能提升的路径已经接近尽头。2026年的芯片竞争,实际上是封装技术的竞争。
这种转变在国产算力领域同样明显。回顾去年深圳星图智能从A100迁移至昇腾910D的过程,虽然硬件成本降低了40%,但由于缺乏底层算子的深度定制,性能掉速高达30%。直到今年,随着国产芯片在3D封装和异构计算上的成熟,这种差距才逐渐缩小。正如《智驾进入“造世界”时代:端到端长尾难题的破局》一文所指出的,车企在云端算力成本与国产替代之间做出的抉择,本质上也是对能效比的极致追求。当云端API的调用成本变得不可控时,将算力下沉到端侧,不仅是技术趋势,更是商业生存的必然选择。
从“参数狂欢”到“能效算账”
深圳电商那52万元的亏损,不仅仅是一次运营事故,它暴露了云端API模式在极端情况下的脆弱性。当模型调用变成按Token计费的无底洞时,任何微小的逻辑错误都可能被无限放大。相比之下,本地化部署虽然初期投入较高,但其边际成本几乎为零。这在《Sora 3 进组实测:影视工业的成本账怎么算》中也有所体现,虽然Sora 3大幅缩短了资产准备周期,但Token计费陷阱依然让许多中小制作公司望而却步。
在这种背景下,Arm所预测的“智能计算新时代”不再是一个遥远的愿景,而是正在发生的现实。计算将更趋模块化、高能效,且在云端、物理世界与边缘AI环境间实现无缝互联。对于企业而言,这意味着需要重新审视自己的IT架构。是全量订阅云端服务,还是构建基于端侧NPU的混合架构?
事实上,越来越多的企业已经开始行动。《手淘多模态搜索:20% CTR增长背后的算力账本》中提到,面对搜索复杂度剧增带来的算力成本飙升,混合检索与端侧AI已成为降本增效的新解法。银行也在通过“RPA抓取+Agent初筛+人工复核”的分层模式,将信贷初审时间从数天缩短至15分钟,同时避免了云端调用的潜在风险。
结论:端侧不是终点,而是起点
2026年的AI战场,已经不再是单纯比拼谁的参数更大、谁的模型更强,而是比拼谁能在有限的能效预算内,提供最高质量的智能体验。苹果的AFM3和M5芯片,只是这场变革的一个缩影。随着Arm所预言的3D堆叠技术和稀疏计算的普及,端侧AI将逐步接管那些高频、低延迟、高隐私要求的场景。
对于开发者和企业来说,现在的任务不是等待云端算力的无限增长,而是学会如何驾驭手中的设备。毕竟,在52万元的账单面前,任何关于“云端万能”的幻想,都显得过于奢侈。正如《库克的最后一场WWDC:端侧算力与云端的博弈》中所暗示的,这场隐私与算力的保卫战,终将取决于谁能更好地平衡效率与安全,以及成本与体验。
未来的AI,不在遥远的服务器机房,而在你口袋里的手机中,在你车内的芯片里,甚至在你手腕上的手表上。这才是2026年,AI最真实的模样。