很多4090用户关心一个问题:DeepSeek模型越做越重,双卡还能不能撑住?如果要换到昇腾,值不值?
先把话说窄一点。现有可引用资料里,能明确看到的是DeepSeek系列模型在国产算力上的适配正在推进,包括DeepSeek V2、DeepSeek V3和DeepSeek R1。至于“DeepSeek-R3”和“昇腾910D”的公开、可核验实测数据,目前素材里并没有足够支撑。拿缺来源的延迟、TPS和显存利用率做结论,反而容易误导开发者。
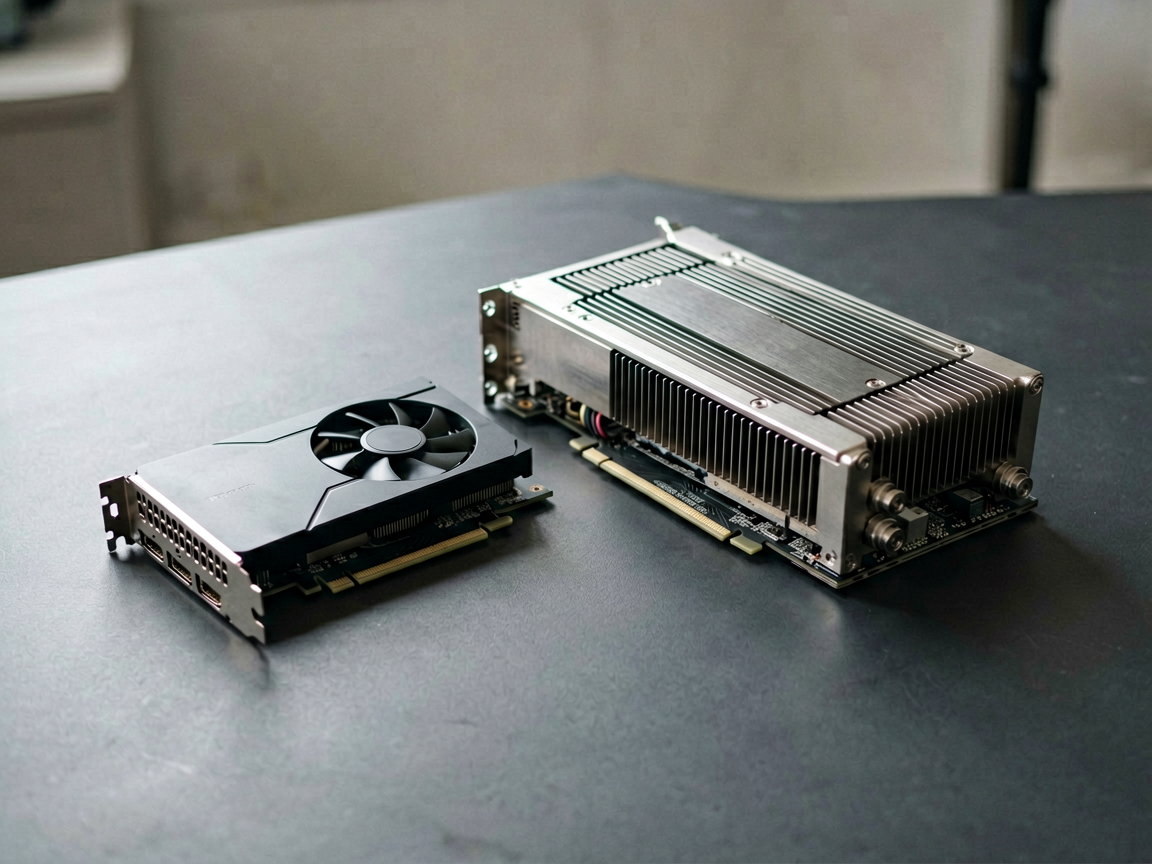
更稳妥的讨论方式,是看已经落地的几件事:DeepSeek模型正在被多家国产芯片厂商适配;昇腾910B、910C已经出现在DeepSeek一体机和高校团队的适配工作中;4090仍然是开发者手里最常见、最顺手的消费级卡之一,但它的显存天花板也很清楚。
4090的问题,不是“不能跑”,而是余量有限
RTX 4090的优势很现实:CUDA和PyTorch路径成熟,社区资料多,报错时大概率能搜到相似问题。个人开发者、小团队做Demo、跑量化模型、调参数,4090仍然是低摩擦选择。
它的短板也同样现实。一张RTX 4090是24GB GDDR6X显存。跑小参数量或量化后的DeepSeek模型,通常还能周转;一旦上下文拉长、并发增加,KV Cache会迅速吃掉显存。问题不一定出在算力峰值,而是显存容量、带宽和调度余量一起顶上来。
所以,4090用户真正需要判断的不是“能不能启动模型”,而是业务场景有没有持续推理、长上下文、多用户并发这些要求。如果只是本地测试,继续优化量化和推理框架更划算;如果要稳定服务线上请求,消费级卡的边界会更早出现。
昇腾这边,能确认的是910B、910C进展
公开资料里,昇腾与DeepSeek的结合已经有不少进展。
Supplyframe四方维的文章提到,华为昇腾、海光、沐曦、天数智芯、摩尔线程、壁仞、燧原、昆仑芯、云天励飞、灵汐科技、鲲云等多家国产芯片厂商,已经宣布完成对DeepSeek系列模型的适配,覆盖从1.5B到70B的多参数版本,用于推理服务部署。
清华大学计算机系计图团队在2025年4月24日发布消息,称团队实现了华为昇腾上DeepSeek模型的适配和高效推理,涉及DeepSeek V2、DeepSeek V3和DeepSeek R1等模型。这个信息比泛泛说“国产算力崛起”更有参考价值,因为它指向了具体团队、具体平台和具体模型。
至于硬件规格,53AI和EET China相关材料都提到,昇腾DeepSeek一体机基于Ascend 910B、910C与DeepSeek大模型结合。53AI材料中还写到:910B采用7nm工艺,FP16算力为280 TFLOPS,INT8算力为140 TOPS;910C进一步优化,FP16约为320 TFLOPS。
这些信息能说明一件事:昇腾路线不是停留在PPT上,至少在910B、910C和DeepSeek V2/V3/R1层面,已有公开适配案例。但它不能直接推出“910D一定比4090更快”,也不能推出“DeepSeek-R3在昇腾上已经全面成熟”。
换到昇腾,省下的不是开发时间
从4090迁到昇腾,最大的变化不在硬件参数,而在开发习惯。
CUDA路径下,很多开发者已经形成固定工作流:PyTorch、Transformers、vLLM、常见量化工具、各类社区补丁。昇腾侧则需要面对CANN、MindSpore,或者基于PyTorch的昇腾适配插件。模型能跑起来是一回事,自定义算子、日志定位、性能调优、线上排障,是另一回事。
这也是企业和个人开发者的分界点。
个人开发者如果只是验证想法,4090的时间成本更低。显存不够时,可以先考虑量化、缩短上下文、降低并发、调整Batch,而不是马上换平台。
中小企业如果已经有稳定推理需求,且模型版本相对固定,可以评估昇腾DeepSeek一体机或昇腾服务器。公开材料里提到的一体机方向,强调的是高性能、低成本、国产化AI算力平台。这个方向适合更重视部署可控性和长期运维的人,但前提是团队愿意投入迁移和调优时间。
大型企业考虑得会更长。它们未必只看单卡性能,而是看供应稳定性、集群运维、模型适配周期和内部工具链。DeepSeek模型在昇腾上的适配进展,给了这类团队一个可评估的入口。
910D和R3,先别急着写进采购理由
原稿把讨论重点放在DeepSeek-R3和昇腾910D上,还引用了2026年实测、TPS、首Token延迟、显存利用率等数据。但在现有素材里,这些关键数据没有对应来源。
这类信息如果出现在选型文章里,会带来两个问题:第一,读者可能把未经验证的数据当成采购依据;第二,一旦实际环境不同,结论很容易失效。LLM推理性能本来就受模型版本、量化方式、上下文长度、Batch Size、框架版本和驱动栈影响,不该只靠几组孤立数字下判断。
更可靠的写法,是把910D和R3暂时放在“待验证”位置:等官方文档、厂商白皮书、开源仓库或第三方测试补齐,再谈对比。现在能讨论的,是4090与昇腾910B/910C路线在迁移成本、软件栈和部署场景上的差异。
怎么选,取决于你要跑什么
如果你是个人开发者,手里已有RTX 4090,优先继续用。它的社区支持、调试便利性和工具完整度,仍然适合快速试错。真正要注意的是24GB显存边界,不要把本地能跑通误认为线上能稳定服务。
如果你是中小团队,DeepSeek模型已经进入业务流程,可以开始做小规模昇腾验证。不要一上来就迁全量服务,先选一个固定模型、固定输入长度、固定并发目标,把推理链路、日志和回滚方案跑通。
如果你是大型企业,昇腾路线值得认真评估。清华计图团队的适配进展、DeepSeek V2/V3/R1在昇腾上的公开案例,以及多家国产芯片厂商对DeepSeek系列模型的适配,都说明这条路已有基础。但采购决策仍应建立在自己业务负载的测试上,而不是用未经来源确认的R3和910D跑分。
4090不是过时选择,昇腾也不是无成本替代。前者胜在顺手,后者胜在国产算力路线和特定部署场景。真正的避坑点很简单:别只看峰值算力,也别被没有来源的实测数字带着走。先确认模型版本、显存需求、并发目标和团队能否承受迁移成本,再谈换卡。