GPT-5在MMLU、GPQA等基准上拿到高分,这一点没什么争议。真正让人皱眉的是另一类场景:题目不难,也不需要专业知识,只要别被语言绕进去。
比如这道老题:
一个农夫有17只羊,除了9只都死了,还剩几只?
正确答案是9只。可在类似题型里,模型有时会顺着“17减9”的直觉往下走,给出8只,再补上一段看起来很完整的解释。问题不只是答错,而是它答错时很像在讲道理。
2025年8月8日,OpenAI发布GPT-5。智源社区在《GPT-5首秀:性能“屠榜”背后的体验分化与治理空窗》中提到,这次发布没有像GPT-4那样带来颠覆性新功能,重点在性能指标的全面领先,同时产品形态和用户体验策略引发了不少分歧。21财经也指出,GPT-5在大模型竞技场上的表现,很可能来自推理能力增强。
这也是我们想测的地方:当题目专门避开知识记忆,只留下语言陷阱和逻辑链条,模型还能不能稳住。
我们怎么出这50道题
这组测试题不是脑筋急转弯合集。每道题都满足三个条件:答案明确且唯一;直觉答案和正确答案不同;不依赖专业知识,只考逻辑链条是否严密。
题型分成六类:
- 否定词嵌套,比如“不是没有人不认为……”;
- 指代歧义,代词到底指向谁;
- 隐含假设,题目里其实没有给出的条件;
- 顺序误导,叙述顺序不等于因果顺序;
- 集合关系,把部分、整体和补集混在一起;
- 反事实推理,尤其是“如果……那么……”里前件为假时怎么处理。
参测模型包括GPT-5、Claude 4、Gemini 3 Pro,以及国产模型Qwen3-235B和DeepSeek-V3。每个模型跑三轮,取多数结果,尽量降低单次采样的偶然性。
我们关注的不是“谁赢了排行榜”,而是模型在什么位置会滑倒,以及它滑倒之后会不会承认地面有坑。
最麻烦的不是错,是错得很顺
一个典型例子是这道题:
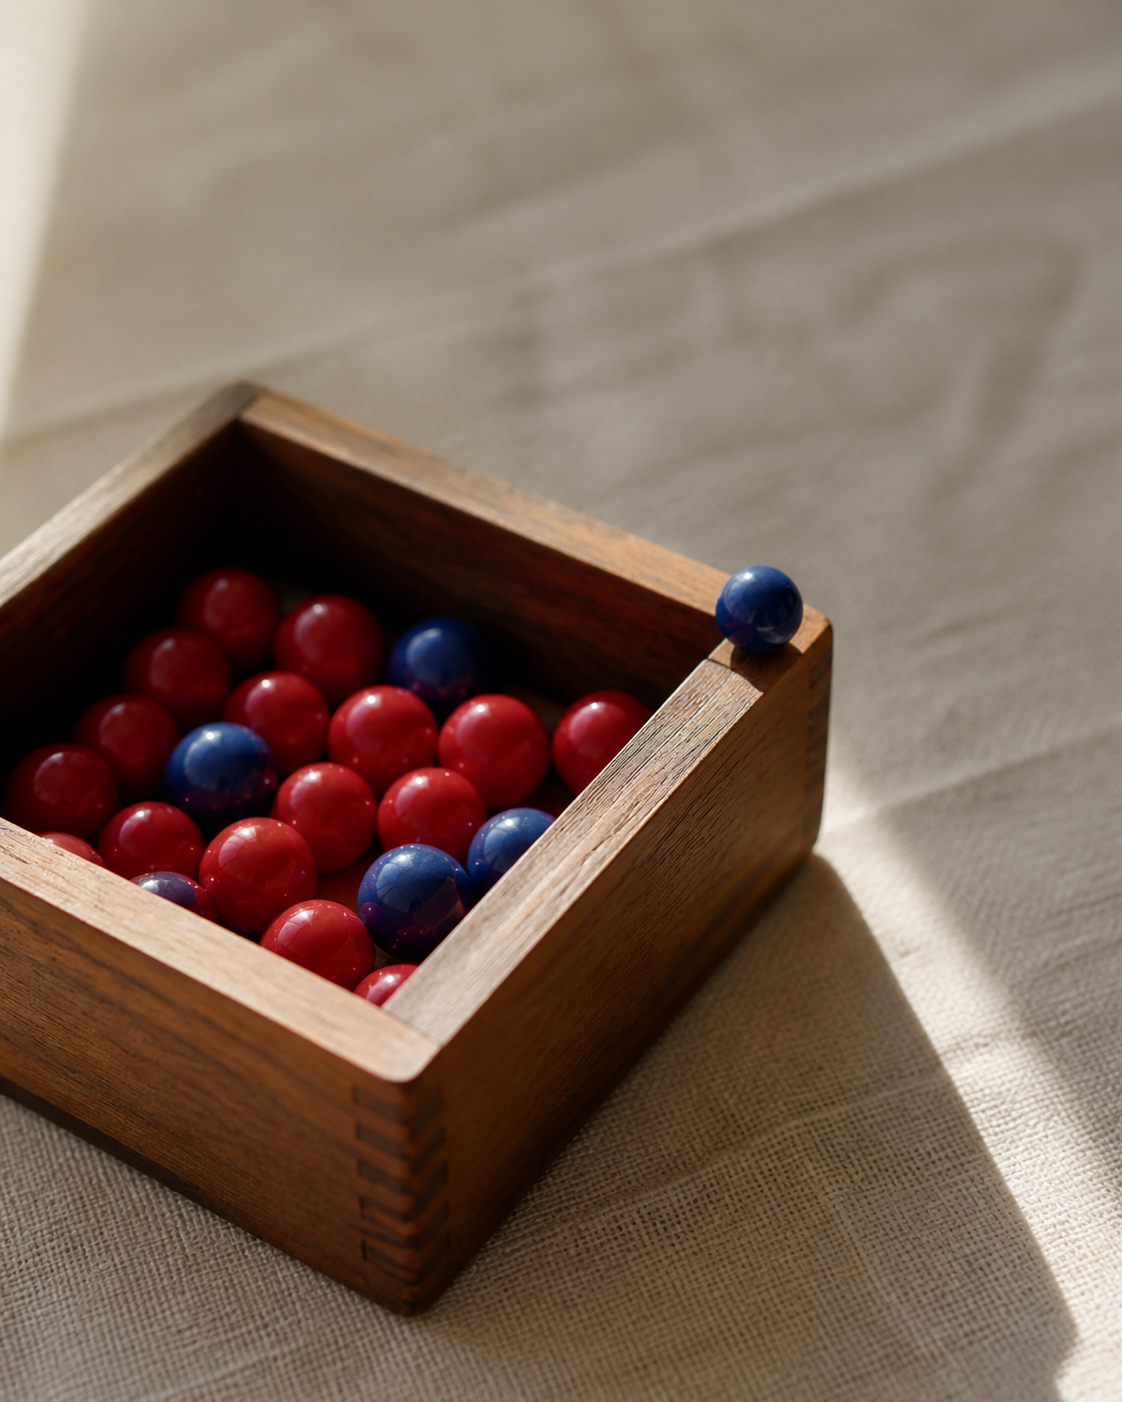
一个盒子里有红球和蓝球。小明说:“如果我从盒子里随机拿出一个球,它一定是红色的。”小明这句话一定为假,当且仅当什么条件成立?
正确答案应是:盒子里至少有一个非红球。
GPT-5在三次测试中有两次回答“盒子里至少有一个蓝球”,并给出类似推理:“小明的话为假,意味着并非所有球都是红色,因此至少有一个球是蓝色的。”
这一步看着自然,问题也在这里。题干只说盒子里有红球和蓝球,但要让“一定是红色”这句话为假,关键条件是存在非红球。若盒子里还可能有绿色球,小明的话同样为假,却不能推出“至少有一个蓝球”。模型把“非红”偷换成了“蓝”。
在日常对话里,这种省略经常不会出事;放进逻辑题,它就是硬伤。
更有意思的是,当我们指出这个错误,GPT-5会立刻承认并改正。但换一道同类型题,类似跳跃还会出现。这说明问题不只是某一次回答没想清楚,而是模型处理这类自然语言逻辑时,容易默认补齐一个“看起来合理”的中间条件。
硅谷101在关于GPT-5发布的讨论中也提到,发布会上出现过PPT图表错误、代码bug,以及用已被证伪的理论解释物理现象。它给出的判断比较直接:GPT-5仍然是有进步的合格AI产品,但没有让人明显感觉距离AGI更近,Transformer架构的一些弱点也没有消失。
我们的测试感受接近这个判断:能力在变强,短板也被放大了。
Claude 4更会刹车,Gemini 3 Pro会自查
Claude 4在50道题中正确率最高,达到78%。但它最有价值的地方不只是分数。
遇到不确定题目时,它常常会说:“这道题存在歧义,我需要澄清以下前提。”然后列出几种解释。按我们的评分规则,这类回答有时不算得分,因为它没有直接给出唯一答案;但在真实业务里,这比硬猜一个答案更安全。
Gemini 3 Pro的特点也明显。它在处理否定词嵌套时,会在推理中插入自我检查,比如“等等,让我重新确认一下这句话的否定范围”。这个动作看着笨,却有效。测试中,它在嵌套否定题上的正确率比GPT-5高出11个百分点。
知乎上那篇关于空间智能的评测也提到,GPT-5、Gemini 3 Pro这类强推理模型,在空间智能题型上和人类表现仍有明显差距。强模型并不等于每一种推理都强,尤其是题目故意卡在语言、空间或反事实细节时。
换句话说,模型“会不会停下来检查”,有时比“会不会把解释写长”更重要。
国产模型也不是同一种短板
Qwen3-235B在反事实推理题上表现突出,正确率达到82%,超过所有参测模型。但它在指代歧义题上只有53%,低于GPT-5的68%。
DeepSeek-V3的曲线更偏。集合关系题上,它几乎全对;否定词嵌套题上,它频繁出错。
这种偏科不难理解。不同模型的训练数据、强化方式和产品目标不一样,最后形成的“习惯动作”也不一样。数学推理类数据多,集合和符号关系可能更稳;语言陷阱类数据少,遇到多重否定、代词回指,就更容易滑。
一位参与测试的工程师说得很直白:
这些模型就像不同专业的研究生,各有各的死角。你不能假设一个数学博士就不会犯语法错误。
这句话比很多技术解释都准。
对齐让模型更像助手,却没让它更懂“不确定”
参测模型都经过RLHF,也就是基于人类反馈的强化学习,或其他对齐训练。对齐确实让模型更礼貌、更安全,也更像一个愿意配合的助手。
但这次测试暴露出一个问题:模型不一定更清楚自己什么时候不知道。
当它推不动时,常见动作不是停下来,而是给出一个顺滑答案。因为在人类标注和产品体验里,很多时候“完整、自信、可读”的回答会更讨喜;“我不确定”“这里需要澄清”反而显得不够能干。
这会让训练信号出现偏差:我们希望模型诚实,但奖励的常常是自信。
AI-Stack关于GPT-5的评测还提到,OpenAI在发布GPT-5的同时,一夜之间移除了八个受欢迎的旧模型,包括GPT-4o、o3、o3 Pro。部分用户把这个决定称为“AI历史上最大的诱骗和替换”。
模型能力还在磨,产品切换已经很激进。对开发者来说,这意味着一个现实问题:你不能只看发布会和榜单,还要知道模型在哪些细节上会突然失手。
提示词能做三层防御
根据这50道题的错误模式,我们把可用的防御办法压成三层。它们不需要改模型,也不依赖某个版本。
第一层:把前提写出来。
不要指望模型自动读懂所有隐含条件。关键条件最好拆成“已知:……”的形式。
例如,不要只写“判断这句话是否成立”,而是把对象范围、是否允许其他颜色、是否存在空集合等条件列清楚。我们的测试显示,这个动作能让否定词嵌套题的准确率提升约15个百分点。
第二层:限制推理链。
只写“请逐步推理”不够。更好的做法是要求模型每一步都检查:
这一步是否引入了题干没有给出的假设?
很多错误不是第一步就错,而是在中间偷偷补了条件。比如把“非红”补成“蓝”,把“有人没反对”补成“所有人同意”。这些补条件的动作,如果不显式拦住,模型很容易当成常识处理。
第三层:让它找反例。
模型给出答案后,再追加一句:
请构造一个反例,使得如果这个反例成立,你的答案就是错误的。如果无法构造反例,请说明原因。
这是低成本自检。在50道题里,启用反面验证后,GPT-5的自我纠错率从12%提升到41%。
这三层方法做的是同一件事:把模型从“顺着说下去”的轨道里拉出来,让它面对自己的跳步。
这和我们之前在《Agent进公司后,账单先醒了》中讨论的Agent成本问题有相似之处。很多损耗不来自模型单价,而来自上下文膨胀、工具重试、失败重试。再往根上看,常常是模型误判了自己的能力边界。
榜单高分不等于生产可靠
GPT-5在基准上拿高分是事实。它在50道反逻辑题里翻车,也是事实。这两件事可以同时成立。
基准测试更像在标准条件下看峰值能力。反逻辑题看的是另一个东西:模型遇到语言陷阱时,能不能稳住;推不动时,能不能承认推不动。
对把大模型接入生产流程的团队来说,后者不比前者轻。一个模型在大多数时候都正确,但在少数关键节点给出自信错误,损失可能会被放大。
我们在《通专融合下半场:通用大模型怎么接住工厂订单》中写过一个例子:浙江一家汽车零部件厂用Qwen2.5-72B加RAG,把质检误判率从15%压到2.1%,一年省下170万人力成本。这里真正起作用的,不是模型在某个榜单多考了几分,而是把“自信地误判”的概率压了下去。
GPT-5没有让这个问题消失。它只是让更多人看到:当模型越来越强,错误也会更有说服力。开发者要防的,正是这种说服力。