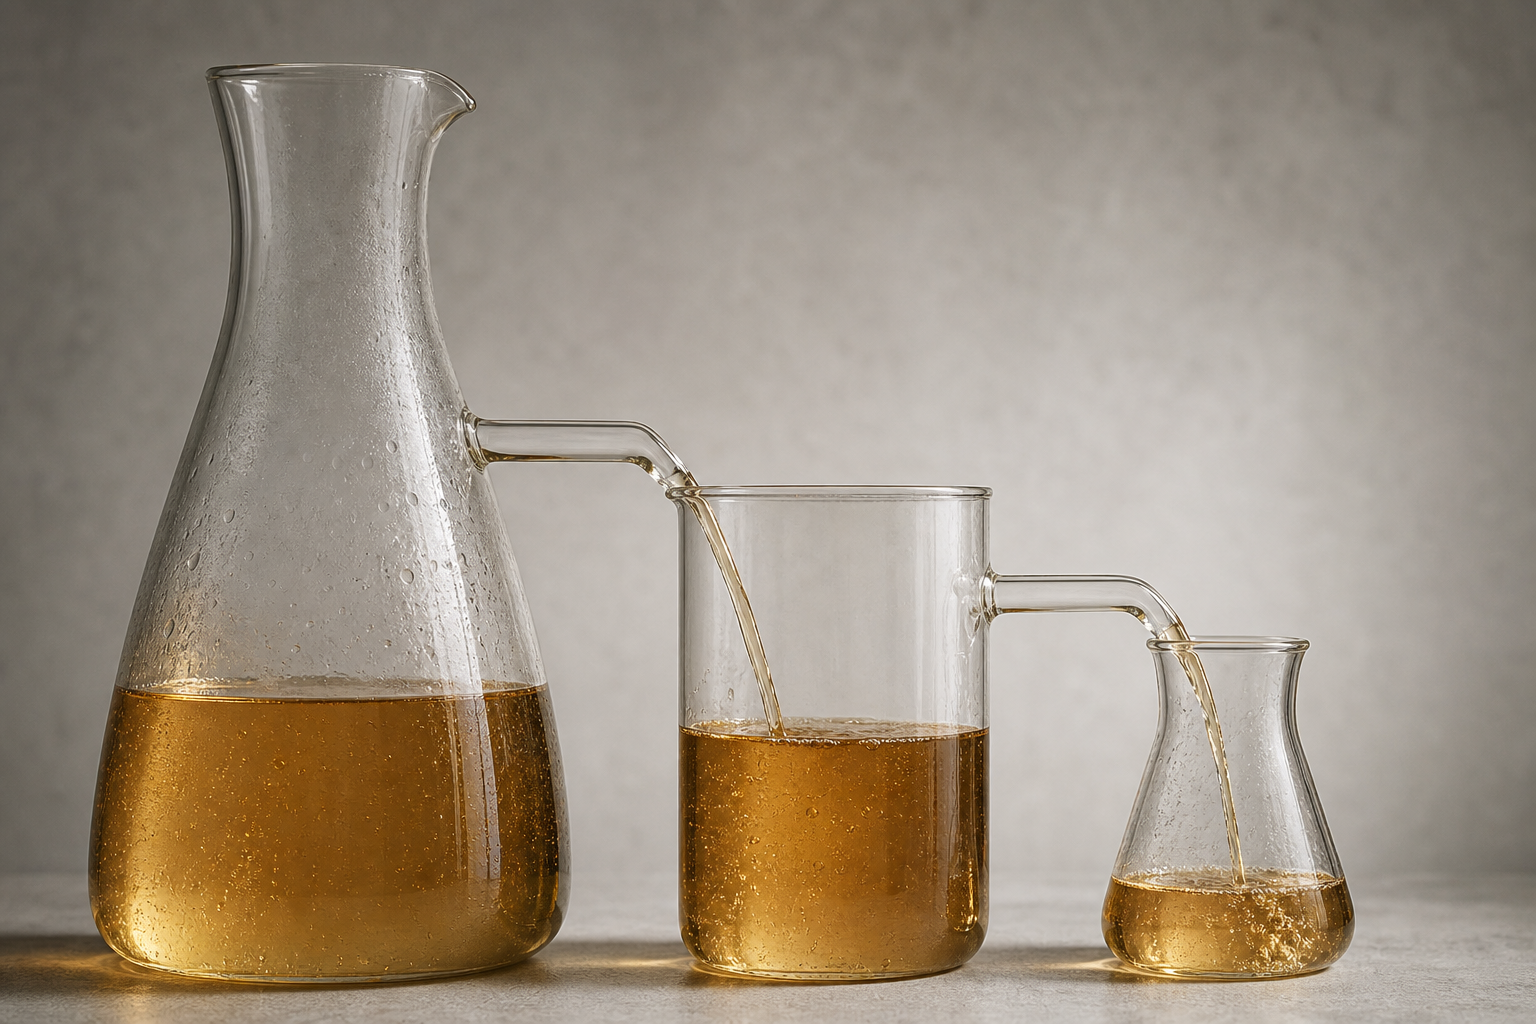
GPT-5.6 把模型分成三个长期能力等级:旗舰型号 Sol、面向日常工作的 Terra,以及强调速度和成本的 Luna。OpenAI 表示,三个等级会按不同节奏升级,开发者可以在能力、速度和费用之间做选择。
这种分层也改变了 API 路由的思路。过去,团队可能把最强模型设为默认入口,再通过缓存压低重复调用的费用。现在有了 Sol、Terra、Luna,继续让所有请求先走 Sol,很容易把本可避免的模型成本藏在缓存命中率里。
需要先说明的是,现有可引用资料可以确认 GPT-5.6 的三层产品结构,以及 Terra 相比 GPT-5.5 的价格定位,但不足以独立核实具体的缓存涨价幅度、存活时间和存储上限。团队是否需要调整路由,应以 OpenAI 官方账单、API 返回的 token 用量和实际任务成本为准。
别只盯请求命中率
缓存有没有省钱,不能只看“多少次请求命中”。真正影响账单的是:一次请求里,到底有多少输入 token 被缓存覆盖。
例如,一条请求的大部分 system prompt 保持不变,只有末尾的用户资料和对话记录发生变化。它在请求层面可能被记为命中,但动态部分仍会产生费用。上下文越长,这种差异越容易被平均值掩盖。
更稳妥的办法,是在网关层记录每次调用的 prompt_tokens、cached_tokens、模型名称和任务类型,再计算 token 级命中率:
cache_hit_rate_by_token = sum(cached_tokens) / sum(prompt_tokens)
这项指标要按模型和任务拆开看。Sol 的法律分析与 Luna 的格式转换混在同一张图里,整体命中率再漂亮,也无法告诉你哪类请求正在推高成本。
除了命中率,还应同时记录单任务费用和重试次数。缓存命中率上升,并不必然代表总成本下降;如果请求频繁截断或超时,重复调用仍可能吃掉节省下来的费用。
Sol 留给确实需要复杂推理的请求
根据 Ai Marketer HK 与科技新报对 GPT-5.6 的介绍,Sol、Terra、Luna 对应不同的能力和成本档位。Sol 是旗舰型号;Terra 面向日常工作,性能定位接近 GPT-5.5,价格更低;Luna 主打速度和经济性。
路由时可以先按任务性质分三层:
- Luna:摘要、分类、格式转换、字段提取和简单问答。
- Terra:代码生成、文档分析、客服回复和一般业务推理。
- Sol:法律论证、复杂约束处理、长链条推理,以及错误代价较高的任务。
分流依据最好来自业务元数据,而不是临时让 Sol 判断一次。调用方通常已经知道请求来自哪个产品入口、处理哪类文档、是否需要严格引用,以及失败后能否人工复核。把这些信息写进任务标签,比仅靠 prompt 关键词更稳定,也不会额外消耗一次旗舰模型调用。
对于边界模糊的任务,可以先交给 Luna 或 Terra 做低成本分类,再决定是否升级到 Sol。分类器只输出任务等级和理由,不直接生成最终答案,便于后续审计和调整。
给重试设一条明确的退路
压低 max_tokens 看起来能控制单次费用,但长任务一旦因长度限制中断,系统往往会重新提交完整上下文。若重试逻辑没有上限,成本会在后台不断累积。
网关应为每类任务预先写好降级链。例如:
Sol → 检查截断或超时 → 调整参数重试 → Terra 接续处理 → 人工复核
这里的重点是让每一步都有触发条件:什么情况下允许再次调用 Sol,什么时候换成 Terra,连续失败后是否进入人工队列。不要把“捕获异常后原样重试”当成兜底方案。
模型降级也不等于无条件追求更便宜。高风险任务如果必须由 Sol 完成,系统可以停止自动重试并交给人工,而不是为了完成率把它交给不合适的模型。
路由脚本应把成本参数留在配置层
下面的示例按任务标签选择模型,并显式定义后备路径。具体的 token 上限、缓存条件和价格参数应从配置中心读取,避免定价变化后修改业务代码。
from dataclasses import dataclass
from enum import Enum

class TaskLevel(Enum):
    L0 = "luna"
    L1 = "terra"
    L2 = "sol"

@dataclass
class RoutingDecision:
    model: str
    use_cache: bool
    fallback_chain: list[str]


def classify_task(task_type: str, high_risk: bool) -> TaskLevel:
    if high_risk:
        return TaskLevel.L2

    if task_type in {"summarize", "classify", "extract", "format"}:
        return TaskLevel.L0

    return TaskLevel.L1


def build_routing(level: TaskLevel, stable_prefix: bool) -> RoutingDecision:
    if level == TaskLevel.L0:
        return RoutingDecision(
            model="luna",
            use_cache=stable_prefix,
            fallback_chain=["terra"]
        )

    if level == TaskLevel.L1:
        return RoutingDecision(
            model="terra",
            use_cache=stable_prefix,
            fallback_chain=["sol"]
        )

    return RoutingDecision(
        model="sol",
        use_cache=stable_prefix,
        fallback_chain=["sol_no_cache", "terra", "human"]
    )


def execute_with_fallback(prompt, decision, model_config):
    steps = [decision.model] + decision.fallback_chain

    for step in steps:
        if step == "human":
            return manual_review(prompt)

        config = model_config[step]
        response = call_model(
            model=config["model"],
            prompt=prompt,
            max_tokens=config["max_tokens"],
            use_cache=decision.use_cache and config["allow_cache"]
        )

        if response.finish_reason == "length":
            continue

        return response

    return manual_review(prompt)
这段代码有三个值得保留的设计:任务等级由业务信息决定;后备模型提前写入路由表;价格、上下文限制和缓存开关放在配置层。以后模型定价或接口规则发生变化,只需更新配置,不必重写整条调用链。
Prompt 结构会直接影响缓存效果
很多缓存问题最终出在 prompt 拼接方式上。时间戳、随机 ID、用户昵称和实时状态如果放在开头,原本稳定的前缀会不断变化。即便请求内容高度相似,也很难复用已有缓存。
可以把 prompt 拆成两部分:前面放固定的角色说明、输出格式和规则,后面再追加用户输入、对话记录与实时字段。模板更新也要有版本号,避免不同版本在缓存和日志里混为一谈。
缓存预热则要谨慎。它适合模板稳定、调用频繁且需求可预测的场景。低频 prompt 批量预热,可能只是提前支付一次写入费用。是否值得做,应根据实际复用次数和节省金额计算,不能只看命中率变化。
账单要按任务看,不能只按模型看
路由调整后,建议每周检查四组数据:每类任务的模型分布、token 级缓存命中率、单任务费用,以及截断和超时引发的重试次数。
如果 Sol 调用减少,但高风险任务的完成质量保持稳定,说明分流开始生效。若 Terra 调用增加,同时重试率明显上升,则可能是任务边界划得太激进,需要把部分请求升回 Sol。
GPT-5.6 已经用 Sol、Terra、Luna 给出了清晰的产品分层。API 团队要做的,是把这套分层落实到自己的任务标签、缓存条件和失败处理里。缓存仍然可以省钱,但不该再成为所有请求默认走旗舰模型的理由。
参考资料
- Ai Marketer HK:OpenAI 推出 GPT-5.6 三层架构,Sol、Terra、Luna 分别对应不同能力等级
- 科技新报:GPT-5.6 三款模型定位与定价信息
- Eden AI:GPT-5.6 Sol API、定价与基准测试资料页
- Finout:GPT-5.6 Sol、Terra、Luna 定价说明页