上个月,一个做 SaaS 的团队把他们的 MCP 自动周报跑数发给我:三个月了,准确率死活卡在 70% 出头,剩下的三成要么漏日程、要么把 A 项目的进展贴到 B 项目的标题下,要么周报发出去才发现格式全乱。
他们接的是飞书官方 MCP Server,用的是 2025 年 5 月那次 OpenAPI 限流调整之后的版本,按理说工具已经稳定了。问题不在工具本身。
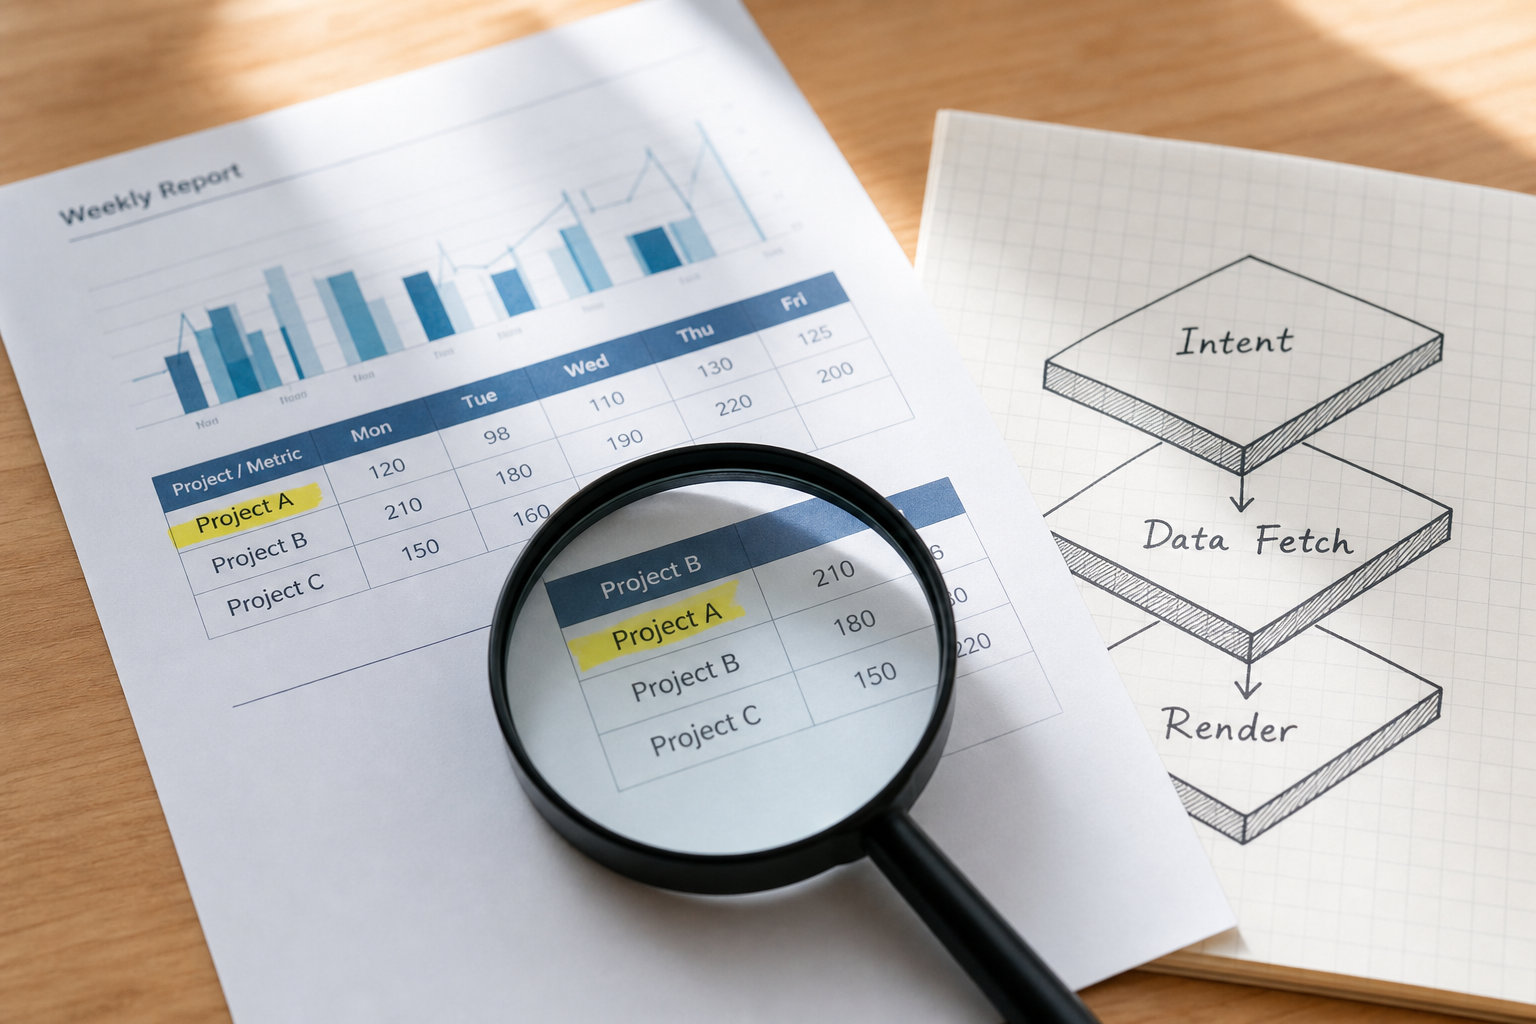
把三个月排障日志翻完一遍后,可以把故障拆成三层:意图识别、数据拉取、模板渲染。每一层的失败模式都不一样,止血的位置也不一样。
意图识别:模型知道"查周报",不知道"谁的周报"
MCP 把飞书 OpenAPI 封装成工具后,模型能调用 calendar.v4.event.list 查日程,能调用 bitable.v1.app_table_record.list 拉多维表格数据。但"查周报"这个意图落到具体调用时,模型要替用户做四件事:
- 选定时间窗(这周一到周日,还是上周一到上周日)
- 选定人员范围(自己、team、还是指定同事)
- 选定业务实体(哪个项目空间、哪个多维表格 base)
- 选定字段语义("进展"字段到底指状态变更还是评论数)
70% 的准确率意味着,模型在四件事里平均能蒙对三件。错的那一件,往往是字段语义。
诊断方法很简单:把过去一周模型实际发出的工具调用和最终周报对照,挑出"周报里出现但工具调用没拉"或"工具调用拉了但周报没出现"的条目,按上面四个维度分类。多数团队做完这一步就会发现,"字段语义错"占错例的一半以上。
改造路径有两条。一是把字段语义写进系统提示词,但提示词会被对话上下文稀释,效果不稳定。二是更稳的做法:在 MCP 之上再叠一层 Skill,把"查周报"这件事拆成显式的步骤模板,每一步只让模型做一次窄判断。飞书开发者文档里提到的"基于 OpenAPI 面向 AI 场景封装优化",本质就是这件事的工具化版本。
数据拉取:限流、分页和权限是隐形天花板
工具调用发出去,不代表数据能拿回来。飞书 OpenAPI 在 2025 年 5 月那次调整后,限流阈值按租户和应用分别计算,部分接口还有并发上限。一个团队周报场景里,模型一次对话可能要拉日程、表格、文档评论、OKR 四类数据,每类都要分页。
最容易踩的坑有三个:
- 限流 429:模型默认会重试,重试又触发更严格的限流,最后一次成功的响应里只有前几页数据,周报自然不全。
- 分页断点:模型在多轮对话里不会自动续页,第二轮对话从第一页重新拉,浪费配额。
- 权限边界:飞书租户管理员经常只给"读日程"权限,没给"读多维表格"权限,工具调用返回空数组,模型误判为"这周没记录"。
诊断方法:把工具调用的 HTTP 状态码和返回体落库,跑一周后统计 429 占比、平均页数、权限拒绝次数。
改造建议:
- 在 MCP 之外加一层调用网关,做 token 桶限流和指数退避;
- 把分页逻辑从模型手里拿走,在网关层自动续页;
- 权限校验放在调用前,缺权限直接报错给运营,而不是返回空数据让模型瞎猜。
模板渲染:飞书文档的富文本结构,不是 Markdown
最后一层是渲染。模型生成的"周报"在它眼里是一段 Markdown,但飞书文档是 Block 树,一段文本、一个表格、一个待办是不同节点。模型把 **加粗** 直接写进去,飞书渲染时会原样显示两个星号。
更隐蔽的问题是表格。模型生成的 Markdown 表格复制到飞书文档里,会变成一坨带 | 的纯文本,而不是真正的多维表格 block。要让它变成可点击、可筛选的表格,得调用专门的 block API。
诊断方法:抽样十条周报,人工标注"渲染异常点",按类型统计。会发现三类高频问题:富文本标签未转换、表格未结构化、@人未触发通知。
改造建议:
- 把飞书文档的 block schema 喂给模型,并要求它输出结构化的 block 列表,而不是 Markdown;
- 在 MCP 工具集里增加一个
docx.v1.document.block.batch_update类似的写入工具,模型只负责生成结构,写入由工具完成; - 关键格式(项目名、负责人、日期)用变量占位,由渲染层统一替换,避免模型自由发挥。
三层的关系:不要让模型同时做三件事
排障到这一步会意识到一个更底层的设计问题:MCP 把工具暴露给模型,模型同时承担了"理解意图"和"组装结果"两件事。一旦工具集变大、字段变多,模型的注意力会被稀释。
更稳的架构是把三层拆给三个角色:
- 意图识别交给一个窄模型或规则层,只判断"查谁的、查什么时间段";
- 数据拉取交给后端服务,对接 MCP 但不直接面向模型对话;
- 模板渲染交给模板引擎,模型只填变量。
这样,70% 的准确率才有可能在下一个季度推到 90% 以上。
三个月后真正的结论
MCP 适合负责"调用",不适合负责"判断"。飞书 MCP Server 的工具覆盖面是够的,问题出在团队把"理解 + 调用 + 渲染"全压给模型。一旦把判断和调用拆开,把渲染交给专用工具,准确率的天花板会从模型的注意力上限,抬升到业务流程的清晰度上限。
这也是为什么有些团队在接完 MCP 三个月后开始转向 Skill + 飞书 CLI 的组合:MCP 负责跨系统的工具编排,Skill 负责流程模板,CLI 负责高频确定性调用。三者各司其职,自动周报才真正能跑起来。
相关阅读可以参考站内《MCP 协议接进飞书三个月,自动周报的准确率仍然卡在哪》,里面记录了同一团队更早期的排障记录。