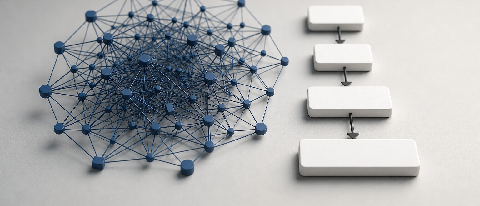
把混合检索叫作 RAG 3.0,并不能帮团队做架构决定。先看错误发生在哪里。
用户问“这份公告讲了什么”,向量检索通常够用。问题变成“A 公司与 B 公司通过哪些主体发生关联”,系统需要的不只是相似文本,还要识别实体、关系方向和连接路径。
同一名董事的任职记录和持股记录可能出现在相近的文本里,Embedding 也很接近,但两者对应的法律关系并不是一回事。在金融、法律等容错率较低的场景中,最麻烦的情况不是系统拒绝回答,而是它引用了真实文档,却拼出了一条错误的关系链。
tianpan.co 一篇标注日期为 2026 年 4 月 19 日的文章称,截至 2025 年,只有不到 15% 的企业在生产环境中部署了基于图的检索。文章还把常见的架构反应滞后概括为“晚了六个月”[1]。这一数字来自单篇技术文章,适合作为风险提示,不宜当成统一口径的市场统计。
先分清系统错在哪
向量 RAG 解决的是语义相似问题。文档经过切片和 Embedding 后,Milvus、Pinecone 等向量数据库负责找出与问题最接近的文本。它适合定义查询、条款定位、单点事实和 FAQ,也适合从大量材料中快速缩小范围。
GraphRAG 处理的是另一类问题。IBM 对它的定义是:在传统 RAG 基础上引入知识图谱等图结构数据,利用实体之间的关系进行检索[2]。文档中的公司、人物、合同和案件被建成节点,持股、任职、担保和诉讼关系则成为边。
两者不是简单的升级替代关系。
| 查询类型 | 更合适的入口 | 原因 |
|---|---|---|
| “什么是量子计算” | 向量检索 | 重点是找到语义相关的解释文本 |
| “制度中哪一条规定了审批权限” | 向量检索配合元数据过滤 | 需要定位原文和出处 |
| “A 公司股东是谁” | 图检索 | 答案依赖明确的实体关系 |
| “A 公司与 B 公司过去三年有哪些共同诉讼” | 图检索配合时间过滤 | 需要跨实体、跨文档聚合关系 |
| “给出股权路径并附上公告原文” | 图与向量双路检索 | 图负责路径,向量负责证据片段 |
GraphRAG 也不会自动带来更可靠的答案。实体抽取错误、公司别名没有合并、关系方向写反,都会把错误固化进图谱。问题里如果带有“过去三年”这类时间条件,图中的边还要保留有效时间或来源日期,否则路径正确,时间范围仍可能答错。
混合架构的核心是分流
混合检索不是每次查询都同时跑两套系统。这样做会增加延迟和调用成本,也会让结果融合变得更难。真正需要的是 Query Router:先判断问题类型,再决定走哪条检索链路。
可以从几类清晰的规则开始:
- 定义、摘要、条款和来源定位,进入向量检索。
- 控制、任职、持股、共同诉讼和关系路径,进入图检索。
- 既要关系结论,又要原始依据,启动双路召回。
- 路由结果不确定时,再触发另一条链路作为补充。
路由器可以是规则分类器,也可以使用模型判断意图。早期更重要的不是分类器有多复杂,而是拿真实查询逐条检查:它是否把关系问题错送给了向量库,又是否把普通事实查询送进了成本更高的图路径。
图检索占总流量的比例也不该预先写成固定数字。企业 FAQ、制度库和投研资料库的查询分布完全不同,合理占比只能从实际日志中得出。
索引时先把证据链留住
混合架构通常有两条索引管道,但底层文档标识必须统一。
- 向量管道:文档切片后生成 Embedding,写入 Milvus 或 Pinecone,并保留
document_id、chunk_id、来源和更新时间。 - 图管道:从文档中抽取实体与关系,完成别名归一和实体消歧,再写入 NebulaGraph 等图数据库。
- 证据回链:每个节点和每条边都要能指回原始文本片段,而不是只保存一段模型生成的关系描述。
- 增量更新:文档新增、修改或删除后,向量索引和图谱要同步处理,避免一边已经更新,另一边仍保留旧关系。
证据回链尤其重要。知识图谱不是事实本身,而是从事实材料中抽取出来的索引。如果一条“某公司控制另一家公司”的边无法指回公告、合同或制度条款,用户就很难核验,系统也无法解释关系从何而来。
Microsoft GraphRAG 可以承担实体关系抽取、索引编排和社区摘要生成。社区摘要适合处理跨文档的整体性问题,但不应替代原文证据。生成答案时,图路径仍要回到具体文档片段。
工具能拼起来,接口要自己对齐
Microsoft GraphRAG 的项目可以从 CLI 初始化开始。具体参数需要按所用版本核对:
pip install graphrag
graphrag init --root ./my_rag_project
把 Microsoft GraphRAG、NebulaGraph 和 Milvus 放进同一套系统时,仍要处理数据映射和调用接口,不能把它理解成只改一份 settings.yaml 就能自动完成的组合。
各组件的职责可以这样划分:
- Microsoft GraphRAG 负责文档索引、实体关系抽取和摘要生成。
- NebulaGraph 负责实体、关系及路径查询。
- Milvus 或 Pinecone 负责文本片段的向量召回。
- BGE-Reranker-v2-m3 或 Cohere Rerank 可用于候选结果排序。
NebulaGraph 团队公开分享过 Fusion GraphRAG 的组合实践[3]。AI-Compass 的整理页还收录了 Microsoft GraphRAG、KAG、LightRAG 和 Fast-GraphRAG 等工具[4]。可选框架不少,但生产选型仍要回到数据格式、更新方式和可观测性。
查询端可以保留一个简单、清晰的控制层:
def hybrid_search(query):
    route = query_router.classify(query)

    if route == 'vector':
        return milvus.search(query)

    if route == 'graph':
        paths = nebula_graph.traverse(query)
        return attach_source_chunks(paths)

    vector_hits = milvus.search(query)
    graph_paths = nebula_graph.traverse(query)
    graph_hits = attach_source_chunks(graph_paths)

    candidates = merge(vector_hits, graph_hits)
    return reranker.rank(candidates, query)
这段伪代码里,attach_source_chunks 比 reranker 更值得关注。重排序模型只能调整候选结果的顺序,修复不了一条抽取错误的图关系。图检索返回路径后,必须补齐对应的原始文本,才能交给模型生成答案。
性能比较别只看一张总表
脱离数据集讨论统一准确率没有太大参考价值。单点事实查询中,向量检索可能更直接;多跳关系查询中,高质量图谱更容易给出完整路径。混合架构的表现,则取决于路由和证据融合是否可靠。
| 对比项 | 向量检索 | GraphRAG | 混合架构 |
|---|---|---|---|
| 索引工作 | 切片和 Embedding | 实体抽取、关系抽取、消歧和建图 | 同时维护两套索引及映射 |
| 在线链路 | 向量召回,路径较短 | 实体定位、图遍历和证据回链 | 单路时接近对应检索,双路时增加融合开销 |
| 擅长问题 | 语义匹配、单点事实 | 关系路径、跨文档关联 | 同时要求关系结论与原始依据的问题 |
| 常见错误 | 相似实体混淆、证据碎片化 | 错误关系、旧关系和断链 | 路由错误、两路证据冲突 |
| 维护重点 | 切片、Embedding 和元数据 | 实体消歧、关系更新和来源追踪 | 索引同步、路由监控和结果融合 |
评测时应按问题类型拆开统计,至少分别观察单点事实、关系路径、跨文档聚合和带时间条件的查询。除了答案是否正确,还要记录证据是否完整、路由是否正确、中位数与尾部延迟、索引更新耗时以及单次查询成本。
如果只看一个汇总准确率,很容易掩盖真实问题:向量检索在简单问题上的优势,会冲淡关系查询的失败;图检索在复杂问题上的收益,也可能被大量普通 FAQ 稀释。
什么情况下先别上图
知识库主要由新闻、博客、产品说明或简单 FAQ 构成时,先优化切片、元数据过滤和重排序通常更合适。如果错误来自 OCR 质量、文档缺失或权限过滤,增加知识图谱也不会解决问题。
出现以下信号时,再认真评估 GraphRAG:
- 系统频繁混淆名称相似的公司、人物或产品。
- 答案依赖两层以上的关系路径。
- 用户需要查看股权、任职、担保或诉讼关系的来源。
- 同一问题必须跨多份文档拼接证据。
- 仅调整切片、Top-k 和重排序后,关系错误仍然存在。
还要确认团队是否有能力维护图谱。企业数据持续变化,新增关系要写入,失效关系要撤回,别名和合并实体也要同步处理。只建设、不更新的图谱,很快会成为新的错误来源。
真正的分界线是错误类型
GraphRAG 的价值从“关系本身就是答案”时开始。它不是向量检索的替代品,也不该成为所有查询的默认入口。
如果系统错在没有找到相关文本,先检查切片、Embedding、元数据和重排序;如果文本找到了,实体之间的路径仍然拼错,再引入图结构。生产环境里的混合架构,本质上就是把不同问题交给合适的索引,再让所有结论回到可核验的原始证据。
参考资料
[1] GraphRAG vs. 向量 RAG:团队往往过晚才做的架构决策,tianpan.co,页面标注 2026-04-19。
[2] What is GraphRAG?,IBM。
[3] GraphRAG vs DeepSearch?GraphRAG 提出者给你答案,NebulaGraph。
[4] AI-Compass GraphRAG,GitHub。