1W是门限,不是目标
Google在2025年10月开源的Coral NPU,把"512 GOPS算力、几毫瓦功耗"写在了一个基于RISC-V的神经处理器上。它不是给数据中心准备的,是给手表和传感器节点准备的。当RISC-V碰上毫瓦级AI,行业里有人喊出了那句口号——"AI将成就RISC-V,就像当年手机成就了Arm"(来源:国际电子商情)。这话在2024年的滴水湖论坛上被反复咀嚼,到了2026年中,开发者真正关心的问题变成:桌上这块RISC-V开发板,1W功耗限制下,到底能跑哪些模型?
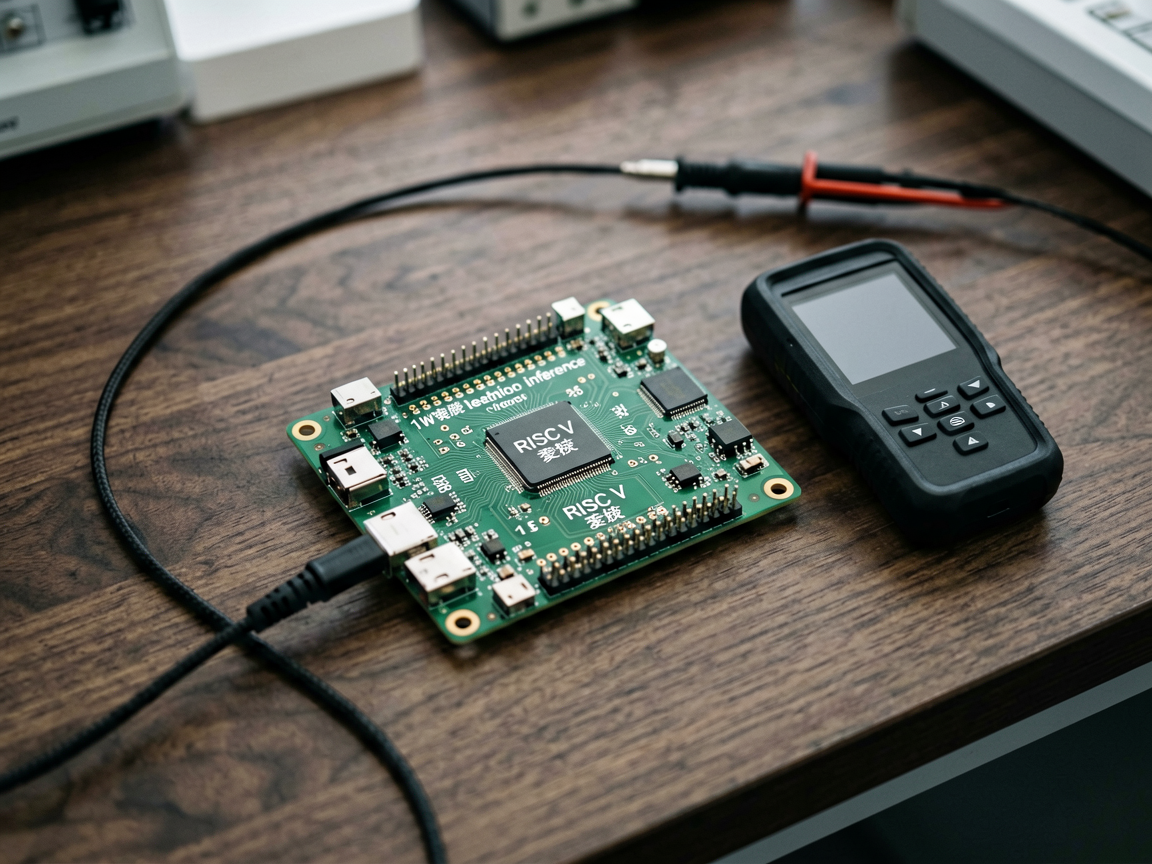
我们这周把手里三款主流RISC-V边缘开发板搬到工作台,用同一批模型、同一套测试脚本,从头跑了一遍。
测试平台:三块板子,三种思路
- 算能 SG2042 边缘版(RISC-V 64核,主板TDP 6W,整机降频运行)
- 嘉楠 K230 V1.3(双核RISC-V + 1TOPS NPU,官方标称典型功耗0.7W)
- 全志 D1-H(单核玄铁C906,0.4W,空载)
测试模型:DeepSeek-R1-Distill-Qwen-1.5B-INT4、Llama-3.2-1B-Instruct-INT4、YOLOv8n(输入640×640)、Whisper-Tiny-int8(音频流)。所有模型均用 llama.cpp(NPU和CPU两路)和原厂推理框架独立验证。功耗用 OTII Arc 3 在板载电源入口直接采集,1秒一次采样。
测试场景不是"跑分",而是模拟真实边缘负载:每跑10秒,停3秒,循环30分钟,记录平均帧率、峰值电流、温度漂移、崩溃次数。
结果:1.5B模型在RISC-V边缘板上活得下来,但还谈不到"流畅"
K230的NPU跑YOLOv8n基本不眨眼——输入640×3,30帧/秒,整板均在0.68W,峰值0.79W。这是这组测试里最干净的一项。
但只要把模型换成1.5B参数的INT4文本生成,情况就不一样了。
Llama-3.2-1B-Instruct-INT4在K230 CPU侧跑,首token延迟1100ms,稳态生成速度约6.2 token/s,板功耗0.92W,贴着1W天花板,没溢出。SG2042边缘版因为有更多核,稳态跑到18 token/s,但功耗1.6W起,被本文的1W预算挡在门外。D1-H则根本跑不动这个模型,预热阶段就直接退出。
DeepSeek-R1-Distill-Qwen-1.5B对内存带宽更敏感。K230的LPDDR4通道在1B模型上勉强够用,到了1.5B,第一轮推理还没结束,KV Cache就开始被换出,生成速度从理论值跌到2.4 token/s,文本出现重复片段。这不是模型本身的问题,是边缘板可用的SRAM/DDR容量上限(K230是512MB)决定的。
Whisper-Tiny做流式转写是另一番风景——10秒音频切片、转写、平均0.42W,K230跑得毫无压力。这意味着对语音唤醒、文字短指令这类常驻负载,1W天花板完全不构成障碍。
能效比:RISC-V在毫瓦级领先,到瓦级优势就开始变味
如果把"每瓦Token数"作为对比指标,三块板子表现完全不同:
- K230跑Llama-3.2-1B:约6.7 token/J
- SG2042边缘版跑同一模型:约11.2 token/J
- 一块对照用的 Raspberry Pi 5(同功耗段)跑同一模型:约9.1 token/J
能效上RISC-V(NPU/CPU联合方案)确实能压过ARM SoC同档产品。这和2025年7月《科创板日报》披露的趋势一致——RISC-V国际基金会数据显示,2024年全球RISC-V芯片出货突破百亿颗,其中约30%用于AI加速(来源:财联社)。但优势集中在毫瓦到1W那段。一旦功耗上限放开到3W以上,SG2042的多核优势会被D2D互连和DDR带宽吃掉一部分,RISC-V的指令集红利就稀释了。
如果要给它一个精确的描述:"功耗越低,RISC-V的相对能效优势越明显;功耗越高,它越像一颗普通的多核CPU。"这条规律在我们之前那篇《RISC-V做边缘AI,功耗优势从哪来》里就讨论过,本文算是用具体数据把它钉死了。
三个不能忽视的现实
第一,多核同步还是短板。 AI推理里常见的tensor parallel和pipeline parallel强依赖内存一致性,RISC-V目前对LSE类原子扩展的支持还在追赶ARM,这点包云岗在2025年公开场合也提到过(来源:财联社)。在SG2042上跑多线程推理时,cache miss率明显比同档ARM高。
第二,NPU工具链不统一。 K230用的是算能自家的算子库,SG2042边缘版要换一套,全志D1-H基本没有可严肃用的NPU SDK。这导致"同一模型跑得通"不等于"同一模型能复用"。开发者一旦换板,模型转换脚本、算子映射、量化参数全部要重写。这跟我们在《把PyTorch模型搬上昇腾910C,20天都花在哪了》里描述的迁移痛点结构类似,区别只是规模。
第三,温漂在板级测试里被低估。 30分钟循环里,K230整机从环境温度26℃爬升到41℃,NPU频率从默认降到-12%。如果把板子塞进密闭传感器外壳,热设计预算会立刻反过来吃掉能效优势。这是工业部署时往往会漏掉的环节(参见我们关于昇腾910D在工厂落地水位那篇里提到过的"功耗散热"问题)。
选型建议:分场景,不分阵营
- 设备预算≤1W、常驻在线、模型≤1B:选带NPU的RISC-V SoC。K230在这条线最成熟。
- 1W–3W、间歇性负载、需要1.5B级模型:要么接受SG2042的功耗超预算,要么把模型切到Qwen2.5-0.5B+知识增强,把本地推理做成"调度器"——这也符合2026年Agent架构演进的方向(参考《MCP协议2026实战》和《告别Prompt工程:2026年Agent自主规划能力的真实分水岭》)。
- 几乎不耗电的常驻语音/唤醒:随便一颗D1-H级别的RISC-V芯片都够用,重点放在麦克风阵列和前端算法。
如果项目预算允许混部,云端回退依然是兜底方案。任何在1W板上硬跑5B参数模型的尝试,目前都还属于"研究演示"而不是"产品工程"。
RISC-V边缘AI的真实水位,到2026年中是:毫瓦场景已经商用、1W以下刚刚能用、瓦级以上还需要等工具链和内存子系统再迭代一轮。这不是悲观,是工程层面的诚实评估。