名字一换,袖子先变了
这次处理的是一款三国题材 SLG 的 alpha 版本。项目已有简中、日、韩、英资产,这一轮追加繁中(台湾)和粤语(香港),简中同时作为对照。217 个角色,每人有主立绘、半身像、Q 版头像、技能图标和商店卡牌 5 类资产。按三个中文版本计算,共有 3,255 个资产位,每个资产位还要再出 3 张候选。
日服角色此前用了“关羽·真矢”“周瑜·燐”这类合成词。繁中版本改成本地化程度更高的“關雲長·龍膽”“周公瑾·火燄”“諸葛孔明·八陣”,并配上 Sundream 工作室画师的手稿。
名字读起来很顺,出图却出了问题。
第一轮同时跑了 Midjourney v6.1,以及挂一层 LoRA 的 Stable Diffusion XL 1.0 工作流。输出里混进了西方龙、苦艾酒式意象和日式阵图,衣料与配饰也一路漂向欧洲中世纪风。模型没有稳定理解完整人名,只抓住了几个容易画出来的字面片段。
线稿稳定,不等于衣服稳定
日服和简中素材已经迭代到第 14 版,人物姿态、轮廓和构图都很稳。alpha 测试里被玩家截图指出的“工艺问题”,主要落在细节上:素色长袍是否干净,布衣战痕有多旧,铜器包浆有没有跑掉。
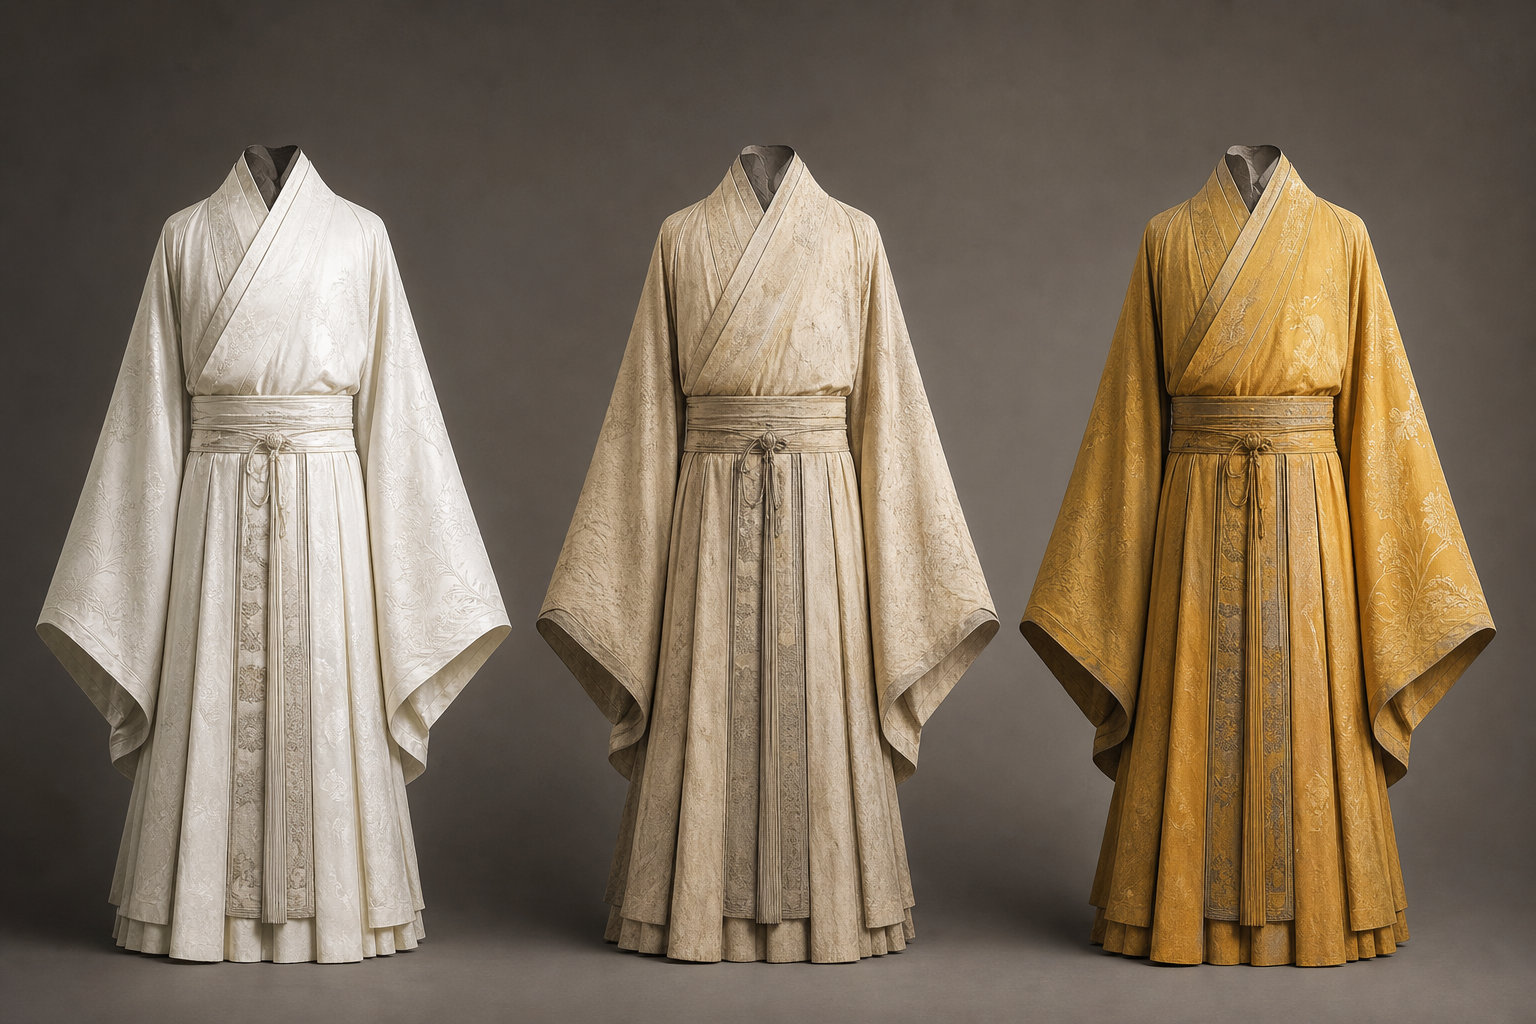
关云长的大袖最典型。它在不同语种里本应是同一件衣服,Ivory 服看着有九成新,台繁服像穿了一年,粤语服又像刚从干洗店取回来。线稿没变,深度图也没变,衣料却成了三种状态。
常见的 lineart 加 depth ControlNet 能锁住姿态和空间关系,管不到棉麻纹理、磨损程度和金属表面。单张看都像完成稿,排在一起才露馅,这类漂移反而最难抓。
先把角色名改成模型能执行的描述
生成侧不再直接读取“關雲長·龍膽”这样的显示名,而是先让轻量 LLM 拆成 {身份词, 典故词, 视觉提示词}。
以“龍膽”为例,生成描述被展开成 gentian flower pattern + blue-violet herb + mountain ridge silk texture,再送入 Midjourney v6.1 和 SDXL 1.0。处理后,两条分支对角色名的语义漂移都明显减轻。
这一步看着朴素,却解决了一个关键错位:本地化名字负责让玩家读懂,图像模型需要的是能落到颜色、纹样和材质上的信息。
2025 年 5 月 27 日发布的首届舜禹游戏工作坊现场整理提到,AI 加速进入语言服务行业后,人类译者在流程中的作用正在从语言转换向更多判断环节延伸。放到这个项目里,译者还得补上典故边界和可视化解释,单交一张名字表已经不够用了。
三层控制栈,各管一件事
名称处理稳定后,出图流程被拆成三层:
- 线稿层:复用欧服线稿,通过 lineart ControlNet 锁住姿态和轮廓;
- 深度层:使用同一份深度图,控制人物与道具的位置;
- 材质参考层:截取独立材质样张,例如关云长袖底的粗糙棉麻,交给 IP-Adapter Plus。
材质 LoRA 负责再加一道保险。每个角色训练一个对应材质的 LoRA,文件名按 {role_id}_{material}.safetensors 归档。例如 char_001_silk.safetensors,对应项目里的“布衣战痕”材质。
切换语种时,流程按角色调用相应 LoRA,提示词只调整少量与地区版本有关的描述。衣料纹理和磨损状态主要由材质样张与 LoRA 控制,语种词不再牵着整张图乱跑。
Keywords Studios 的游戏本地化工作流程自动化实用指南把重点放在工具接入的时机和流程位置。这个项目也是同样的思路:线稿、深度、材质和语种提示分别管一类变量,避免所有压力都堆在 prompt 上。
CI 先筛一轮,别等人眼找细缝
每个资产位生成 3 张候选,随后进入感知哈希、LPIPS 和 CLIP 图文对齐检测。项目内部在 alpha 阶段使用的条件是:
p_hash > 0.92 && lpips < 0.18 && clip_score > 0.27
只有同时满足三项条件的图片才会保留,其余直接打回重抽。这些数值是本项目的回归门槛,不宜直接当成其他项目的通用标准。
在 RTX 4090 单卡上,单张图完成这一轮检测约需 1.4 秒。按项目里的人工对比速度计算,自动筛查接近快了 10 倍。它最有用的地方,是能提前揪出那些构图没坏、人物也没变,只有衣料和纹样悄悄偏掉的图。
显存账里,3,255 指的是资产位
实测环境为 2 张 RTX 4090,总显存 48GB;软件使用 ComfyUI 0.3.36,模型为 SDXL 1.0 base,并加载 2 个 LoRA。
- 单角色生成 5 类资产,每类包含 3 张候选,平均耗时 11 分钟;
- 三个中文版本、217 个角色、每人 5 类资产,对应 3,255 个资产位;候选图在每个资产位上另算一层;
- 一轮批处理的单卡满载时长约 17 小时;
- 任务记录的显存峰值为 31.2GB,主要出现在双 LoRA 与三层控制栈同时加载时;
- 按项目内部口径,整体返工率从首轮 41% 降到 9%,剩余返工大多来自单一语种的服装纹样失配。
这组数据只能说明当前模型、分辨率和节点配置下的成本。换模型或减少候选图,耗时与显存都会随之变化。
跑完这轮,留下几条硬规矩
- 角色名进模型前先拆语义。 “龍膽”“火燄”“八陣”不适合直接拿去生成,也别只靠负向提示词回避。先拆成身份、典故和视觉词,模型才知道该画什么。
- 材质要有独立锚点。 衣料磨损、铜器包浆和服装纹样都需要单独控制。风格参考图只能管大方向,细节还得靠材质样张与 LoRA。
- 视觉回归要和批量出图一起跑。 alpha 阶段可以通过返工校准阈值,到了公测前,这类跨版本漂移应该尽量拦在 CI 里。
下一轮计划扩到韩语和越南语。按当前方案,越南语更棘手:名字仍会牵涉汉字读音,服饰参考却要完全本地化,材质 LoRA 需要重训。
提示词会跟着语种变化,这套分层控制结构可以继续沿用。