2024年2月,Sora第一次亮相时,外界最容易记住的是“文生视频”的冲击感。到当地时间12月9日晚些时候,Sora正式开放给美国及大多数其他国家用户访问。智源社区整理的信息显示,它被纳入ChatGPT Plus和ChatGPT Pro订阅,不需要额外付费;Plus可生成最多50个高级视频,最高720p、5秒;Pro可生成最多500个高级视频,最高1080p、20秒,并支持去水印。
这组限制很重要。它提醒创作者:Sora上线后,短视频生产并没有直接变成“一句话出成片”。更现实的用法,是把视频拆成一组短镜头,再用工作流管理脚本、分镜、角色、转场和声音。
至于标题里常被提到的“Sora 3”,目前可引用资料里没有公开、可靠的信息能证明这个版本已经发布。下面讨论的,是基于已公开的Sora能力,以及可灵、即梦、Vidu等视频模型竞争背景下,短视频创作者可以搭建的工作方式。
先把剧本拆成镜头,不要急着丢进生成框
很多人第一次用视频生成工具,会直接输入一段完整文案:人物是谁、地点在哪、发生了什么、氛围要怎样。结果通常不稳定。画面可能好看,但镜头顺序、人物动作和叙事重点很容易跑偏。
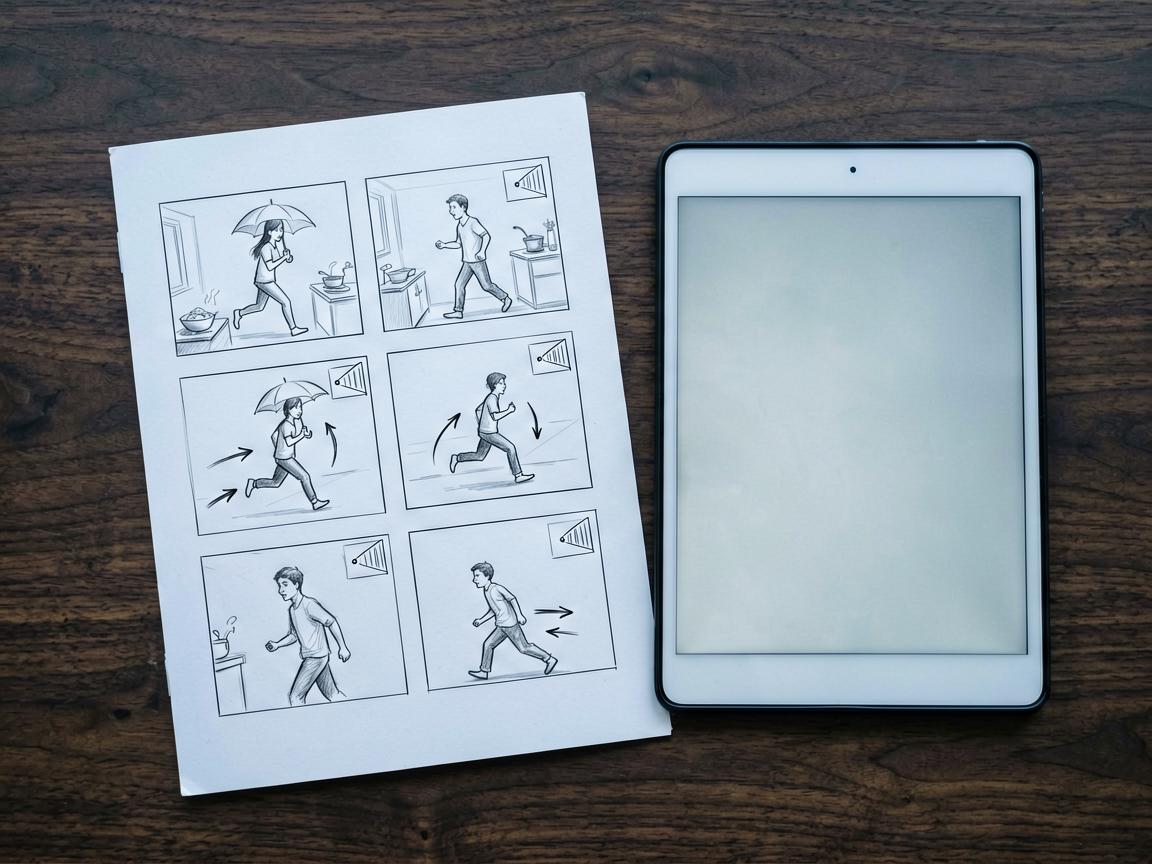
更稳的做法,是先把脚本改写成分镜表。每个镜头只解决一件事:场景、人物、动作、机位、光线或情绪。比如“雨夜街头,主角撑伞奔跑”这类描述,可以拆成几项:
- 场景:雨夜城市街道,地面有积水,霓虹灯反射
- 人物:主角撑伞,快速穿过街口
- 镜头:低角度跟拍,略带手持晃动
- 动作:跑步、踩水、水花溅起
- 光线:冷色调,霓虹高光明显
这一步可以交给大语言模型辅助,也可以手动完成。关键不是把提示词写得多华丽,而是让每个镜头有清楚边界。CSDN一篇关于Sora商业化路径的文章提到,提示词工程不应只是堆形容词,而要建立时间和空间坐标。这个判断放在短视频里同样适用:时间、动作、镜头关系越清楚,后面的生成和剪辑越容易收口。
如果你使用ComfyUI一类节点式工具,它更适合作为“编排台”:上游接脚本解析,下游接视频生成、补帧、调色和音频对齐。不要指望某个单一模型替你完成全部判断。
角色一致性,要单独当成一道工序
短视频最怕的不是画面不够精致,而是同一个人物在不同镜头里像换了演员。第一镜头长发,第二镜头短发;上一秒脸型偏圆,下一秒五官又变了。对剧情类、口播类、虚拟人账号来说,这比画质低一点更伤观看体验。
所以角色一致性不能放到最后补救。它应该在分镜生成前就设好“角色锚点”。常见做法包括:
- 为主要角色准备固定参考图,明确发型、服装、年龄感和面部特征
- 在每个分镜提示里重复角色核心描述,避免模型自由发挥
- 使用IP-Adapter、ControlNet等工具时,把角色参考、姿态约束和镜头要求分开处理
- 每生成一组镜头,就先检查人物是否偏移,再继续生成下一组
这里不建议迷信某个固定参数。不同模型、不同素材、不同画风下,权重设置都可能变化。更可靠的流程是:先用低成本方式快速预览,再决定是否重绘。短视频创作的时间往往耗在返工上,角色越早锁定,后期越少补洞。
杨小康在谈Sora时提到,它代表了大模型在理解和模拟真实世界方面的重要突破。这个判断可以解释为什么视频生成令人兴奋;但落到创作者手里,还要面对很具体的生产问题:人物能不能连续出现,动作能不能接上,镜头之间会不会跳。
每个镜头短一点,反而更好控
Sora Pro公开信息里提到的视频时长上限是20秒,Plus是5秒。这个数字对短视频创作者有直接启发:不要一开始就追求长镜头。尤其是剧情号、知识口播、产品展示号,更适合把内容拆成若干短镜头,再在剪辑阶段组织节奏。
短镜头有几个好处:
- 画面错误更容易定位
- 不满意时只需重生成一个片段
- 人物一致性更容易维持
- 剪辑点可以配合旁白、音乐和字幕重新调整
这也解释了为什么“分镜即成片”不等于“脚本一键变成完整视频”。更准确地说,它是把脚本变成一组可生成、可检查、可替换的镜头资产。最终成片仍然需要剪辑逻辑。
在ComfyUI工作流里,可以把每个分镜当作一个独立节点输出。生成后,再进入补帧、转场、调色和音频同步。RIFE、FILM这类插帧工具可以用于平滑部分运动,但不要指望它解决叙事问题。两个镜头如果本来就不连贯,补帧只会让问题看起来更“顺滑”。
转场别只靠特效,先看动作能不能接
很多AI视频看起来像幻灯片,原因不是没有转场,而是镜头之间没有动作关系。上一镜头人物向左跑,下一镜头突然正面站定;上一镜头是夜景,下一镜头变成白天;上一镜头还在室内,下一镜头已经到了街上,但中间没有交代。
处理方法可以简单一些:
- 每个镜头的最后一帧,尽量为下一个镜头留动作方向
- 相邻镜头保持人物服装、环境色和光线方向接近
- 切换点放在动作完成、音乐重音或人声停顿处
- 必要时增加一个过渡镜头,比如推门、转身、抬头、穿过街口
Whisper等音频分析工具可以帮助找人声停顿点,但创作者仍要决定哪里该切。短视频不是技术演示,观众关心的是信息有没有推进、情绪有没有接上。
一套更稳的创作顺序
如果只保留一条工作流,可以按这个顺序走:
- 写完整脚本,先确定主题、人物和结尾
- 把脚本拆成分镜,每个镜头只描述一个动作或信息点
- 为主要角色准备参考图和固定描述
- 逐镜头生成视频,不满意就只重做该镜头
- 检查人物、服装、场景和动作方向是否连续
- 做必要的补帧、调色和转场
- 根据旁白、音乐和字幕重新剪节奏
这条流程并不神秘,但它比“把整段文案扔给模型”稳定得多。Sora、可灵、即梦、Vidu等工具会继续竞争,创作者真正要积累的,是把想法拆成镜头、把镜头组织成叙事的能力。
AIGC相关论文和行业讨论里常说,文生视频会提高视频生产效率,也会让制作过程更规范。对自媒体创作者来说,这句话可以翻译得更朴素:以前很多时间花在拍摄和找素材上,之后会有更多时间花在分镜、筛片、重绘和剪辑判断上。
工具变强以后,偷懒的空间未必更大。只是同样一个选题,过去要先找场地、约人、拍摄;现在可以先用分镜跑出样片,看叙事是否成立。能不能成片,最后还是看镜头之间有没有逻辑。