长上下文服务一上压力,先吃紧的常常是 KV Cache。模型生成时需要保留注意力计算用到的键和值;输入越长、并发越高,这部分缓存越大。显存还有余量,服务却接不进新请求,问题往往出在内存怎么分、怎么收,而不只是 GPU 算力。
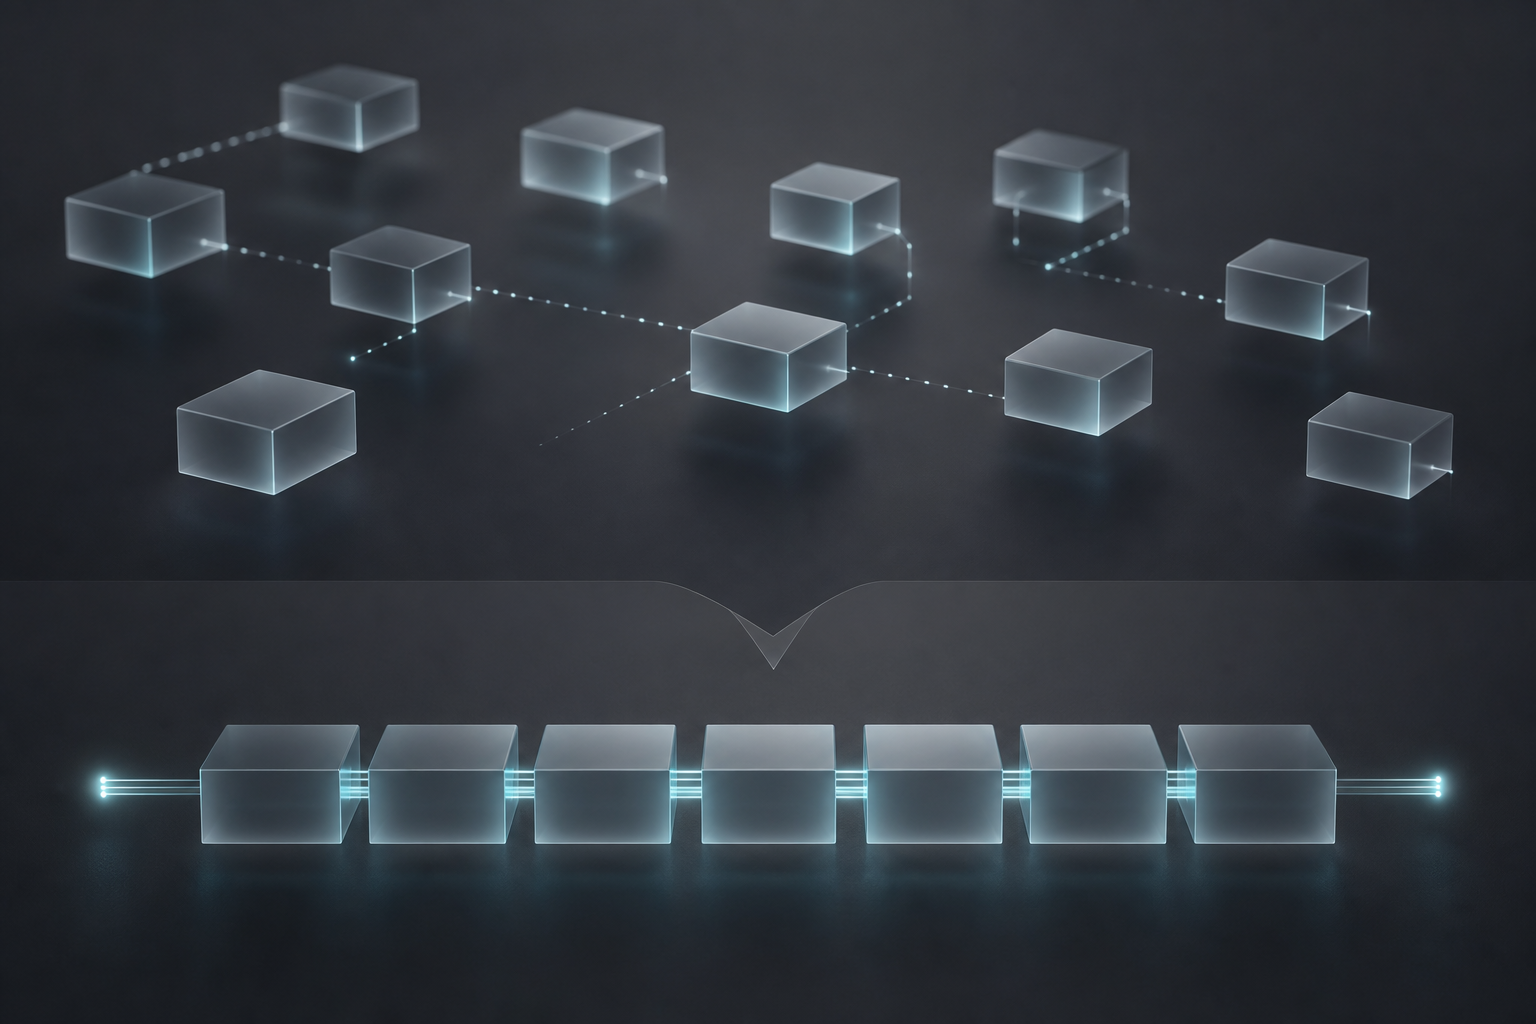
2024 年 7 月 20 日,53AI 对 vLLM 的介绍把 PagedAttention 概括为一种受操作系统虚拟内存和分页技术启发的注意力算法。逻辑上连续的 K/V 数据,不必挤在一段物理连续内存里,可以分散到不同分页中。
vLLM 在此基础上加入块级内存管理和抢占式请求调度,并支持请求之间灵活共享 KV Cache。该文的说法是,这套机制可以把 KV Cache 的内存浪费压到接近零。
把缓存切成块,价值在调度
可以把 PagedAttention 理解成给 KV Cache 做了一套页表。上层看到的仍是一段连续序列,底层拿到的却可以是分散的内存块。请求增长时继续分配块,请求结束后再释放,不必提前占住一整段连续空间。
低碎片最终会变成可用容量,让调度器有机会容纳更多活动序列。请求长度差异越大,这种灵活分配越重要;上下文变长后,KV Cache 占用上升,内存管理的影响也会更明显。
北京智源社区 2024 年 12 月 3 日发布的文章提到,PagedAttention 在 2023 年提出。它是 vLLM 持续演进的性能基础,不宜被包装成某次更新突然出现的单点功能。
128K 没有统一拐点
把 128K 写成通用的性能分水岭,结论过于绝对。实际拐点会受到模型结构、计算精度、GPU 显存、并发量以及输入输出长度影响。同样的上下文长度,换一套请求分布,TTFT 和吞吐量就可能出现不同结果。
现有可引用材料也无法核验“2026 年 6 月发布 vLLM 0.9”“PagedAttention v2”“256K 场景吞吐提升 40%”以及 --block-size-dynamic 等说法。没有版本说明、测试脚本和原始日志,这些内容不适合作为发布结论。
更稳妥的判断是:长上下文会放大 KV Cache 管理的重要性,但不存在一个脱离硬件和负载仍然成立的固定提速比例。
24 倍、2.7 倍,应该怎么读
北京智源社区文章标题中的原话是“最新版本吞吐量再提高 2.7 倍,延迟减少 5 倍”,摘要还提到,与 Hugging Face Transformers 相比,吞吐量提升 24 倍。Kaitchup 的相关文章也以“24 倍推理速度”为标题。
这些数字说明了 vLLM 的性能潜力,但不能直接搬进生产预算。现有摘要没有给出完整测试条件,模型、硬件、序列长度、并发方式和采样配置都可能改变结果。公开数字适合用来定位技术方向,最终容量仍要靠自己的工作负载验证。
上线前,把测试条件锁死
评估 vLLM 时,至少要保证两组测试使用相同的模型、精度、硬件和服务参数。输入长度与输出长度要分开记录,短请求和长请求也应分别测试,避免一个平均值掩盖延迟波动。
同时观察这些指标:
- 首字延迟 TTFT 与整体吞吐量;
- KV Cache 占用、峰值显存和请求排队时间;
- 不同并发下的延迟变化;
- 前缀缓存是否真的匹配业务中的重复请求。
最大上下文、显存利用率和前缀缓存适合分别做单变量测试,具体参数名与可用范围以所安装版本的官方文档为准。如果业务中的大多数请求达不到极限长度,就没必要为了规格数字牺牲日常并发。
vLLM 的看点可以说得很实在:PagedAttention 用分页和块级管理减少 KV Cache 浪费,vLLM 再通过调度与共享把节省下来的显存转化为服务容量。长上下文让这套机制更重要。至于能快多少,答案应该来自当前版本的发布说明和可复现测试,而不是先写进标题的百分比。