B300 卡还在排产,国产千卡已经按周验收
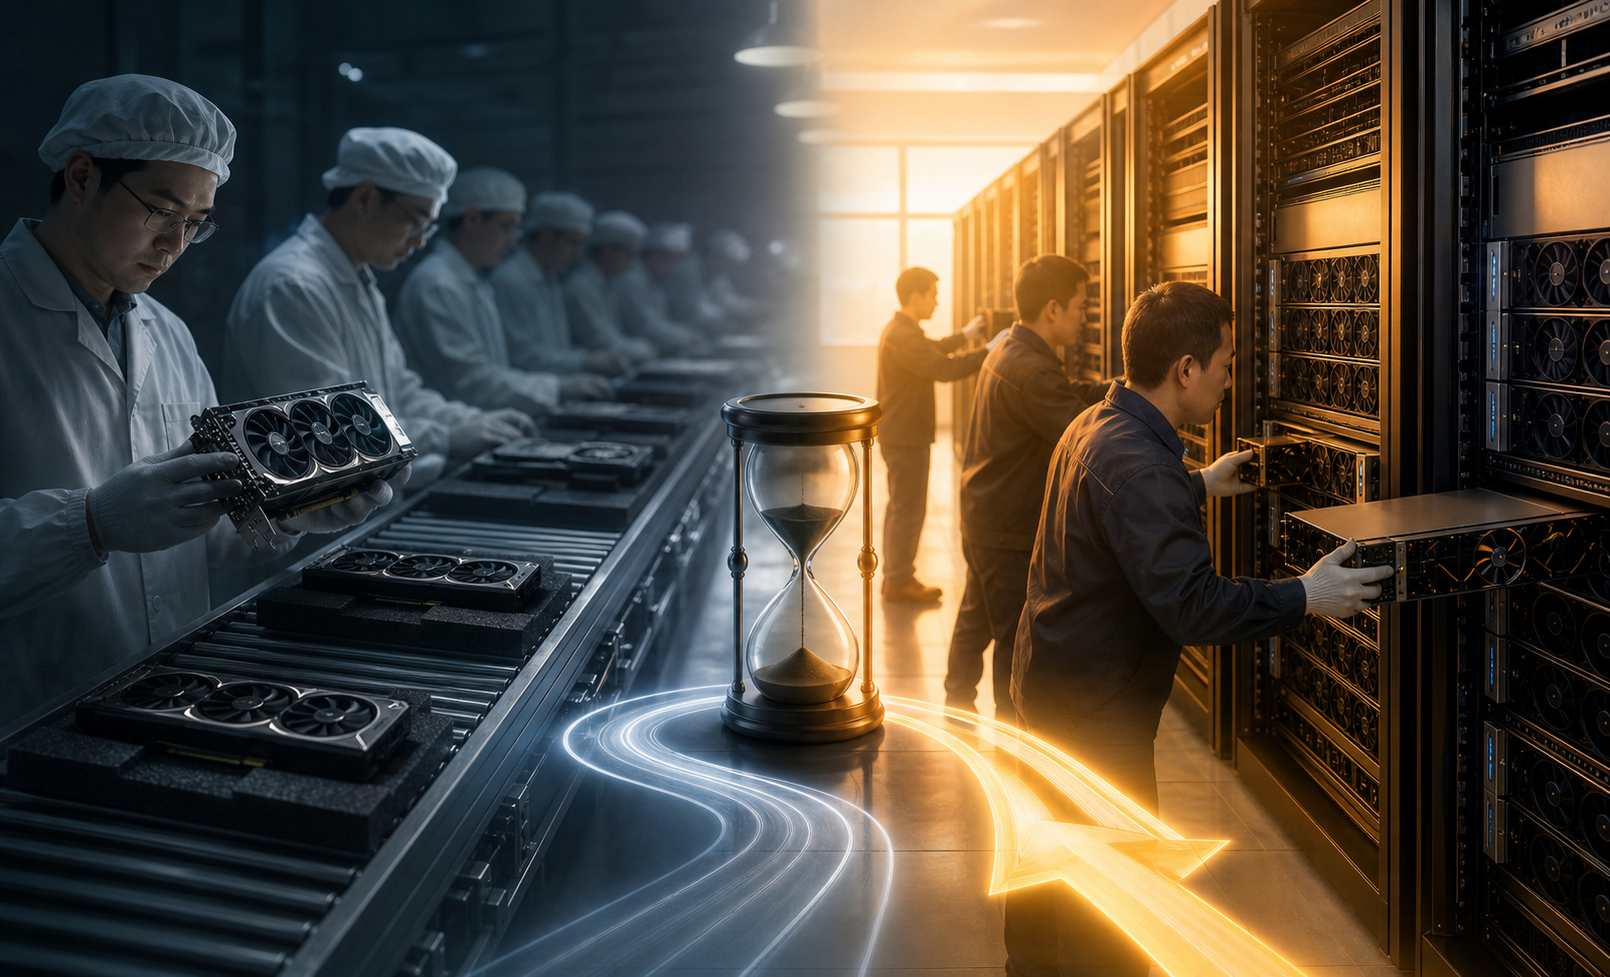
2026 年中算力市场最大的反差,是英伟达和国产阵营在同一时间窗里做出了两套完全不同的承诺。
英伟达 B300 系列从 2026 年初开始放量,但因为 CoWoS 封装、HBM3e 供应和服务器机柜交付节奏的限制,B300 在国内大型客户手中的实际到货周期依然卡在 14–20 周,部分订单甚至要排到 2026 Q4。中国信通院《算力发展指数蓝皮书》披露的算力调度数据也显示,2026 上半年一线城市智算中心的 SXM 整机柜交付平均等待时间比去年底又拉长了 3 周左右。
与此同时,国产侧在 2026 上半年集体提速。据中国工业报援引 IDC 2026 年 4 月《2025 年度中国云端 AI 加速器市场报告》,2025 年中国市场 AI 加速卡总交付 400 万片,国产上升到 165 万片、份额 41%,英伟达 220 万片降至 55%。华为昇腾、阿里平头哥、百度昆仑芯三家在 Q2 集中发布新一代芯片和超节点方案,千卡级别集群的交付周期被压缩到 6–10 周,单价相对 B300 整机柜便宜 25%–35%。
对买方来说,这意味着季度预算不能只看 GPU 单价,得引入"全交付周期成本"这个新维度。
三家采购,账面之外的三笔账
七月上旬,我们分别和一家头部互联网大厂、一家中等规模的具身智能公司、一家做金融大模型的国资云聊了聊。三家 Q3 算力预算都还没最终签字卡死,原因并不复杂。
第一家是互联网大厂,原本希望在 Q3 上线一组 2048 卡 B300 集群用于下一代基模型预训练。按合同,原始报价是“6 月下单、Q3 末交付”。但到了 7 月中,采购负责人发现交付节点可能要推到 10 月底,原因是机柜级液冷板和 800G 光模块的供应被分给了更早下订的海外客户,临时插队基本不可能。结果是,这家大厂把 2048 卡订单拆成两段:先到手的 1024 卡跑实验和 ablation,剩下的等到 Q4 再合并到正式训练任务里。
第二家是具身智能公司,预训练参数量不算大(13B–34B 区间),但对训练—推理一体化的弹性要求很高。他们的策略是 70% 算力搬上一组国产 1024 卡集群做主训练,30% 留在英伟达侧用于关键基线对照。问题是,昇腾 910C 集群从单卡到千卡的运维账并不干净——版本矩阵、HCCL 拓扑、算子验收、数据链路的兼容调试,在《昇腾910C从单卡到千卡:国产算力集群的运维避坑清单》一文里已经拆得很细。这家具身智能公司的反馈是,光是把 PyTorch 训练脚本完整迁过去、并跑通 1000 卡线性度,就花了他们 6 周时间,比预期少了半个月的窗口本来是给模型迭代用的。
第三家是国资云背景的金融大模型团队,路径更保守。考虑到金融数据出域的限制,他们没有选择千卡大规模集群,而是把项目切成若干子任务,用国产 910C 或昆仑芯的 256–512 卡小集群做离线训练,再回到内部推理集群做上线。好处是规避了千卡拓扑和机房电力改造的麻烦,代价是端到端实验周期比同行多了 1.5–2 倍。
三家现场聊下来,三个共同点:
第一,Q3 真实成本里至少有 15%–20% 是被低估的“搬迁移 + 联调”费用,这笔钱不会写在 GPU 报价单里。
第二,国产集群的“算力购买价 / 真实可用算力”账:B300 标称 FP8 算力在量产版上能稳定打出 90% 以上,而部分国产芯片在不同任务下的有效算力折损可以达到 20%–35%,主要出在低利用率算子和通信等待上。
第三,Q3 还有一个被反复提及的变量:电力。夏季迎峰度夏的负荷压力在多地电网调度系统里已经显现出来(参考《16分钟搞定一次故障:电网AI调度员的迎峰度夏答卷》一文),算力中心新建项目的批覆节奏已经从"先建后批"变成"先批后建",直接影响的是下半年扩容排期。
迁移成本里,最贵的是人而不是机器
很多公司在算账时只算硬件和服务费,但真正拉高 Q3 总账的是人和时间。
一家 1024 卡集群的运维至少需要 4–6 名具备 HCCL、拓扑、调度和故障恢复经验的工程师,这类人才在 2026 年的市场价是年薪 80 万–150 万。如果是昇腾平台,相关人力尤其紧俏——此前《8000P算力园区落地一季:排队抢额度的人换了一批》提到的 8000P 算力园区开园三个月,排队抢的客户换了主角,从大厂预训练变成具身智能、垂类模型和出海业务,但挑客户的恰恰是“软硬件联调能力”这一把尺。
另一个隐性成本在数据搬迁。千卡级别的训练数据集普遍在 PB 级别,从对象存储迁到新集群的并行文件系统时,链路带宽和校验开销会让一次完整搬运耗时 1–3 周。如果再叠加合规审查(参考《AI芯片出口管制再升级:初创公司去哪找算力》一文中提到的 H20 出口管制和模型迁移合规问题),迁移真正的开销是项目时间表,而不是存储流量费。
Agent 与端侧,把算力账拆得更细
2026 下半年还有一道变量,是 AI Agent 和端侧模型的扩散。
《五款 AI 写作工具跑了 14 天,采编团队怎么分工》和《70亿参数模型进手机,端侧AI开始考验权限和续航》都提到同一个现象:推理负载不再只压在数据中心的大模型上,而是被 Agent 路由(参考《Agent 选型别押一家,三模型路由怎么搭》)和端侧模型(参考《六款手机端侧大模型实测:能跑不等于好用》)分流。
对算力采购方来说,Q3 预算的切法可能不再是"全买训练卡",而是把训练 / 微调 / 部署三段分别拆开:
- 训练侧优先选国产千卡集群跑主任务,订单按月滚动,避免一次性锁死 6 个月以上。
- 推理侧分两部分:高频低延迟请求走端侧或私有化部署,长尾推理走云端弹性算力。
- 模型路由和 Agent 计费要纳入预算评审(参考《中小企业部署 AI Agent,先把账单和 ROI 算明白》),否则自动重试、长上下文和闲置实例会把账单悄悄抬上来。
Q3 预算切法,三个口径可以照着用
如果你正在准备 Q3 预算核对,可以先用这三个口径自检:
1. 交付口径:写合同的时候不要接受“季度交付”这种模糊描述,要求落到“周级别交付 + 违约金”。B300 类高单价订单尤其要分批交付,国产千卡则把“调试验收完成”作为里程碑付款条件。
2. 算力口径:把“标称 FP8 算力 × 70%–85% 折损 + 通信等待”作为采购时的有效算力基线。折损系数低的是好算力,折损高的需要用更高的折扣来补偿。你自己的训练任务最好先在 256 卡上跑一遍有效算力测试,再决定是否上 1000 卡以上。
3. 人力口径:把 4–6 人的国产集群运维团队、1–2 人迁移工程师的成本提前 6 个月计入预算。被算在“基础设施”里的这部分人力,往往决定项目能不能按时跑顺。
把三本账合在一起算,Q3 的算力预算就不再是“谁便宜买谁”,而是“哪家账算得清、哪家交付能守住约定”。下一次大厂发布会后,参数表依然会被反复比较,但真正能给决策者打分的,是合同里那几行关于交付、折损和人力的细节。