2025年9月16日,华为在深圳发布《智能世界2035》和《全球数智化指数2025》,同时给出面向未来十年的十大技术趋势。发布内容覆盖教育、医疗、金融、制造、电力等行业。华为官方消息
在《智能世界2035》专题页上,华为把判断写得很直接:走向物理世界,是AGI形成的必由之路。物理实体需要与环境实时交互,把感知、认知、决策和行动连成闭环。
有意思的是,报告PDF还列出了一条更克制的路径:AI技术可能进入漫长平台期,行业注意力从追逐通用智能,转向现有大模型的产品化、场景打磨、效率提升和成本优化。
把这两层判断放在一起,问题就清楚了。2035年谈方向,眼下得先补工程。
8000P之后,算力要先变成可用能力
北京8000P算力园区把这种落差摆到了台面上。8000P给出了供给规模,也把运维难度推到更高量级。传统云计算以通用负载为主;大模型训练和推理更依赖高密度芯片、高速互联和长时间稳定运行。再往具身智能走,算力还要从园区延伸到机器人、穿戴设备和各类边缘终端。
1000颗昇腾910C完成DeepSeek-V4-Pro的全参数后训练,是一个看得见的规模。到了这个量级,工程师每天遇到的往往是HCCL通信报错、Rank映射错位和组件版本不兼容。规格表写的是单卡峰值,机房里盯的是通信日志、任务恢复和多卡协同。
千卡、万卡集群能否稳定工作,直接影响上层模型的训练周期。具身智能需要的大模型、视觉模型和控制模型,也要建立在这套基础上。
冷却液和光信号,都是算力账本的一部分
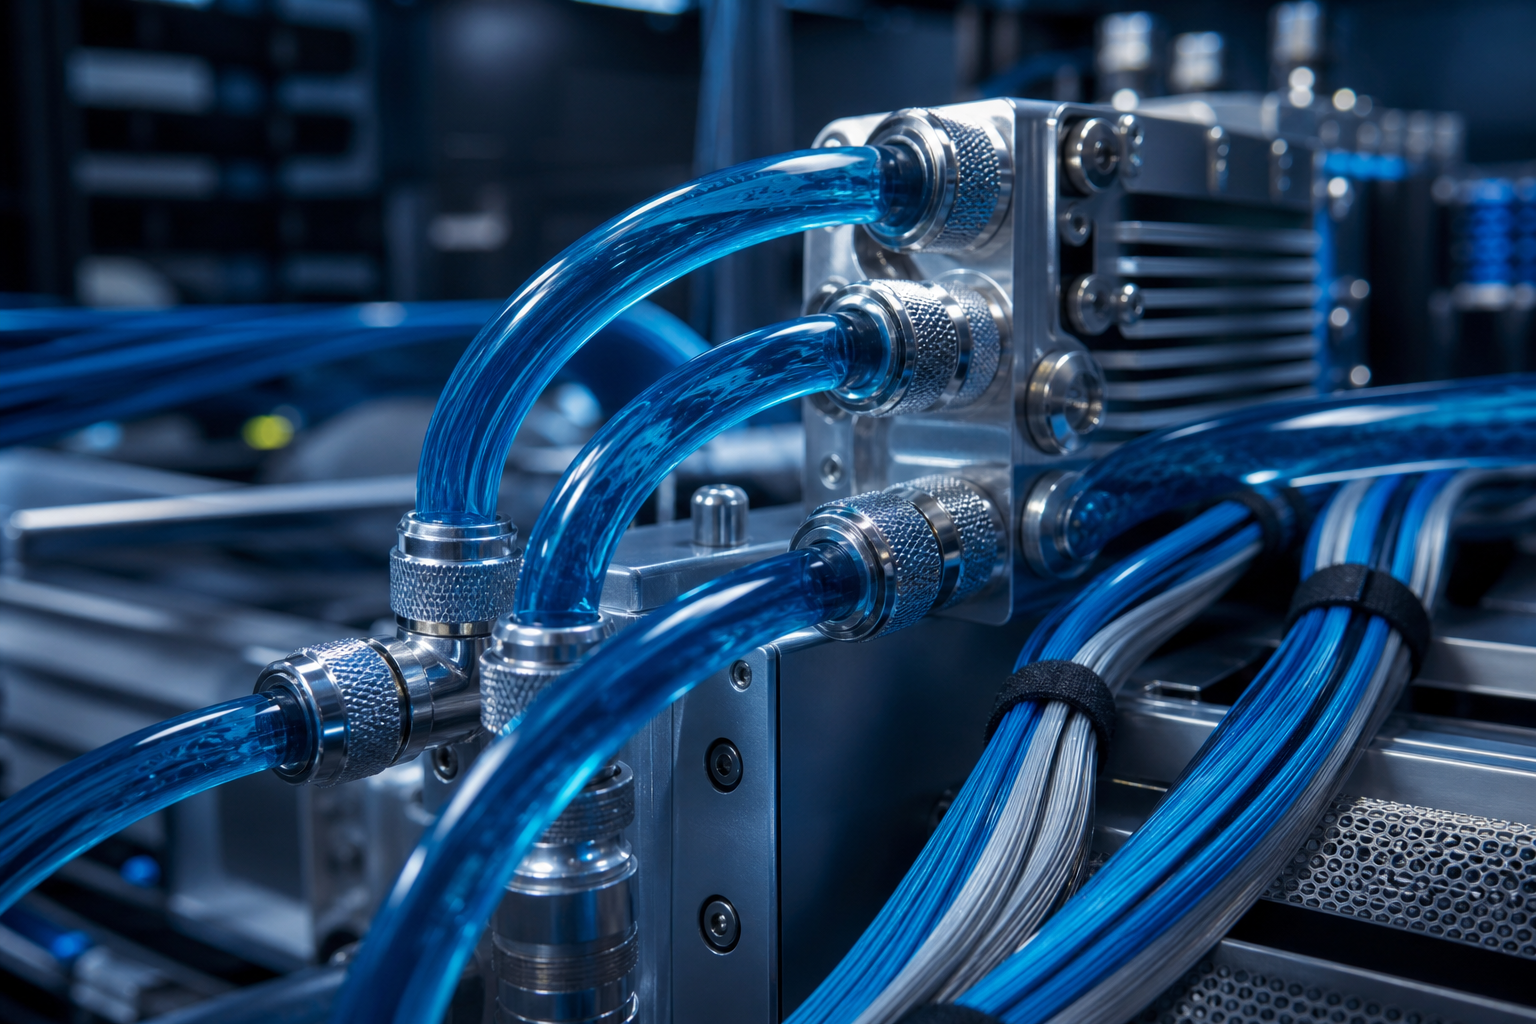
算力密度上去,热也跟着来。液冷影响机柜能够承载的功耗,也牵动PUE和长期运营成本。高速光模块承担节点间的数据交换,模型越大、并行节点越多,通信带宽和延迟越容易成为瓶颈。
在8000P园区里,芯片、液冷、网络和调度必须一起设计。单独优化某一项,很难换来长期稳定的有效算力。
这些部件很少站在发布会中央,却会最先反映在故障、能耗和账单里。
端侧模型为什么反而越做越小
云端集群追求规模,终端设备关心的是另一套问题。在7B参数模型已经能在中端手机运行后,vivo、OPPO、荣耀等厂商仍把注意力放在1.8B甚至更小的模型上。
这不难理解。手机同时受内存占用、首字延迟、机身发热和电池续航约束。1.8B模型更容易兼顾这些条件,也更适合承担高频、即时的本地任务。对服务机器人和智能穿戴设备来说,这种“小钢炮”路线同样实用:数据可以留在本地,网络不稳定时也能维持基本的感知和决策。
云端继续承担大规模训练和模型更新,边缘端负责高频感知与即时响应。NPU、模型压缩和软硬件协同,决定了这套分工能否成立。
走出模拟器,才算进入物理世界
BIGAI研究院的技术链条提供了一个具体观察窗口:SceneVerse++用于生成3D场景,TongSIM提供物理训练环境,OmniXtreme连接机器人的动作输出。从理解环境、模拟物理过程到执行动作,这条链最终还要在真实空间里接受检验。
模型能否理解场景,只完成了前半段。机器人能不能稳定移动、抓取和执行任务,取决于感知、决策与动作系统是否接得上。华为所说的“走向物理世界”,落到这里就是一个个具体接口和一次次真实测试。
产品化的工作,往往很碎
行业模型也遵循同样的逻辑。盘古大模型5.0落到电力场景,工作很快会细化为数据清洗、过拟合与灾难性遗忘处理,以及边缘设备上的推理延迟优化。MCP协议接入企业微信,则要处理会话上下文同步和权限继承。
这些问题听起来不够宏大,却直接决定系统能否上线、能否长期运行。报告所说的效率提升和成本优化,最终都要在这些细节里兑现。
全栈能力最后要接受同一套检验
从昇腾、MindSpore到盘古大模型和鸿蒙终端,华为试图连接数据中心、模型、设备与物理空间。这套组合的价值,取决于几项很实际的结果:集群能否稳定扩展,液冷与光互联的成本能否控制,模型能否压到终端,机器人能否在真实环境完成感知和行动闭环。
2035年,AGI是否能够通过物理实体实现所谓“行知合一”,现在还无法下结论。眼前已经有几道具体的题:8000P园区能否持续输出有效算力,1.8B模型能否在设备上稳定运行,机器人能否把模拟器里的动作带进真实空间。
答案将先出现在机房、手机和机器人上。