2026 年的内容创作现场,单纯会聊天的 AI 助手已经不太够用。
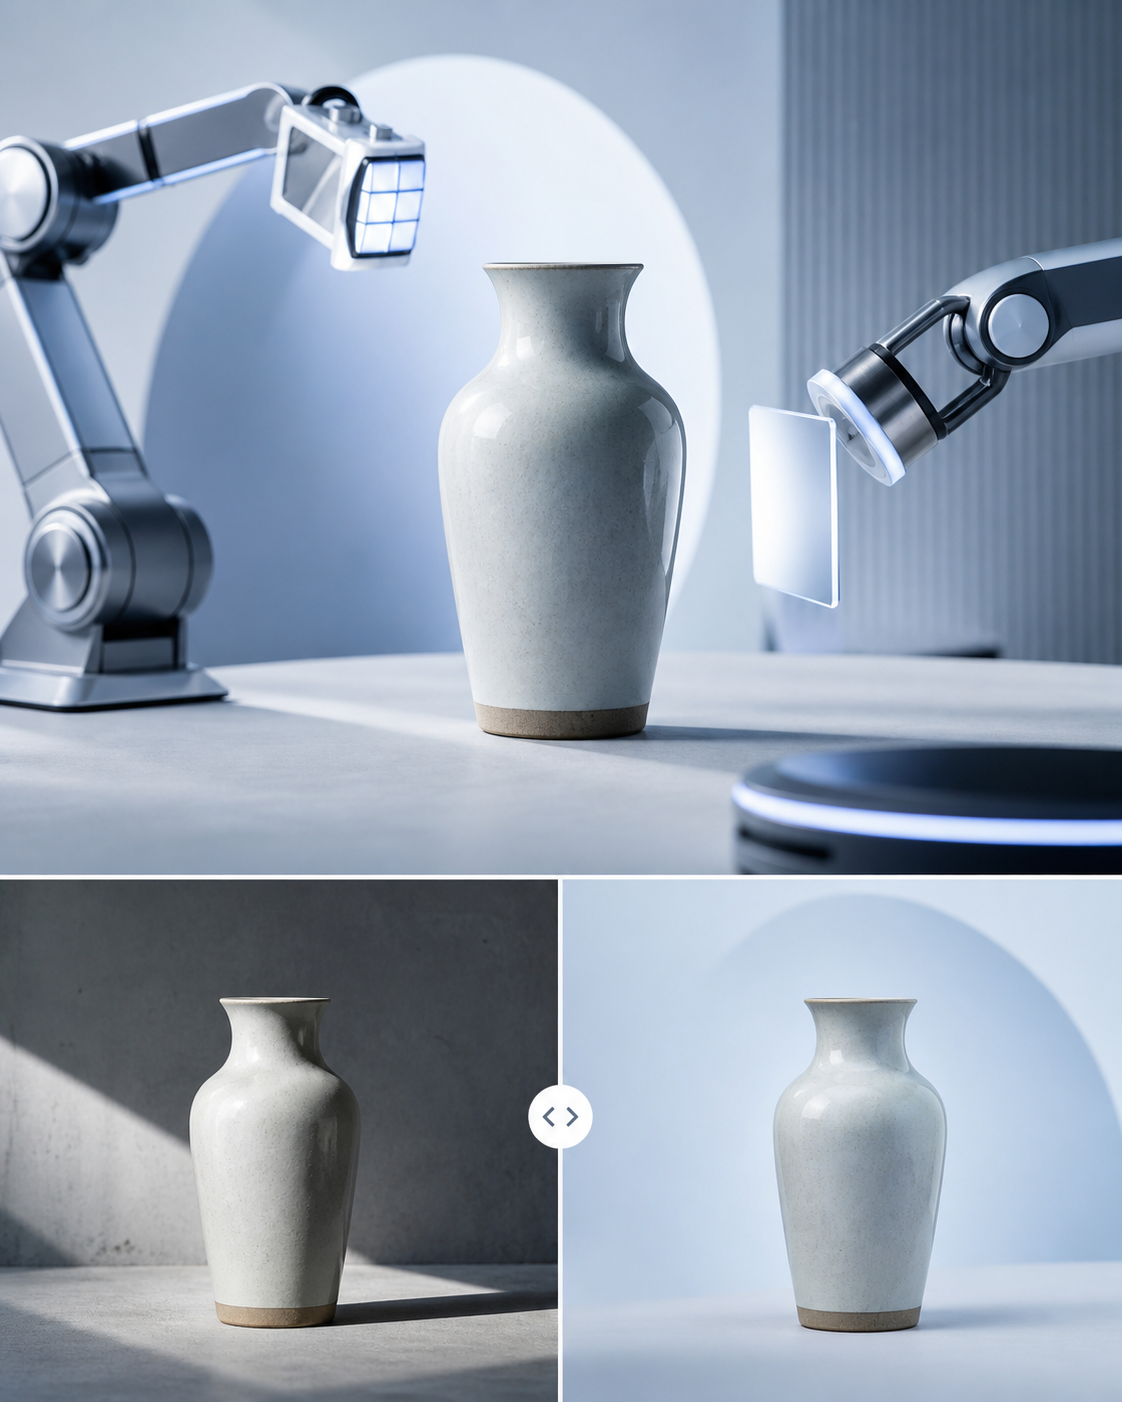
创作者真正想要的,不是再多一段建议,而是它能接着往下做:把一张噪点图修干净,把产品图背景换成统一光影,从一堆视频素材里挑出能用的片段,先拼出一版粗剪。
这也是多模态 Agent 变得有用的地方。它不只处理文字,还要看图、听声音、读字幕,再把这些判断交给工具执行。21 世纪经济报道在 2026 年 6 月关于 AI Agent 的观察中提到,随着大模型推理成本持续下降,AI Agent 正从 Demo 走向产业兑现。放到内容行业里,这句话对应的是一个很具体的变化:AI 不再只是给创作者提方案,而是开始进入修图、剪辑、审核这些重复工序。
聊天框解决不了修图和剪辑
很多人用 AI 做内容,还停在一句话命令:帮我 P 个背景,帮我剪个精彩集锦。
问题是,修图和剪辑都不是一句话能完成的任务。修一张产品图,要先判断主体是什么、光线从哪里来、背景哪里脏、边缘有没有糊。剪一条短视频,要先看画面内容、听情绪起伏、识别字幕和人声,再决定哪些片段可以留下。
小宿科技在讨论多模态 Agent 的行业应用时举过类似问题:财务报表里的图表、工业质检里的高清图像、医疗诊断里的影像胶片,都不是纯文本 Agent 能处理好的对象。内容创作也是一样。只会读文字的 Agent,可以写脚本;能看懂图片和视频的 Agent,才可能参与后期。
所以,多模态 Agent 的关键能力不是“更会聊天”,而是能把内容理解和工具调用串起来。
Midjourney V7 更像素材引擎
以 Midjourney V7 为例,它在创作者工作流里的位置,已经不只是“生成一张好看的图”。更有效的用法,是把它放进一条自动化链路里,当成可调用的素材引擎。
比如,你有一张人物照片,想换成更干净的商业海报背景。粗糙的做法是直接输入“帮我换背景”。结果往往是人物边缘、光照方向、背景透视互相打架。
更稳的做法是先让 Agent 看原图,拆出几个信息:主体是谁,姿态是什么,原图光线偏硬还是偏软,背景有没有干扰物。然后再让它生成结构化描述,交给后续工具使用。
一个简化后的描述可能长这样:
{
  "subject": "red_sneaker",
  "lighting": "harsh_shadow",
  "background": "cluttered"
}
这段 JSON 不负责“好看”,它负责把图像问题说清楚。后面才是调用 Midjourney V7、ControlNet、IP-Adapter 或其他节点,让背景、主体和光照尽量对上。
这比一句自然语言 Prompt 麻烦一点,但对批量生产更友好。尤其是电商产品图、封面图、广告物料这类任务,创作者需要的不是偶然出一张神图,而是同一套视觉规则能稳定复用。
ComfyUI 的价值在于把步骤固定下来
ComfyUI 常被当成画图工具,其实更适合理解成工作流编辑器。
它的优势不在某一个节点有多神,而在你可以把“看图—判断—处理—复查”拆成一组可重复的流程。多模态 Agent 放进来之后,角色也会变得更清楚:它负责判断当前素材该走哪条路径,而不是每次都让人手动选节点。
拿一组产品图来说,常见需求是统一背景、调整色调、去掉杂物。可以拆成三步:
第一步,让 Agent 读取原图,输出结构化画面描述。这里重点不是立刻修图,而是先确认主体、光线、背景问题。
第二步,根据描述组装 ComfyUI 工作流。比如需要保持主体一致,就调用 IP-Adapter;需要局部重绘,就进入 Inpaint;如果主体边缘不干净,再补一个更细的分割或放大步骤。
第三步,把生成结果送回 Agent 复查。它可以检查背景是否还有明显杂物、主体是否变形、色调是否偏离要求。发现问题后,再调整节点参数重新跑一版。
这类流程的好处,是把经验沉淀下来。一个“电商产品图标准化”工作流,一旦调通,就不必每次从零开始。创作者需要做的,是决定哪些结果可用,哪些结果必须重来。
短视频粗剪先交给 Agent 过一遍
视频后期里,最耗时间的常常不是精剪,而是前面的筛素材。
如果手上有 50GB 素材,要做一条 15 秒短视频,人工第一遍通常要做这些事:浏览素材,找人脸特写,标记情绪点,听音频高峰,确认字幕卡位置,再把可能可用的片段拖到时间线里。
多模态 Agent 适合先接这一段脏活。
不要给它一句“帮我剪一个精彩集锦”。更有效的指令可以写得具体一些:
分析这批视频素材,识别包含“人脸特写”“高光打斗”“字幕卡”的片段;结合画面动作、音频波形和转录文本,按“快节奏、强冲突”的方向排序;选出前 20 个候选片段,在片段之间预留 0.5 秒转场位置;输出可导入剪映专业版或 Premiere 的工程文件。
这里的重点不是让 Agent 一次剪出最终成片,而是让它先把可用素材捞出来,并把粗剪结构搭好。后面节奏要不要更快,某个表情是不是过火,转场是否太密,仍然要人来判断。
Premiere、DaVinci、剪映专业版这些工具本身依然重要。变化在于,Agent 可以站在它们前面,先完成识别、筛选和初排。创作者不必把大量时间花在“找素材”上。
自动化也要把版权检查放进去
内容生产自动化之后,一个容易被忽略的问题是合规。
Agent 能批量拼接素材,也可能批量放大风险。水印、敏感人物面部、版权不明的镜头、平台不欢迎的元素,如果在粗剪阶段没有标出来,后面越接近发布,返工成本越高。
因此,视频工作流里最好把检查步骤前置。让 Agent 在输出工程文件前,先标记可能有风险的片段;如果素材库里有可替代素材,再给出替换建议。它不应该只负责把片子剪快,也要帮助创作者知道哪些地方可能不能用。
这一步不一定完美,但比人工在最后发布前才发现问题要好。
创作者要学会写工作流,而不是只写 Prompt
多模态 Agent 对内容创作者的要求,其实比聊天机器人更高。
只会写一句漂亮 Prompt,不够。你还要知道任务怎么拆:哪些步骤交给视觉识别,哪些步骤交给生成模型,哪些步骤交给 ComfyUI 节点,哪些步骤必须人工确认。
比较实用的做法有三个。
先把高频任务模板化。比如产品图统一背景、口播视频粗剪、短剧推广素材初筛、封面图批量改版。每个任务都写清楚输入、处理步骤和输出格式。
再把 Prompt 结构化。自然语言适合表达审美,JSON 适合传递参数。让 Agent 输出主体、光线、背景、镜头类型、情绪强度这类字段,后续工具更容易接上。
最后保留反馈回路。不要让 Agent 只生成一次就结束。你可以给出“颜色太艳”“人物边缘不干净”“节奏太慢”这样的反馈,让它回到对应节点重新处理。
多模态 Agent 真正有价值的地方,就在这个闭环里:它看得懂素材,能调用工具,也能根据反馈再跑一遍。
内容创作的门槛不会因为 Agent 出现就消失。审美、判断、取舍仍然是人的工作。但修图、粗剪、整理素材、生成候选版本这些重复环节,已经可以被重新分配。谁先把工作流搭起来,谁就能少耗一点时间在机械操作上,把精力留给真正决定作品质量的部分。