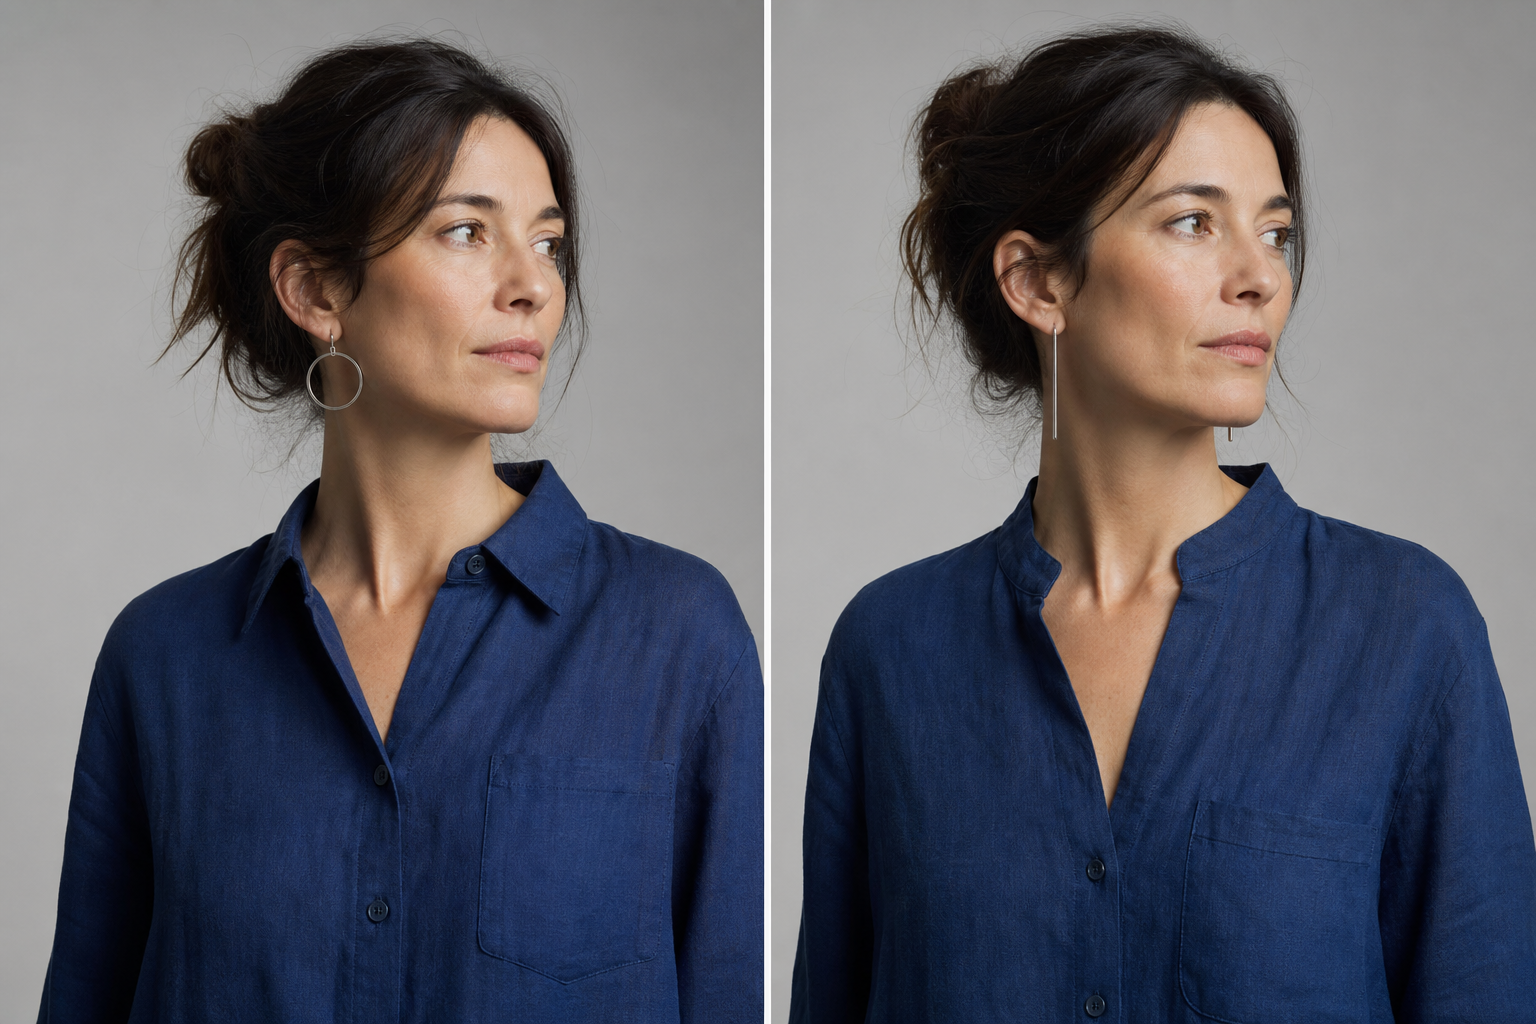
一次6分钟的Sora 3短片测试里,主角第1分钟还穿着深蓝色亚麻衬衫,左耳戴着圆形耳钉。到了第4分钟,她侧身转过镜头,领口形状悄悄变了;第5分钟切到特写,圆形耳钉又被拉成了细长条。
单看每一帧,画面都说得过去。连起来看,穿帮了。
视觉工业把这类问题称为连续性错误(Continuity Error)。放到AI视频里,背后对应的是Temporal Coherence,也就是时间一致性。Sora 3和Runway Gen-4已经把单镜头画质推到更高水平,接下来更难的一关,是让角色、服装和场景在几分钟后仍保持原样。
五分钟后,模型开始忘事
目前的视频生成模型大多基于Diffusion Transformer(DiT)。模型在潜空间(Latent Space)里处理视频特征,通过多轮预测逐步还原画面。面对10秒短片,注意力机制(Attention)通常还能照顾到前后帧之间的细节;时长拉到5分钟,也就是300秒,视频Token快速累积,计算量和显存压力随之上升。
《128K合同实测》讨论过长文本的显存优化逻辑,但视频负载更重:每一帧都是高维张量。即便采用类似Mamba-3的线性复杂度架构,长时依赖仍可能发生注意力漂移。
模型并没有保存一份可随时查阅的角色档案,也没有一张始终稳定的场景地图。上下文越长,早期细节的权重越容易下降。它会根据当前几帧重新猜测接下来的画面,于是角色慢慢换脸,镜头转回房间后,原来的窗户也可能消失。
5分钟并非模型突然失效的硬开关,更像一条工程警戒线。错误会随时长累积,返工范围也越来越大。正如《别追“Sora 3”,影视公司先把分镜这一步做实》所讨论的,如果角色连5分钟都无法保持稳定,这类工具就更适合生产概念镜头,还难以独立执行完整剧本。
给场景搭一副看不见的骨架
包括OpenAI和Google DeepMind在内的实验室,正在尝试把3D先验(3D Priors)引入2D视频生成。工程上较直接的组合,是3D Gaussian Splatting(3DGS)加扩散模型。
这套流程分成几个动作:
- 先把场景定住:生成前,用少量关键帧通过3DGS重建简易点云,作为整段视频的空间底图。
- 生成时持续对齐:每一帧的像素都要参考这张底图。窗户、墙面或家具位置发生偏移时,损失函数(Loss Function)会把结果拉回原来的空间坐标。
- 让移动物体带着三维外壳:动态高斯球(Dynamic Gaussians)跟随角色移动。镜头旋转后,面部特征点在三维空间里的相对位置仍有参照。
3DGS收窄了模型自由发挥的空间。它尤其适合处理房间结构、物体位置和镜头回转后的场景复现。不过,空间稳定不等于身份稳定。窗户可以被固定在墙上,人的五官和耳钉仍可能发生细微漂移。
一张脸,需要比Prompt更硬的约束
只靠一句Prompt描述角色,例如“一个有雀斑的30岁女性”,很难撑过几分钟。随着镜头、光线和角度变化,这些文字条件会逐渐失去约束力。
全量微调成本太高,更轻的办法是给每个角色训练独立的角色锁定LoRA(Character-Locking LoRA)。这类插件通常在50MB至200MB之间。主角A出现时,系统激活Character_A_LoRA,把面部特征重新拉回预设的权重中心。
A与B同框对话时,系统需要同时调度两套LoRA,并在潜空间中进行线性插值,避免两个人的视觉特征互相污染。真正棘手的是切换瞬间:权重变化太快,角色的脸会出现跳变,也就是Popping。现有工程方案会用Sigmoid激活函数平滑过渡,让身份约束逐步进入和退出。
角色LoRA负责锁住“这个人是谁”,3D先验负责记住“这个人和场景在哪里”。两层约束缺一块,长视频都容易露出破绽。
一致性会直接出现在算力账单上
3D场景需要常驻显存,动态LoRA还要频繁加载和切换。画面变稳了,推理延迟也跟着增加。
《英伟达B200真卡在量产?》提到过Blackwell架构的产能爬坡问题。在相关中型工作室的部署记录中,B200集群加入3DGS实时投影后,有效算力被大量占用,生成速度从1fps降到0.2fps。对制作团队来说,这不只是等待时间变长,还意味着同一预算能完成的镜头更少。
端侧设备更难承受这套流程。iPhone 16 Pro Max和Galaxy S25 Ultra虽然支持端侧AI,但《端侧 AI 手机散热实测》记录的高强度负载下,设备会触发热降频,连续推理20分钟后速度腰斩。把3DGS、扩散模型和动态LoRA同时塞进手机,目前并不现实。
2026年的长视频一致性,本质上仍是在用算力购买稳定性。要求越接近“绝对一致”,需要维持的状态越多,推理就越慢。
别把十分钟押在一次生成上
纯端到端(End-to-End)生成的问题,在于一次漂移就可能污染后续几分钟。更稳妥的制作方式是“生成 + 约束 + 后处理”,把长片拆成可控制、可返工的小段。
- 分镜先拆开:用LLM拆解剧本,确定镜头顺序、角色状态和3D场景锚点。
- 生成时分段:用3DGS锁定空间,用角色LoRA约束身份,每次生成30秒Clip,而不是直接追求一句话生成10分钟电影。
- 后期统一:通过光流法(Optical Flow)和AI补帧缝合片段,再做全局色彩一致性校正。
演示片的单帧惊艳只是起点。角色转身后还能不能认出来,镜头切回时窗户还在不在,返工能否锁定到一个30秒Clip,才是制作环节真正关心的事。
现阶段,AI更像一名效率很高、但仍需要分镜、场记和后期监督的数字摄影师。穿帮未必会彻底消失,但可以从不可控故障,变成能够定位和修正的问题。