Agent 在演示里往往很顺:用户提出需求,模型自己拆任务、查数据、组织答复。接到真实业务后,权限校验、API 超时、字段缺失,以及一句话里混着多个意图,都会让流程停下来。
继续往 Prompt 里添加 if/else,短期能补洞,长期却很难排错。指令越来越长,团队依然说不清是哪一步出了问题,也无法单独重放某个工具调用。
智能体开发者社区对 2026 年 Agent 的梳理提到,OpenAI、Anthropic、微软等企业的产品越来越强调规划、工具调用和复杂流程执行。超智咨询的资料援引 Anthropic 2025 年研究,也把有效 Agent 的能力概括为规划任务、调用工具并完成流程。聊天只是入口,执行链条才是工程难点。
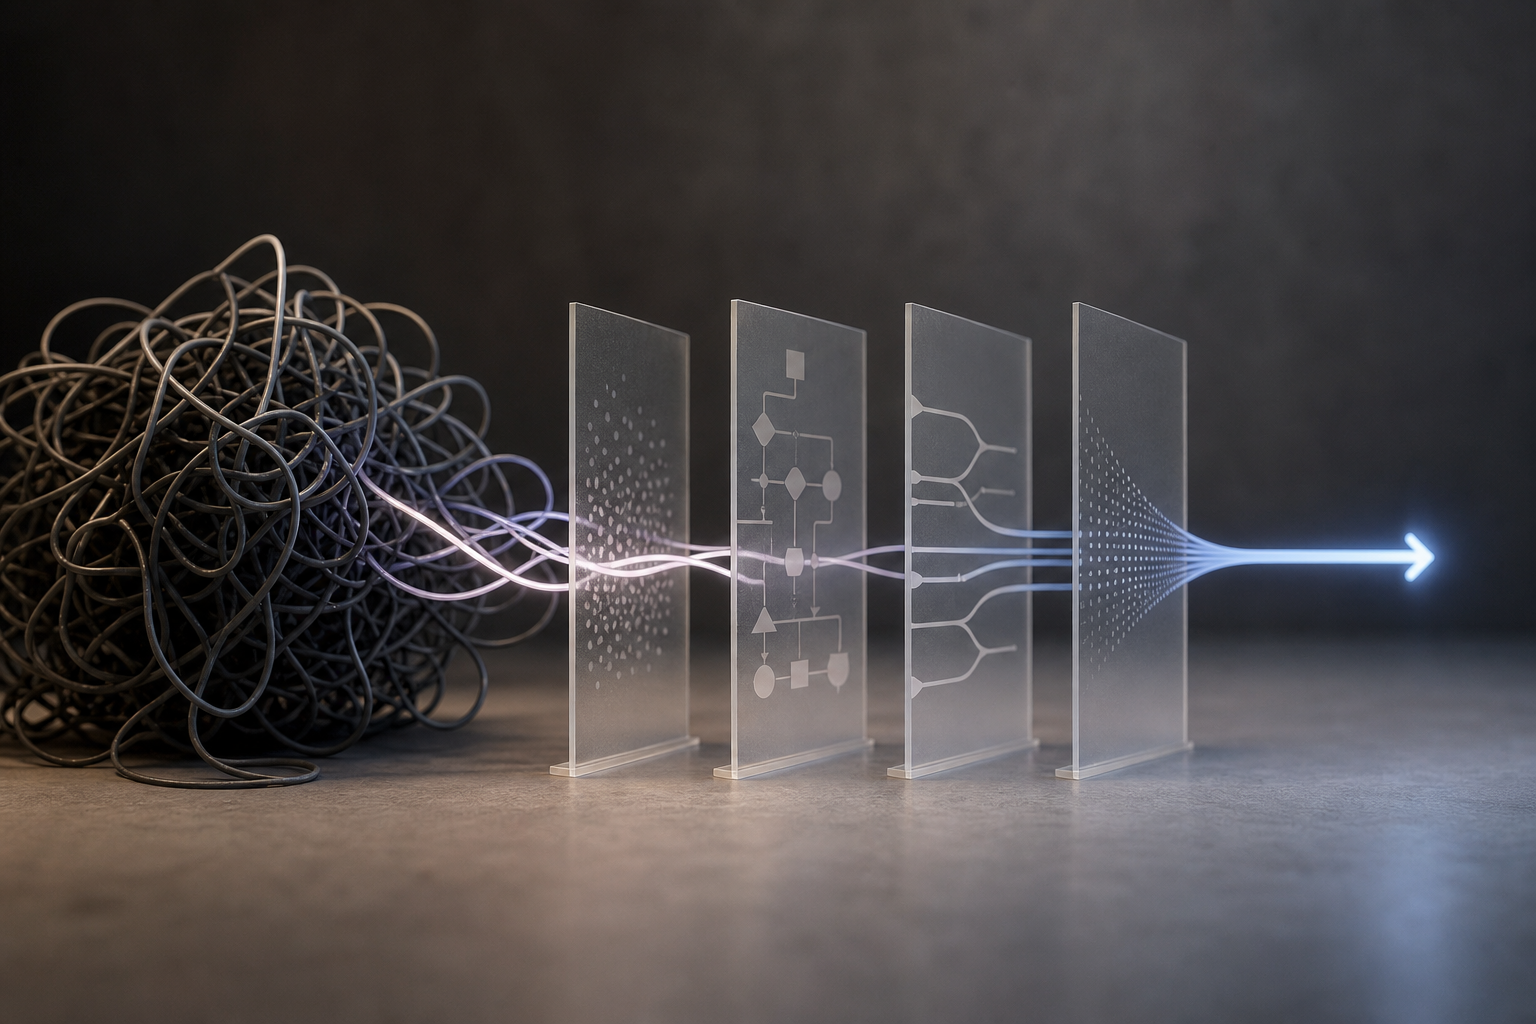
先把一段 Prompt 拆成流程图
拿售后工单作示意,一条可检查的处理链可以写成:
用户输入 → 输入校验 → 意图路由 → 状态机 → 工具/API → 结果校验 → 回复生成 → 日志或人工接管
每个节点只承担一种职责:
- 输入校验:检查订单号、用户身份和必要字段。缺少订单号时,直接追问,不让模型猜。
- 意图路由:把请求归入退款、物流查询、商品咨询或其他预设类别。
- 状态机:根据意图进入对应分支,明确下一步允许调用哪些工具。
- 工具节点:查询订单、物流或退换货规则,参数来自已经校验的数据。
- 结果校验:检查接口是否成功、关键字段是否完整、业务状态是否允许继续。
- 回复节点:把已经确认的数据整理成用户能读懂的话。
路由节点可以使用规则、轻量分类模型,也可以使用受 JSON Schema 约束的小型 LLM。重点是限制输出范围,例如:
{
  "intent": "refund_request",
  "parameters": {
    "order_id": "<订单号>"
  },
  "missing_fields": []
}
intent 只能从预设枚举中选择,parameters 必须通过格式校验。若使用置信度,也要根据自己的业务样本设定转人工或继续追问的条件,不宜给所有场景套同一个阈值。
API 返回成功,也要再验一次
工具调用是 Agent 最容易出现连锁故障的地方。收到 200 OK,只能说明请求层面成功,还要继续检查业务字段。遇到 500、超时或权限失败,则进入重试、兜底提示或人工接管分支,不能让模型根据报错文本自行推断订单状态。
并行调用也要有边界。两个查询互不依赖时,可以同时发起;如果后一个接口需要前一个接口返回的商品编号,就应按顺序执行。为了让流程图看起来复杂而强行并行,反而会增加状态同步和排错成本。
退款、取消订单、修改地址等写入操作,还要配置权限校验和幂等控制。即使用户重复发送同一句话,系统也不应重复执行同一个业务动作。
让模型在最后开口
工具数据通过校验后,再交给最终的 LLM 节点。此时 Prompt 可以很短:
任务:根据结构化结果生成客服回复。

约束:
- 只使用输入字段,不补写缺失信息;
- policy_result 未批准时,不承诺退款或补偿;
- 必要字段缺失时,只提出一个明确的补充问题;
- 保留订单状态和时间等关键信息。
模型负责语气、格式和自然语言表达。退款资格、权限审批、状态迁移等决定,已经由规则、API 和状态机完成。
Prompt 并没有消失,只是职责变窄了。它用来约束输出格式和信息边界,不再承担整套业务流程。这样既能减少无效的模型调用,也方便团队定位错误究竟发生在哪个节点。
低代码平台的价值在可见性
Botpress 的 2026 年整理列出的低代码 AI Agent 平台包括 Botpress、Langflow、Dify、n8n、IBM、Microsoft 和 Google。文中对无代码与低代码的区分很实用:无代码隐藏代码和逻辑,低代码则暴露这些部分,方便自定义与扩展。
对生产系统来说,能看见逻辑很重要。开发者需要检查每个节点拿到了什么数据、调用了哪个接口、为什么进入当前分支。业务人员也能在流程图上确认规则,而不必从几千字的 Prompt 中寻找某个条件。
2026 年 AI Agent 的 12 大构建框架列出的框架已经能够连接 OpenAI、Google、Anthropic、Azure、AWS、Hugging Face 等不同模型或服务。选型时没必要只看支持多少模型,更应逐项确认:
- 能否接入现有 API,并管理鉴权和参数映射;
- 是否支持分支、循环、超时和失败出口;
- 能否校验模型的结构化输出;
- 是否保留节点输入、输出和错误日志;
- 能否配置人工接管及记忆边界。
记忆可以续上对话,不能代替业务库
Botpress 的资料提到了持久记忆能力。它适合保存用户偏好和对话上下文,让中断后的会话能够继续。但订单状态、库存和退款结果仍应从业务系统重新查询,避免 Agent 使用已经过期的记忆回答。
每个工具节点还应写清超时条件、重试上限和停止规则。重试仍然失败,就记录错误并转入兜底流程。没有停止条件的自动重试,可能把一次接口故障放大成重复调用甚至重复写入。
日志至少要能还原这条链路:用户输入了什么、路由结果是什么、调用了哪些工具、接口返回什么、最终走了哪个分支。涉及敏感字段时,再按已有的数据规范进行脱敏。
上线前,逐项跑一遍
不要只测试流程成功时的效果。下面这些情况更值得提前演练:
- 用户没有提供订单号,Agent 会追问还是编造?
- 路由节点返回了枚举之外的意图,流程去哪里?
- API 超时或返回
500,是否有明确出口? - 接口返回
200 OK,但关键字段为空,是否仍会生成答复? - 用户重复提交请求,会不会触发两次写入?
- 模型能否绕过规则,擅自承诺退款或补偿?
- 转人工后,客服能否看到此前的完整处理记录?
只要其中一项没有答案,继续加长 Prompt 都很难补上。所谓 Workflow Engineering,落到工程里就是三件事:把业务判断放进可检查的节点,让模型专注于理解和表达,再给每种失败安排明确去处。
对业务流程来说,可定位、可回滚、可追踪,比一段看起来很聪明的回答更有用。