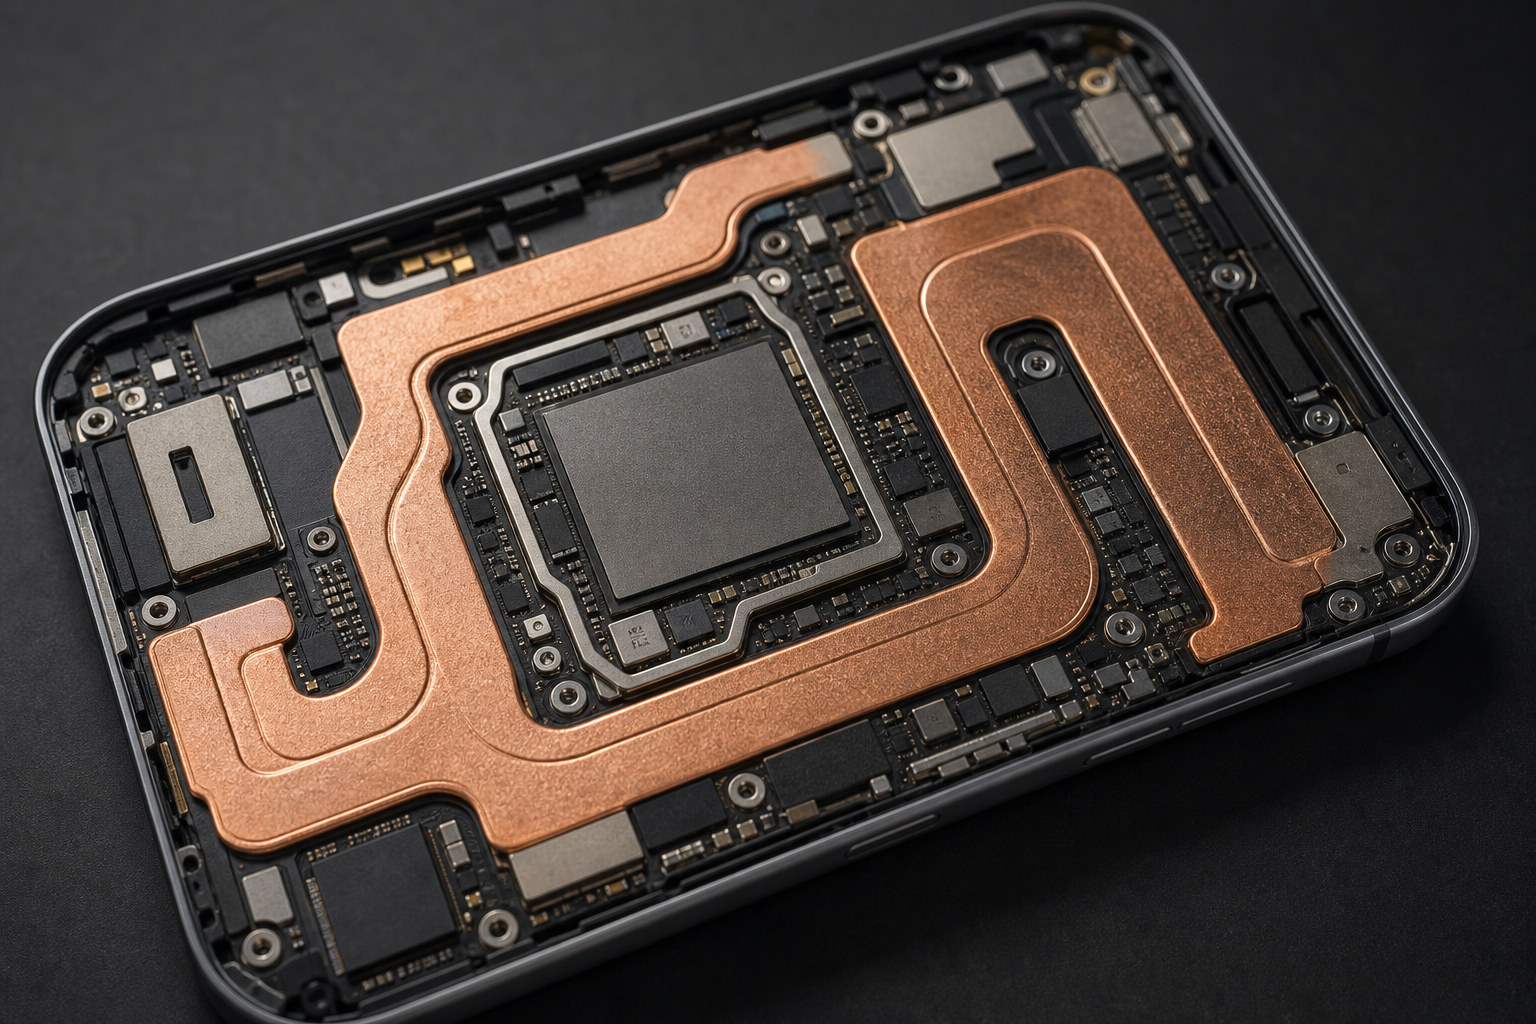
2025年底,高通在骁龙峰会上抛出第五代骁龙8至尊版(Snapdragon 8 Elite Gen 5)时,宣传口径非常直接:基于台积电第三代3nm(N3P)工艺,Hexagon NPU性能提升37%,支持端侧大模型实时推理。到了2026年7月,搭载该芯片的手机大规模铺货,一个尴尬的现实浮出水面:14B参数的端侧大模型,真的成了“标配体验”吗?
答案是否定的。在真实的使用场景中,算力指标只是入场券,持续的高负载推理能力才是分水岭。骁龙8 Gen5虽然号称“实时推理”,但在实际跑通一个14B的全功能助手时,发热是立竿见影的物理反馈。
根据近期多位开发者在技术社区分享的实测数据,在室温25℃环境下,运行14B INT8量化模型,手机背板温度在3分钟内即可突破42℃,触发高通的温控策略。此时,NPU和CPU的频率会被强制下调,导致响应延迟从500ms飙升至3秒以上。相比之下,如果使用《14B模型上手机,先看功耗这道坎》中提到的INT4量化方案,并在内存分配上采用预分配策略,温度曲线可以平滑得多,首字生成时间也能控制在1秒以内。
这引出了一个核心问题:NPU不是万能的。在骁龙8 Gen5的架构中,NPU虽然强大,但面对14B这种体量的模型,单靠NPU往往会出现内存带宽瓶颈。因此,目前的最佳实践是《骁龙8 Gen 5实测:端侧14B模型推理的散热瓶颈与调度优化》一文所强调的“NPU-CPU混合调度”。让NPU处理矩阵乘法等高并发任务,而CPU负责逻辑控制和上下文管理,同时利用LPDDR5x(速度达5300MHz)的高带宽特性进行数据搬运。
很多用户抱怨手机用AI就发烫,其实怪不到芯片头上,而是软件层的调度太“激进”。在《昇腾海光混部,运维先管住三件事》中提到的运维思路,同样适用于端侧AI:可观测、可隔离、可回滚。在手机端,这意味着系统需要在用户感知到卡顿前,动态调整NPU和GPU的资源占用。
例如,当检测到GPU正在进行游戏渲染或视频解码时,系统应主动降低NPU的优先级,或者切换到低功耗的CPU推理模式。反之,当设备处于空闲充电状态时,再全力释放NPU算力进行后台模型微调或离线翻译。这种细粒度的资源抢占策略,比单纯追求峰值AI跑分重要得多。毕竟,对于普通用户而言,连续对话的流畅度远比跑分软件上的数字更具说服力。
骁龙8 Gen5的AI能力确实迈过了一个门槛,但它并没有让14B模型变得“无感”。正如《AI Agent上线前,先把账单管住》中所指出的,成本的考量不仅限于云端Token,端侧的电力成本和硬件损耗也是隐形账单。高频次的14B模型推理,对电池寿命的折损是显而易见的。
目前的行业共识是,14B模型更适合在特定场景下作为“专家模块”存在,而非全天候的通用助手。例如,在本地隐私数据处理、复杂逻辑推理或离线内容生成时启用,而在日常闲聊、简单指令执行时,回退到7B甚至更小规模的模型。这种“大小模型协同”的策略,才能在功耗、体验和续航之间找到平衡点。
此外,开发者还需要关注《RAG补上图谱这块关系拼图》中提到的检索增强技术。通过引入轻量级的知识图谱和本地向量检索,可以减少对大模型本身的依赖,从而降低推理频次和功耗。这与《RAG别只盯着向量库》的观点不谋而合:真正的效率提升,来自于检索架构的优化,而非盲目扩大模型规模。
骁龙8 Gen5让14B端侧AI成为可能,但这并不意味着它已经成为所有用户的日常标配。在散热物理限制和电池容量瓶颈的双重约束下,当前的14B模型更多是一种“高性能选项”,而非“默认设置”。对于厂商而言,如何通过更聪明的调度和量化技术,将发热和耗电降到最低,才是决定这一代AI手机能否真正被大众接受的关键。对于用户来说,如果你尚未准备好为14B模型的“发烧”买单,那么等待更成熟的软件优化,或许是更理性的选择。
正如Arm高管在《Arm谈2026:AI芯片要往终端走》中所言,终端算力的未来不在于单点的极致,而在于系统级的协同。骁龙8 Gen5只是一个开始,真正的端侧AI革命,才刚刚热身。