2026年6月底,硅谷的风向变了。
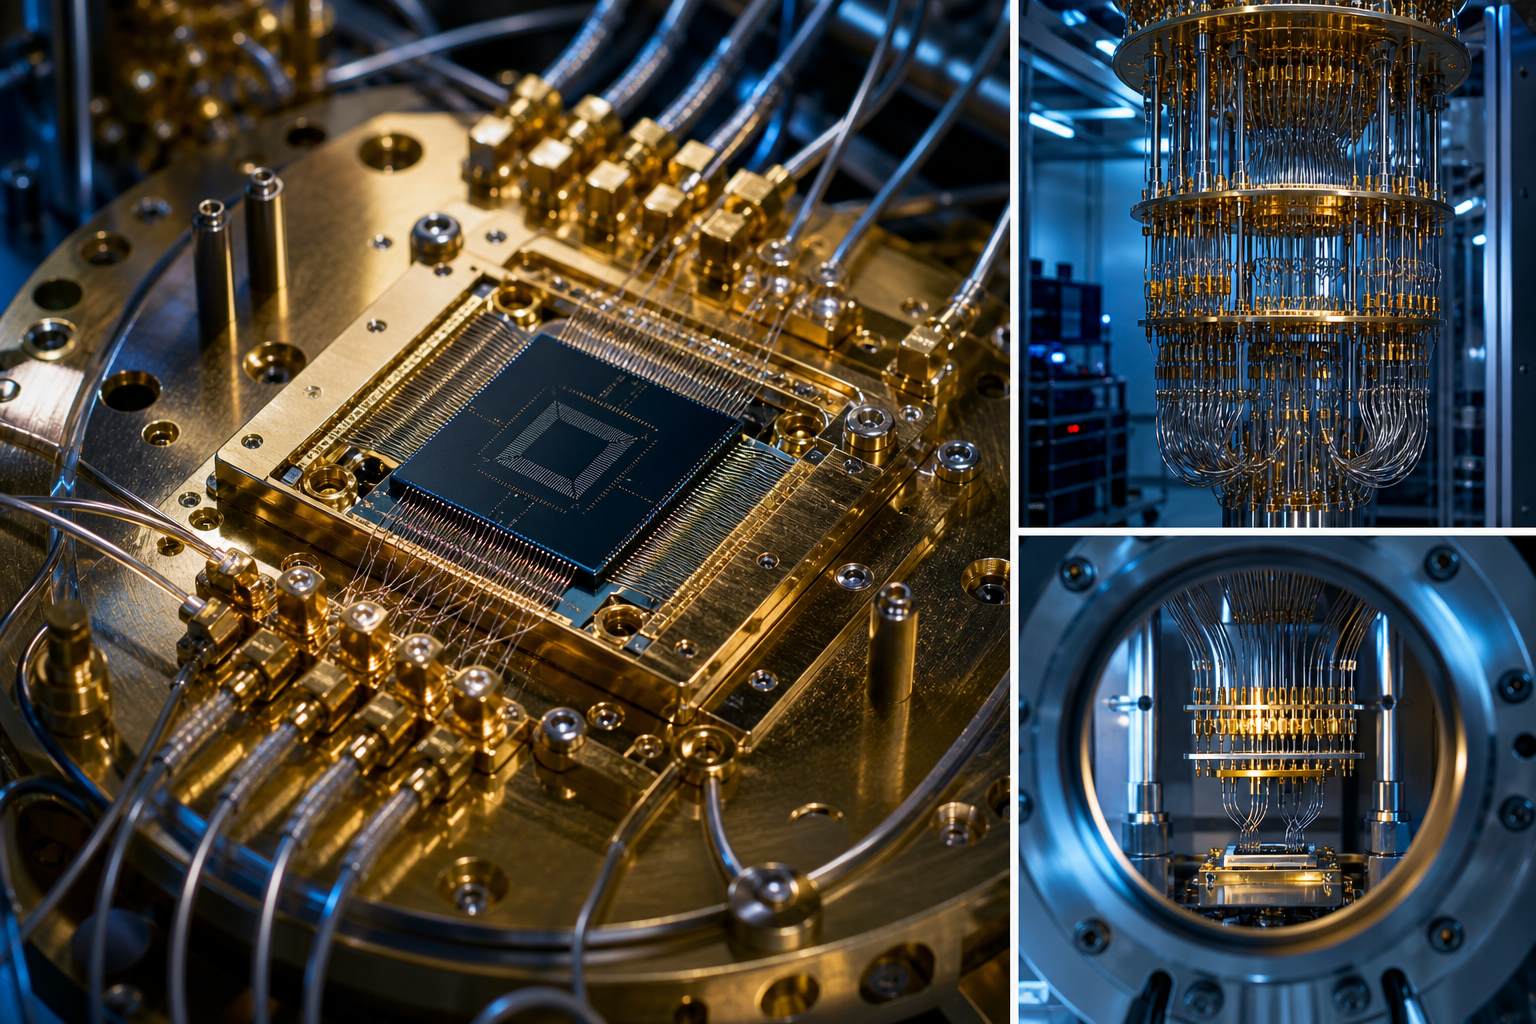
先是Google Quantum AI在《Nature》子刊上抛出了一份令人咋舌的数据:他们在Sycamore处理器上运行的表面码(Surface Code)纠错实验,将逻辑比特错误率压低至物理比特的千分之一以下。紧接着,IBM在7月初的开发者大会上展示了Heron系列芯片的新固件,声称其量子体积(Quantum Volume)在纠错辅助下提升了两个数量级。这两家巨头的动作并非孤立的科研秀,而是向市场发出的明确信号:量子计算正在跨越“含噪声中等规模”(NISQ)时代的混沌期,正式迈入“容错量子计算”(FTQC)的工程化前夜。
对于长期关注AI算力边界的从业者来说,这是一个关键的转折点。正如科大讯飞董事长刘庆峰在2026年4月的智能量子峰会上所言:“到2026年3月,我国日均词元调用量已超过140万亿。如果沿着当前经典计算框架继续外推,算力与能耗都将触碰到人类不可承受的‘天花板’。”
表面码 vs 拓扑比特:谁才是纠错的终局?
目前业界对量子纠错的主流方案分为两派:以Google为代表的超导量子比特配合表面码纠错,以及以Microsoft和Quantinuum为代表的拓扑量子比特路线。
表面码的优势在于其局部性,只需相邻量子比特即可实施纠错,工艺兼容性较好。然而,其代价是极高的物理比特开销。Google此次突破虽然证明了逻辑比特性能的超越,但要达到实用化的1000个逻辑比特,仍需百万级物理比特的支持。相比之下,拓扑量子比特理论上能以更少的物理资源实现更高的稳定性,但其材料制备和操控难度极大,目前仍处于实验室验证阶段。
据最新实测数据对比,表面码在短期实验中展现出更成熟的工程落地能力,纠错效率在d=5的距离编码下已初步显现优势。而拓扑量子比特则在理论纠错阈值上更具潜力,但在2026年的当下,其实测数据尚不足以支撑大规模并行计算。
AI算力的“第二曲线”:从模拟到混合
量子纠错的进步,意味着量子计算机开始具备执行复杂算法而不被噪声淹没的能力。这对AI行业意味着什么?
首先,它不是要取代GPU,而是解决GPU解决不了的问题。在大模型训练中,组合优化(如物流调度、金融风控)和分子模拟(如新药研发、材料科学)是典型的NP-hard问题。经典超算在处理这些高维非线性问题时,算力成本呈指数级增长。而具备纠错能力的量子计算机,有望在这些特定领域实现“量子优越性2.0”——即在保持一定精度的前提下,算力成本大幅下降。
然而,现实的约束依然存在。纯粹的量子AI仍处在“无人区”。上海初创公司“清醒异构”近期发布的RiverONE量子视觉模型,并未依赖真实的量子计算机,而是用经典计算机模拟量子计算线路。其参数量仅为英伟达同类产品的十分之一,性能却达到95%。这一案例揭示了一个残酷的现实:在量子硬件完全成熟之前,经典模拟与算法创新将成为过渡期的主力。
这也解释了为什么2026年的AI算力竞争,不再仅仅是堆砌Token和参数。正如我们在《架构师发来警告,单靠堆Token已经带不动业务线了》中提到的,企业正陷入“Token不经济”时代。量子纠错的突破,为打破这一僵局提供了另一种可能:通过混合量子-经典架构,在特定子任务中引入量子加速,从而降低整体算力需求。
国内团队的产业化时间表
在国内,量子与AI的融合也在加速。2026智能量子峰会上,多位专家指出,“量智融合”已成为必然选择。中科院物理所和中国科学技术大学等机构在超导量子比特纠错方面持续取得进展,部分团队已开始探索量子机器学习在图像识别和自然语言处理中的应用。
但产业化时间表依然谨慎。业内普遍预测,2027-2028年将是容错量子计算在特定垂直领域(如化学模拟)实现小规模商用的窗口期。而对于通用的AI大模型训练,量子计算的全面介入可能还需等到2030年以后。
在这段等待期内,企业该如何布局?
- 关注混合架构:不要期待量子计算机一夜之间取代GPU,而是寻找量子-经典混合算法在特定场景的应用,如《拒绝重复造轮子:用2026版Agent编排工具搭建企业级自动化工作流》中提到的多智能体协同,可能在组合优化环节受益于量子加速。
- 储备量子算法人才:随着纠错技术的成熟,量子算法工程师的需求将激增。目前,国内高校已开始增设相关课程,企业也可提前布局。
- 理性看待炒作:量子纠错的突破是长期的,短期的股价波动不应影响技术投入的节奏。
量子计算的下一个范式转移点,不在于硬件参数的疯狂堆砌,而在于纠错效率与算法创新的完美结合。当百万级物理比特能够稳定输出逻辑比特时,AI的算力边界将被彻底重写。而在那一天到来之前,我们需要做的,是保持耐心,并在经典与量子的交界处,找到属于自己的突破口。