8000P算力园区的账,最终要算到Token上
“8000P”不是功耗单位,PUE也不能单独推出月度电费。园区更该比较平均功耗、利用率和有效Token产出;H100、910B、昇腾910C,以及FP8、INT4等方案是否省钱,都要放进同一套实测口径。
阅读全文关键词:功耗
“8000P”不是功耗单位,PUE也不能单独推出月度电费。园区更该比较平均功耗、利用率和有效Token产出;H100、910B、昇腾910C,以及FP8、INT4等方案是否省钱,都要放进同一套实测口径。
阅读全文安谋科技在2024年提出,100亿参数级大模型已成为现有终端设备的最佳匹配规格。模型进手机后,用户先感受到的是弱网下仍可处理部分任务、敏感数据少上传和响应更直接;内存、功耗与模型更新,则决定它仍需云端配合。
阅读全文 产业动态
AMD 已公布 Advancing AI 2026 主题演讲时间,但现有公开材料还不足以确认 MI400 的显存、功耗、售价和训练成本。判断它能否撬动 NVIDIA,重点要看 ROCm、集群互联与首批客户部署。
阅读全文Arm 将 3D 堆叠和芯粒集成列为 2026 年芯片创新方向,目标是提高集成密度与能效。但现有资料没有手机端 10B 模型的功耗、温升和续航实测。它能否撑过一天,仍取决于调用频率、内存压力、散热和系统调度。
阅读全文 产业动态
针对2026年端侧Agent的能效瓶颈,本文拆解Arm最新AGI CPU与新能源架构如何通过内存带宽优化与微架构升级,支撑50亿参数模型在手机端实现低功耗常驻,并为开发者分析下半年端侧模型的容量上限。
阅读全文 技术应用
7B更容易在手机上落地,14B也不等于体验一定更好。面对骁龙8 Elite和天玑9400,选型要同时看内存占用、首字延迟、持续生成速度、整机功耗和降频情况。现有素材没有统一实测数据,因此不虚构芯片胜负,只给出可复现的比较
阅读全文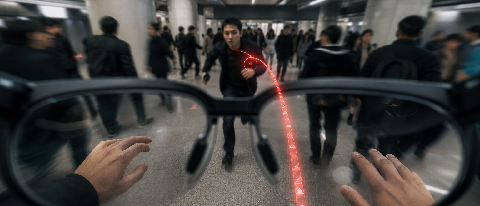 前沿研究
分析端侧世界模型如何将AI眼镜从简单的“视觉识别”升级为“物理预判”。结合谷歌、三星、高通等最新硬件动态,探讨轻量化世界模型在毫秒级实时推理中解决物理碰撞预测的技术路径与功耗约束。
阅读全文2026年,推理需求增长和算力租赁涨价把企业重新推向端侧。3B级模型适合处理纠错、分类和请求路由,把复杂任务留给云端。它能省多少,取决于本地完成率、云端重试、设备功耗和维护成本,不能只凭参数量估出固定降幅。
阅读全文2026年旗舰手机端侧AI体验的差距已从跑分转向能效。本文对比苹果A19、骁龙8 Gen 4与天玑9400在运行3B-7B量化模型时的功耗、发热与延迟,通过架构与实测案例揭示谁的NPU真正兼顾续航,并附一套可复现的功耗测
阅读全文7B模型做INT4量化后,权重理论下限约3.5GB;14B约7GB,运行时还要给KV Cache、系统和后台应用留空间。手机NPU调度的重点,是控制上下文、算子回退和持续发热。
阅读全文分析 VibeThinker 等 3B 规模端侧模型如何通过 GRPO 强化学习实现类似 o1 的慢思考(CoT)能力,探讨在内存与功耗约束下,端侧模型如何通过牺牲推理时间换取逻辑能力的跃迁,并为开发者提供端侧推理优化的
阅读全文 技术应用
骁龙8 Gen 5手机实测显示,INT4量化32B模型运行十分钟后,生成速度从8 token/s跌至3 token/s。本文对比RTX Spark的45—80W主动散热与手机的被动极限,剖析内存墙与NPU架构的真实瓶颈,
阅读全文