 开发者生态
2026 手机端侧 3B 模型实测:内存压力与推理速度的真实平衡点
基于 2026 年主流旗舰机型(骁龙 8 Elite、天玑 9400、A18 Pro)的连续跑测数据,对比 Qwen2.5-3B、Llama-3.2-3B 与 Gemma-3-3B 在 4-bit 与 6-bit 量化下
阅读全文关键词:手机
开发者生态
基于 2026 年主流旗舰机型(骁龙 8 Elite、天玑 9400、A18 Pro)的连续跑测数据,对比 Qwen2.5-3B、Llama-3.2-3B 与 Gemma-3-3B 在 4-bit 与 6-bit 量化下
阅读全文 产业动态
Arm把2026年芯片创新的注意力从单纯缩小晶体管,移到3D堆叠与Chiplet。苹果AFM 3则用稀疏架构控制每次推理的计算量。手机要减少云端依赖,靠的不是单独堆NPU,而是让模型、框架、芯片和具体功能对得上。
阅读全文安谋科技在2024年提出,100亿参数级大模型已成为现有终端设备的最佳匹配规格。模型进手机后,用户先感受到的是弱网下仍可处理部分任务、敏感数据少上传和响应更直接;内存、功耗与模型更新,则决定它仍需云端配合。
阅读全文Arm 将 3D 堆叠和芯粒集成列为 2026 年芯片创新方向,目标是提高集成密度与能效。但现有资料没有手机端 10B 模型的功耗、温升和续航实测。它能否撑过一天,仍取决于调用频率、内存压力、散热和系统调度。
阅读全文 产业动态
2026年MWC上海,荣耀首次系统性定义Agentic OS。手机AI的较量开始落到任务拆解、工具调用和跨应用执行上。评价OS-Agent,关键要看系统能否把用户目标推进到可确认的结果。
阅读全文3B—7B小模型想在手机上多想一步,需要任务路由、短步骤推理、检索、校验和云端兜底共同工作。Qwen3与vivo、面壁智能的公开信息,把端侧问题从“能不能跑”推进到“能不能稳定完成任务”。
阅读全文2026年端侧AI已从跑分转向体感优化。本文通过拆解3B-7B模型的首token延迟(TTFT),分析内存带宽瓶颈与KV Cache压缩技术,探讨硬件厂商如何通过架构升级解决AI手机卡顿,揭示端侧推理的真实性能分水岭。
阅读全文MoE架构通过稀疏激活降低了计算量,但其庞大的参数体量在端侧设备上触发了严重的内存带宽瓶颈。本文分析MoE在手机端的“存储墙”困境,并提供KV Cache量化与专家路由控制的实操方案,帮助开发者在有限显存下跑通模型推理。
阅读全文 产业动态
针对2026年端侧Agent的能效瓶颈,本文拆解Arm最新AGI CPU与新能源架构如何通过内存带宽优化与微架构升级,支撑50亿参数模型在手机端实现低功耗常驻,并为开发者分析下半年端侧模型的容量上限。
阅读全文 技术应用
7B更容易在手机上落地,14B也不等于体验一定更好。面对骁龙8 Elite和天玑9400,选型要同时看内存占用、首字延迟、持续生成速度、整机功耗和降频情况。现有素材没有统一实测数据,因此不虚构芯片胜负,只给出可复现的比较
阅读全文 技术应用
2026年,多家厂商把AI眼镜推向消费市场。真正难的不是把手机界面缩到镜片上,而是让Agent判断用户看什么、想做什么,并在付款、发消息等动作前给出明确确认。发热、续航和端云分工,也决定了无屏交互能否成为日常工具。
阅读全文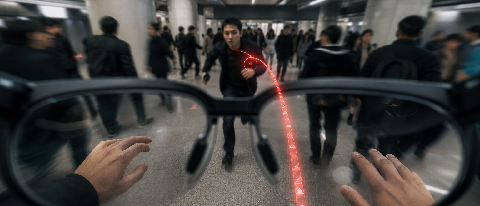 前沿研究
分析端侧世界模型如何将AI眼镜从简单的“视觉识别”升级为“物理预判”。结合谷歌、三星、高通等最新硬件动态,探讨轻量化世界模型在毫秒级实时推理中解决物理碰撞预测的技术路径与功耗约束。
阅读全文