 产业动态
Arm的2026判断:手机端侧AI不能只靠压缩模型
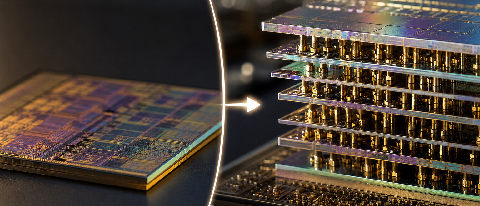
Arm把2026年芯片创新的注意力从单纯缩小晶体管,移到3D堆叠与Chiplet。苹果AFM 3则用稀疏架构控制每次推理的计算量。手机要减少云端依赖,靠的不是单独堆NPU,而是让模型、框架、芯片和具体功能对得上。
阅读全文关键词:Arm
产业动态
Arm把2026年芯片创新的注意力从单纯缩小晶体管,移到3D堆叠与Chiplet。苹果AFM 3则用稀疏架构控制每次推理的计算量。手机要减少云端依赖,靠的不是单独堆NPU,而是让模型、框架、芯片和具体功能对得上。
阅读全文Arm围绕COMPUTEX 2026 CEO主题演讲发布的信息,把代理式AI从云端延伸到边缘列为重点。结合20项技术预测,其路线已经清晰:计算走向分布式,芯片创新更多依靠先进封装、3D堆叠和芯粒集成。
阅读全文Arm 将 3D 堆叠和芯粒集成列为 2026 年芯片创新方向,目标是提高集成密度与能效。但现有资料没有手机端 10B 模型的功耗、温升和续航实测。它能否撑过一天,仍取决于调用频率、内存压力、散热和系统调度。
阅读全文 产业动态
针对2026年端侧Agent的能效瓶颈,本文拆解Arm最新AGI CPU与新能源架构如何通过内存带宽优化与微架构升级,支撑50亿参数模型在手机端实现低功耗常驻,并为开发者分析下半年端侧模型的容量上限。
阅读全文Arm在20项技术预测中把2026视为智能计算转向分布式架构的重要节点。所谓能效拐点,并非某项指标突然越线,而是3D堆叠、芯粒集成与端云协同开始共同改变芯片设计。
阅读全文端侧AI进入手机和智能眼镜后,峰值算力已不足以解释真实体验。现有材料能确认苹果等厂商持续推进端侧AI、国内至少50个团队布局AI眼镜;至于「ARM V3.1」及相关性能数据,缺少官方文档和测试条件,暂不宜写成定论。
阅读全文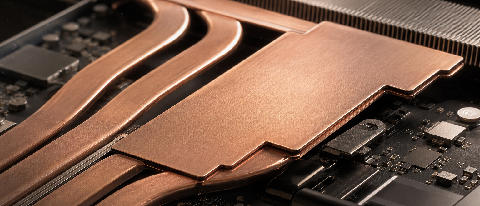 前沿研究
本地AI延长了笔记本的高负载时间,散热开始直接影响持续性能。VC均热板适合摊平热点,冷板液冷已用于AI服务器和HPC设备;对Arm AI PC而言,液冷仍要过体积、成本与可靠性几道关。
阅读全文 产业动态
RTX Spark给出20核Arm CPU、6144个CUDA核心、128GB统一内存和45—80W功耗,N1、N1X也在推进。规格表更漂亮了,但智能体常驻之后,CPU调度、内存带宽和持续散热仍会决定AI PC的续航与响
阅读全文拍照提问时,2秒等待足以打断操作,200毫秒才接近即时反馈。3B级模型要缩短首字延迟,得同时减少权重、视觉Token与KV Cache搬运,并让量化方案真正匹配Arm指令和手机NPU。
阅读全文针对2026年主流的3B级端侧模型(如商汤Sage、vivo蓝心3B),实测在Arm v10架构设备上运行3-5个垂直Agent时的内存占用与延迟。对比INT4与FP8量化方案,分析在多Agent协作场景下的精度掉点与资
阅读全文 前沿研究
Arm v10工程样片测试中,SME2让Llama-3-3B 4-bit版Prefill速度较v9提升3.2倍,首字延迟由约1.2秒降至400毫秒以内;Decoding加速约1.4倍,10B模型持续运行仍受发热和功耗约束
阅读全文 前沿研究
2026年7月实测表明,手机运行10B参数模型已从「不能跑」跨到「可以跑」,但发烫问题并未消失。得益于NPU调度、稀疏激活与指令集优化,持续推理功耗降至4.8W,温度约45℃;但Agent场景连续调用仍会堆积热量。文章引
阅读全文