 前沿研究
去中心化GPU租赁,便宜之后还要算稳定性
Render、Akash和io.net正在把分散的GPU接入租赁市场。价格低于大型云厂商,但节点掉线、延迟、合规和SLA仍是硬约束。对AI团队来说,它们更适合离线推理、渲染和微调任务。
阅读全文关键词:推理
前沿研究
Render、Akash和io.net正在把分散的GPU接入租赁市场。价格低于大型云厂商,但节点掉线、延迟、合规和SLA仍是硬约束。对AI团队来说,它们更适合离线推理、渲染和微调任务。
阅读全文 战略前瞻
峰值算力决定园区能承接多大的任务,稳定负载才决定设备能否持续运转。随着大模型转向产品化,算力园区比拼的不再只是硬件规模,还有推理订单、任务调度、行业适配和交付能力。
阅读全文 前沿研究
在iOS 26与iPhone 17 Pro上,Apple Intelligence处理摘要等本地任务已经足够快,但遇到图像、多步推理和跨应用操作,仍会受到云端依赖、发热与权限限制。
阅读全文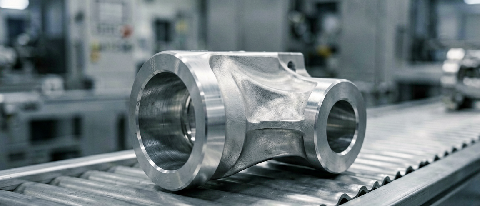 前沿研究
华东一家转向节工厂的AI质检Agent上线时,异形件误报率超过18%,反光铝面误报率高达25%。通过偏振相机、边缘推理和分级人工复核,三个月后误报率降至4%左右。2026年全球制造企业Agent真实落地率仅17%,误报是
阅读全文 技术应用
公开素材还不足以支撑“2026下半年真实功耗实测”的说法。更可靠的看点是,Arm、苹果等厂商正在把端侧AI竞争从模型压缩,推向芯片、运行时、工具链和设备场景的协同。
阅读全文 AI 工具箱
用一台骁龙8 Gen3、12GB内存的小米14 Pro实测Wan2.1 1.3B量化版:生成15秒720p短片耗时38分12秒,峰值内存8.7GB,温度接近70℃。它还谈不上好用,但本地跑通已经不是空想。
阅读全文 AI 实操指南
一次推理调度器迁移里,Rust 让 p99 延迟和内存稳定性变好,却在 FFI 边界损失了吞吐。C++ 老手关心的不是语言输赢,而是组件边界该怎么切。
阅读全文 深度观察
 开发者生态
vLLM、sglang 仍是推理服务主流。Rust 更现实的入口,是接管 tokenizer、批处理调度、后处理和网关这些延迟敏感环节,而不是一上来重写整个推理引擎。
阅读全文 开发者生态
H20供应收紧后,昇腾910C和寒武纪成了更多团队的备选项。真正麻烦的地方不在改几行代码,而在Attention算子、HCCL通信、调试工具和推理吞吐的连续磨损。
阅读全文 前沿研究
 产业动态
乌兰察布的低电价、低温和风电资源,曾经适合承接数据中心。但到8000P级智算园区,经营压力不只在建设端。62%利用率、不足40%租户留存率,以及推理负载占用70%有效算力,把电费、运维、折旧和客户黏性的问题一起推到台前。
阅读全文