 AI 实操指南
旧手机跑端侧大模型,量化和调度怎么选
把 Qwen2.5-3B-Instruct 或 Llama-3.1-8B 放进 iPhone 13、Redmi Note 12 Pro+,卡点通常落在内存、算子支持和持续发热。旧设备可先用 INT8 建立基线,再按内存压
阅读全文关键词:发热
AI 实操指南
把 Qwen2.5-3B-Instruct 或 Llama-3.1-8B 放进 iPhone 13、Redmi Note 12 Pro+,卡点通常落在内存、算子支持和持续发热。旧设备可先用 INT8 建立基线,再按内存压
阅读全文 前沿研究
2026年夏天,7B大模型在旗舰机上跑通已成常态,但内存占用和发热问题远比宣传复杂。实测三款旗舰机在连续对话下的内存与掉电数据,拆解手机厂商为了保住轻薄设计,在NPU调度策略上做的妥协。端侧AI的真实代价,才刚刚浮出水面
阅读全文把大模型装进Android App,跑通只是起点。真正影响体验的是模型加载、内存复用、NPU回退和持续发热。围绕这些工程问题,梳理一套更稳妥的端侧部署思路。
阅读全文 前沿研究
在iOS 26与iPhone 17 Pro上,Apple Intelligence处理摘要等本地任务已经足够快,但遇到图像、多步推理和跨应用操作,仍会受到云端依赖、发热与权限限制。
阅读全文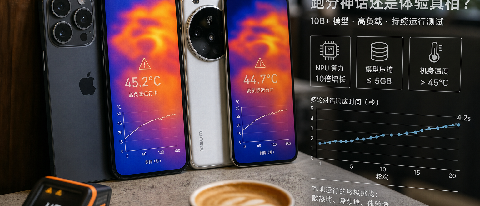 前沿研究
2026年旗舰机宣称的“本地运行”面临严峻考验。实测发现,即便搭载最强NPU,10B+模型在高负载下依然触发降频,发热导致体验断崖式下跌。真正的差距不在参数大小,而在软硬件协同与稀疏架构。
阅读全文 前沿研究
2026年一季度,全球智能头戴设备市场同比增长83%,无显示屏智能眼镜增速达到210%。市场热度已经起来,但端侧计算带来的功耗、散热和续航压力,以及摄像头进入公共空间后的隐私争议,仍决定着AI眼镜能否从新鲜设备变成日常用
阅读全文 产业动态
 前沿研究
 AI 工具箱
OPPO在2025年世界人工智能大会展示了200 token/s端侧模型能力,也把AI手机的真实考题暴露出来:峰值速度之外,NPU调度、量化部署、发热控制和端云协同,才决定它能不能长期好用。
阅读全文 前沿研究
 前沿研究
骁龙8 Gen5实测跑14B模型发热严重,但6月落地的混合精度量化与稀疏激活技术,已把内存压到5.8GB、推理功耗控在3.2W。两条算法路径叠加后,中端机本地跑大模型不再是噱头,只是加载那5秒的等待仍是工程上的最后一公里
阅读全文搭载骁龙8 Gen5的旗舰机已上市,我们断网实测了一周14B参数模型的本地推理。响应7.8秒、续航缩水三成、发热可控但持久战会降频。本文给出速度、功耗和隐私的真实数字,并对比云端API,明确判断普通用户当前是否值得为端侧
阅读全文