 前沿研究
昇腾910C扩到万卡前,先查通信和显存
千卡训练跑通,不等于万卡可以照搬。公开参数显示,昇腾910C配备96GB HBM、1.8TB/s显存带宽和400GB/s HCCS;规模继续放大后,HCCL通信、并行切分和显存分配都要先做现场压测。
阅读全文关键词:HCCL
前沿研究
千卡训练跑通,不等于万卡可以照搬。公开参数显示,昇腾910C配备96GB HBM、1.8TB/s显存带宽和400GB/s HCCS;规模继续放大后,HCCL通信、并行切分和显存分配都要先做现场压测。
阅读全文 技术应用
 前沿研究
1.6万亿参数后训练已经跑通,7B—13B微调却不能照搬CUDA脚本。三个项目的故障集中在OOM、融合算子缺失和HCCL卡死,排查顺序比盲目改参数更重要。
阅读全文 开发者生态
公开材料披露,1000颗昇腾910C完成1.6万亿参数DeepSeek-V4-Pro全参数后训练,MFU超过30%。落到机房,排查应从HCCL拓扑、Rank映射和版本组合开始,再用Profiler定位算子与内存拷贝。
阅读全文 开发者生态
 前沿研究
现有素材没有提供可核验的910D测试数据。相比单卡跑分,企业更需要关注集群扩展、软件迁移和长期稳定性。基于目前的公开信息,国产算力的性价比拐点还无法下结论。
阅读全文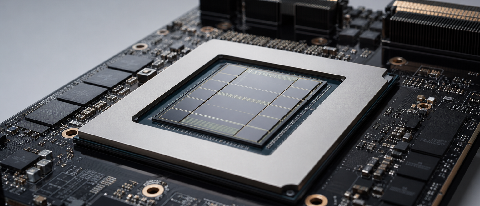 前沿研究
 开发者生态
昇腾910D传闻让国产AI算力再次升温。对中小团队来说,真正要提前核算的,是PyTorch、CUDA、NCCL到CANN、HCCL、torch_npu之间的改造、人力、算子和运维成本。
阅读全文 开发者生态
H20供应收紧后,昇腾910C和寒武纪成了更多团队的备选项。真正麻烦的地方不在改几行代码,而在Attention算子、HCCL通信、调试工具和推理吞吐的连续磨损。
阅读全文 前沿研究
昇腾910C能否进入更大规模训练集群,关键不只看单卡参数。CUDA迁移、CANN适配、HCCL通信和CloudMatrix 384的集群效率,才是采购方真正要算的工程账。
阅读全文 前沿研究
把 PyTorch 模型迁到昇腾 910C 和 CANN 8.0 环境,难点常落在算子支持、显存分配、分布式通信和调试链路上。迁移不只是替换设备名,更要重新检查算子、内存和 HCCL 配置。
阅读全文 AI 实操指南
昇腾910C和H200放进同一套集群,难点不只是驱动安装。CANN、CUDA、HCCL、容器环境和调度策略都要拆开看,尤其要避免环境变量、通信库和拓扑配置互相干扰。
阅读全文