手机多模态推理压到200毫秒,先拆内存墙
拍照提问时,2秒等待足以打断操作,200毫秒才接近即时反馈。3B级模型要缩短首字延迟,得同时减少权重、视觉Token与KV Cache搬运,并让量化方案真正匹配Arm指令和手机NPU。
阅读全文关键词:NPU
拍照提问时,2秒等待足以打断操作,200毫秒才接近即时反馈。3B级模型要缩短首字延迟,得同时减少权重、视觉Token与KV Cache搬运,并让量化方案真正匹配Arm指令和手机NPU。
阅读全文 前沿研究
2026年7月实测显示,端侧3B模型日均待机耗电约1.5%-2%,重度Agent调用下续航减半。量化、剪枝等轻量化方案虽降低峰值功耗,但需配合NPU调度优化才能解决发热焦虑。本文拆解vivo蓝心、小米澎湃等主流模型的功耗
阅读全文 前沿研究
2026年7月实测表明,手机运行10B参数模型已从「不能跑」跨到「可以跑」,但发烫问题并未消失。得益于NPU调度、稀疏激活与指令集优化,持续推理功耗降至4.8W,温度约45℃;但Agent场景连续调用仍会堆积热量。文章引
阅读全文 前沿研究
高温、粉尘、密闭机箱和连续运行,会让风扇与功耗先于 TOPS 成为工业质检的瓶颈。RISC-V 并非天然比 GPU 省电,但配合定制 NPU、RVV 和量化模型,它有机会在任务固定的边缘节点上,用够用的算力换取更简单的散
阅读全文 前沿研究
7月15日,Apple智能等7款手机端侧生成式AI服务完成备案,iPhone 18 Pro的2nm芯片也备受关注。但现有素材不足以证明预售遇冷。端侧AI仍受跨应用协同、续航和发热约束,短期内很难单独缩短换机周期。
阅读全文 开发者生态
torch_npu 能让 PyTorch 模型较快接入昇腾,但代码执行成功只解决了第一道问题。延迟、OOM、长尾算子和 CANN 日志定位,会直接影响迁移能否稳定交付。团队还要判断:继续用兼容层,还是为热点算子投入 As
阅读全文在本站 Llama 3.2 7B 连续生成 512 tokens 的测试中,FP8 功耗较 INT4 高约 20%-30%。端侧助手要常驻,峰值 TOPS 还说明不了续航;原生加速、端云分工和散热更值得看。
阅读全文 前沿研究
边缘AI既要低延迟,也受电池和散热限制。RISC-V可裁剪指令集、增加自定义扩展并接入NPU。它能否比ARM省电,最终取决于芯片实现、工具链和可复现测试。
阅读全文 技术应用
天玑9500已有100 TOPS等发布规格,骁龙8 Elite Gen5的同类数据来自发布前瞻,A19 Pro则缺少可直接对照的官方指标。现有素材没有统一模型、机型和环境下的功耗温度数据,能比较的是测试边界,不是“谁最凉
阅读全文 前沿研究
Arm发布的20项技术预测把模块化、能效和云边端连接列为重点。放到手机上,模型实际调用多少计算、能否持续运行,以及框架、NPU与整机是否匹配,比单看参数量更接近真实体验。
阅读全文 前沿研究
苹果把省电做进约200亿参数的稀疏模型,高通则用混合精度降低推理能耗,并称骁龙8 Gen 4端侧大模型功耗下降40%。两套方案暂时缺少统一实测,38TOPS也不能代替持续运行时的温度、降频和适配成本。
阅读全文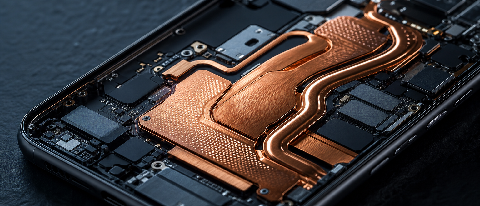 前沿研究
苹果用约200亿参数的稀疏模型减少单次激活,Pixel 10让Gemini Nano常驻端侧,小米MiMo-V2 Pro总参数超过1万亿。公开资料尚无统一温度与降频测试,能效高低还得看持续负载。
阅读全文