 AI 实操指南
Llama 4和Mistral进欧洲,先补齐合规材料
欧盟通用人工智能模型相关义务已于2025年8月2日生效。选择Llama 4或Mistral时,除了模型能力,还要检查技术文档、训练数据摘要、版权政策和微调数据记录能否经得起审查。
阅读全文关键词:微调
AI 实操指南
欧盟通用人工智能模型相关义务已于2025年8月2日生效。选择Llama 4或Mistral时,除了模型能力,还要检查技术文档、训练数据摘要、版权政策和微调数据记录能否经得起审查。
阅读全文 前沿研究
Render、Akash和io.net正在把分散的GPU接入租赁市场。价格低于大型云厂商,但节点掉线、延迟、合规和SLA仍是硬约束。对AI团队来说,它们更适合离线推理、渲染和微调任务。
阅读全文 AI 工具箱
16GB 显存可以尝试 LoRA 微调 Qwen2.5-7B-Instruct,但客服 Agent 不能只靠微调。模型选择、训练数据、知识库和业务工具需要分开处理。
阅读全文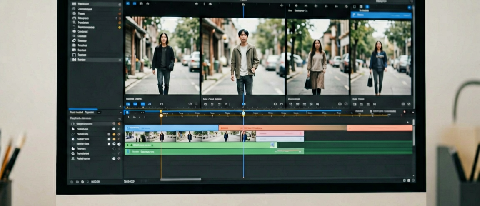 前沿研究
Sora用最长一分钟的视频展示了文生视频的上限,但广告、短剧和影视团队更关心修改成本:角色能否锁定、镜头能否衔接、局部调整会不会破坏整段素材。视频生成真正进入制作流程,绕不开后期工具和版本管理。
阅读全文 前沿研究
坊间流传的 Gemini 2.5 权重泄露并非获取闭源巨头的捷径。对于缺乏万卡集群的初创公司,合法且高效的路径是利用 Gemini 2.5 Pro 的免费试用额度进行 RAG 测试,随后转向 Qwen 或 GLM 等开源
阅读全文2026年6月,某电商平台基于BIGAI通用智能体上线的客服机器人‘小通’因缺少行业常识频频出错。本文记录从优惠券计算错误到退换货幻觉的具体翻车案例,拆解团队通过RAG知识库与RLHF人工反馈的修正过程,提炼出三条可复用
阅读全文 开发者生态
Llama 4把开源模型带进MoE架构,Scout和Maverick两个版本也把微调工具链的老问题放大了:显存、路由、量化和多模态兼容,都不能再按Dense模型的习惯处理。
阅读全文 AI 工具箱
去年开源社区发布的LoRA-Mini框架,在RTX 5090上把Llama 6 8B微调显存压到8.3GB。但更贴近现实的是,在RTX 4090上同样可以8分钟跑完一个行业知识库微调流程。本文以法律文书问答为例,从数据预
阅读全文2026年7月5日开源框架LoRA-Mini在RTX 5090上微调Llama 6 8B,显存占用降至8.3GB,训练时间缩至8.5分钟,相比传统LoRA提升5.5倍。实测对比显示效果损失极小,为个人开发者提供了高性价比
阅读全文 开发者生态
2026年7月,随着Llama 6和Qwen 3等开源模型的不断迭代,混合精度训练成为提高训练效率的关键。了解FP8/BF16混合精度在消费级显卡上的应用,能够让开发者在有限算力条件下,实现更高效的模型微调。
阅读全文 AI 工具箱
算力下放不等于成本无忧。2026年下半年,面对B300的高昂能耗与采购门槛,中小企业应摒弃“全量微调”的执念,转向以RAG为核心的架构。通过FP8混合精度、INT量化与混合检索技术,在有限预算下实现高准确率的企业内部知识
阅读全文北京AGI园区8000P算力集群落地,看似降低了门槛,实则通过算子适配、HCCL通信等隐性支出构筑了新壁垒。中小团队需重新审视云端API与本地微调的成本账。
阅读全文