 前沿研究
从蒸馏到结构化剪枝,2026年模型压缩怎么选
模型文件变小,不等于端侧推理更快。量化压低位宽,蒸馏训练更小的学生模型,结构化剪枝直接改变网络形状。面向2026年的部署,算子支持、内存访问和持续功耗比单看压缩率更有参考价值。
阅读全文关键词:性能
前沿研究
模型文件变小,不等于端侧推理更快。量化压低位宽,蒸馏训练更小的学生模型,结构化剪枝直接改变网络形状。面向2026年的部署,算子支持、内存访问和持续功耗比单看压缩率更有参考价值。
阅读全文 开发者生态
 产业动态
端侧大模型进入手机和PC后,芯片性能已不能只看TOPS。Arm推出Lumex CSS并引入SME2,试图从CPU、GPU、系统IP和数据搬运入手,缓解算力、内存与功耗之间的牵制。
阅读全文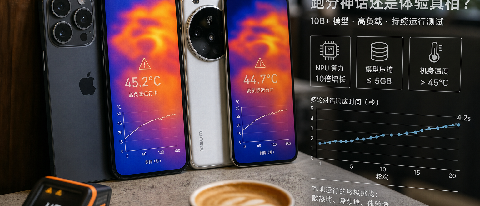 前沿研究
2026年旗舰机宣称的“本地运行”面临严峻考验。实测发现,即便搭载最强NPU,10B+模型在高负载下依然触发降频,发热导致体验断崖式下跌。真正的差距不在参数大小,而在软硬件协同与稀疏架构。
阅读全文 前沿研究
昇腾910C进入量产交付阶段后,国产AI芯片面对的不再只是单卡性能比较。集群稳定性、CANN适配、模型迁移和故障恢复,正在决定它能否真正接住大模型训练任务。
阅读全文 AI 实操指南
一次推理调度器迁移里,Rust 让 p99 延迟和内存稳定性变好,却在 FFI 边界损失了吞吐。C++ 老手关心的不是语言输赢,而是组件边界该怎么切。
阅读全文 开发者生态
vLLM、sglang 仍是推理服务主流。Rust 更现实的入口,是接管 tokenizer、批处理调度、后处理和网关这些延迟敏感环节,而不是一上来重写整个推理引擎。
阅读全文 开发者生态
Rust 不是突然取代 Python,而是在 AI 基建里找到更适合自己的位置:模型之外的推理服务、检索链路、数据管道和高并发组件。性能、内存安全和 AI 编程工具的成熟,正在让它重新被开发者认真评估。
阅读全文 产业动态
国产AI芯片的订单和财报都在升温,但从NVIDIA迁移到昇腾、寒武纪等平台,真正难的是性能、工具链和工程适配。能跑通的案例值得看,没跑顺的成本也不能忽略。
阅读全文 前沿研究
骁龙8 Gen5把14B模型跑顺了,功耗压到5.8W,但摄像头被烤到47.2℃。苹果传用2nm,谷歌押TPU,真正卡脖子的不是跑分,是散热、内存带宽和一套至今没人能用的跨平台SDK。端侧AI从能跑到能用,中间还隔着三个没
阅读全文Apple M5 把 Neural Accelerator 放进 10 核 GPU 的每颗核心里,让端侧 AI 多了一条计算路径。峰值性能提升很醒目,但真正影响体验的,仍是推理、渲染、内存和功耗如何分配。
阅读全文 前沿研究
训练和推理共用昇腾910C集群,利用率变高只是表面。真正容易出问题的是连续显存、通信抖动、P99延迟和调度边界。上线前,压测要按生产负载跑,而不是只看单任务性能。
阅读全文