 前沿研究
Arm加码移动AI,端侧部署别再只盯TOPS
Arm官方把移动AI放在CPU、CSS和IP协同的整套平台中。现有素材不足以证明“能效提升40%”;手机端模型能否跑稳,主要看量化格式、内存占用、算子回退和持续功耗。
阅读全文关键词:优化
前沿研究
Arm官方把移动AI放在CPU、CSS和IP协同的整套平台中。现有素材不足以证明“能效提升40%”;手机端模型能否跑稳,主要看量化格式、内存占用、算子回退和持续功耗。
阅读全文 前沿研究
千卡训练跑通,不等于万卡可以照搬。公开参数显示,昇腾910C配备96GB HBM、1.8TB/s显存带宽和400GB/s HCCS;规模继续放大后,HCCL通信、并行切分和显存分配都要先做现场压测。
阅读全文切入企业财务自动化这一高频场景,专门解决多模态Agent在处理手写、模糊、折叠票据时的常见失败案例。提供具体的Prompt优化技巧和后处理校验逻辑,展示如何通过增加人工复核节点来提升最终准确率,极具实战参考价值。
阅读全文 前沿研究
Qwen3.5发布资料给出Qwen3-Max显存占用降低60%、最大吞吐量提升至19倍,但这两组数字不能直接证明单张4090可跑,也不能推出成本减半。部署前要分清模型规模、量化权重、KV Cache和并发口径,再用vLL
阅读全文 开发者生态
基于8000P园区实战,拆解昇腾910C在万卡规模下的高频报错。从HCCS通信死锁到显存碎片化,提供可复用的调试脚本与CANN参数调优方案,直击国产算力大模型训练的工程深水区。
阅读全文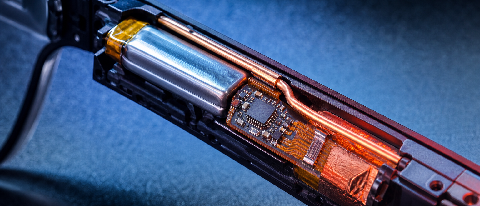 前沿研究
2026年AI眼镜密集上新,70亿参数模型已在手机端跑通,但塞进眼镜远不只是把芯片换小。异步量化推理能压内存,光波导和电池却卡住了系统调度。本文从算法、芯片、光学和功耗四条线索,拆解为什么"能跑"离"好用"还差一套工程协
阅读全文 前沿研究
Python仍主导训练、Notebook和原型开发,Rust更适合LLM网关、本地Agent、工具运行时、MCP及内存敏感组件。所谓“去Python化”更像生产栈分工:保留Python的迭代速度,把故障代价高的热路径单独
阅读全文2026年夏季多地限电,智算中心被迫降频,储能从备用电源升级为削峰填谷核心。宁德时代与特斯拉在储能峰会发布AIDC方案,锂电池、钠电池、飞轮储能按场景组合。阿里云试点AI调度算法预测负载,联动储能,试点电费下降12%。算
阅读全文 开发者生态
一套基于 Qwen2.5-7B 的金融知识库,初始召回率为 78%。两周里我们没换模型,只重做 PDF 清洗与分块,加入 BM25 和 Cross-Encoder 重排,最后稳定在 92%。能到 94% 的 Parent
阅读全文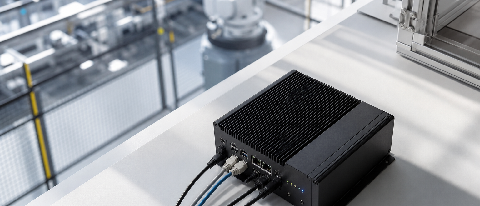 产业动态
2026年7月,8000P智算中心暑期满档,酒仙桥园区闲时利用率升至48.3%。本文拆解混合部署的真实账本:边缘计算如何通过“带宽+冷却”倒逼的成本优化,承接实时推理与长尾微调,实现云边协同的泛在算力网络。
阅读全文 开发者生态
同一套模型、向量数据库和5万篇中英文混合文档下,五种分块方案的召回率从82%到94%不等。Parent-Child以160ms平均延迟取得94%召回率,Markdown结构分块更适合成本敏感的结构化文档。
阅读全文 前沿研究
现有材料能确认 Meta 在2025年4月推出 Llama 4,Scout 有1090亿总参数、170亿活跃参数和16个专家;但材料中没有 Llama 4.1 的官方发布信息,也没有300B模型在消费级显卡上的完整实测。
阅读全文