 开发者生态
昇腾910C跑到千卡,HCCL先查哪一层
公开材料披露,1000颗昇腾910C完成1.6万亿参数DeepSeek-V4-Pro全参数后训练,MFU超过30%。落到机房,排查应从HCCL拓扑、Rank映射和版本组合开始,再用Profiler定位算子与内存拷贝。
阅读全文关键词:训练
开发者生态
公开材料披露,1000颗昇腾910C完成1.6万亿参数DeepSeek-V4-Pro全参数后训练,MFU超过30%。落到机房,排查应从HCCL拓扑、Rank映射和版本组合开始,再用Profiler定位算子与内存拷贝。
阅读全文 前沿研究
模型文件变小,不等于端侧推理更快。量化压低位宽,蒸馏训练更小的学生模型,结构化剪枝直接改变网络形状。面向2026年的部署,算子支持、内存访问和持续功耗比单看压缩率更有参考价值。
阅读全文 开发者生态
 技术应用
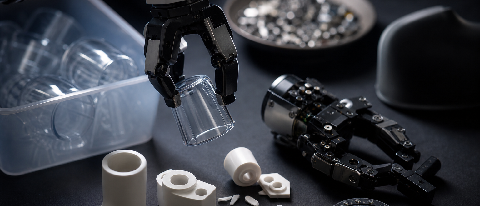
2026年7月,人形机器人进厂分拣不再是Demo。本文回访陶瓷件、透明杯等难题场景,用三个月连续生产数据揭示软硬件迭代后良率的真实提升幅度,并拆解灵巧手、触觉传感器与合成数据训练如何将不可能变为可行。结论是:离替人还有距
阅读全文 前沿研究
一次1024卡昇腾910C训练中,单卡峰值占用82GB,却在第437步集体OOM。排查发现,14GB空闲显存被切成最大仅3GB的连续块。通过定期紧凑和内存池预分配,项目将单步时间从4.7秒降至3.8秒,MFU由31%升至
阅读全文 前沿研究
从 Sora 到 Sora 2,视频生成能力持续提升,版权问题也从训练数据延伸到角色、声音和参考素材。平台不能只靠下架和投诉,还需要在上传环节核验内容来源、生成标识与授权情况。
阅读全文 AI 实操指南
欧盟通用人工智能模型相关义务已于2025年8月2日生效。选择Llama 4或Mistral时,除了模型能力,还要检查技术文档、训练数据摘要、版权政策和微调数据记录能否经得起审查。
阅读全文 前沿研究
现有素材没有提供可核验的910D测试数据。相比单卡跑分,企业更需要关注集群扩展、软件迁移和长期稳定性。基于目前的公开信息,国产算力的性价比拐点还无法下结论。
阅读全文 AI 工具箱
16GB 显存可以尝试 LoRA 微调 Qwen2.5-7B-Instruct,但客服 Agent 不能只靠微调。模型选择、训练数据、知识库和业务工具需要分开处理。
阅读全文 前沿研究
昇腾910C进入量产交付阶段后,国产AI芯片面对的不再只是单卡性能比较。集群稳定性、CANN适配、模型迁移和故障恢复,正在决定它能否真正接住大模型训练任务。
阅读全文Sora 2把真人形象带进AI生成场景,也把好莱坞积压已久的矛盾推到台前:训练素材由谁授权,演员的声音和肖像能否反复使用,生成视频又该如何标识。争议的核心已从技术效果转向使用规则。
阅读全文 开发者生态
华为昇腾910D集群实测:算子覆盖率75%、训练稳定性256卡通信瓶颈、调试工具链差距。从PyTorch到CANN的迁移成本与国产算力生态进展,基于真实项目数据深度拆解。
阅读全文