 前沿研究
Qwen3-Max显存占用降60%,本地部署成本真能减半吗
Qwen3.5发布资料给出Qwen3-Max显存占用降低60%、最大吞吐量提升至19倍,但这两组数字不能直接证明单张4090可跑,也不能推出成本减半。部署前要分清模型规模、量化权重、KV Cache和并发口径,再用vLL
阅读全文关键词:推理
前沿研究
Qwen3.5发布资料给出Qwen3-Max显存占用降低60%、最大吞吐量提升至19倍,但这两组数字不能直接证明单张4090可跑,也不能推出成本减半。部署前要分清模型规模、量化权重、KV Cache和并发口径,再用vLL
阅读全文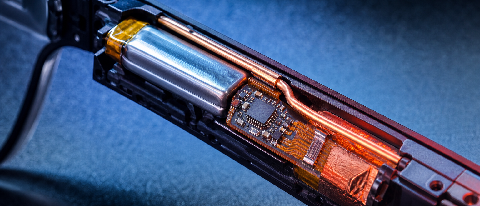 前沿研究
2026年AI眼镜密集上新,70亿参数模型已在手机端跑通,但塞进眼镜远不只是把芯片换小。异步量化推理能压内存,光波导和电池却卡住了系统调度。本文从算法、芯片、光学和功耗四条线索,拆解为什么"能跑"离"好用"还差一套工程协
阅读全文 前沿研究
Anthropic 推出 Claude Opus 4 与 Sonnet 4,重点强化编码、高级推理和 Agent。开发者更该关注 Extended Thinking 如何与工具调用结合,以及模型评测、权限控制和人工复核该
阅读全文B300已经可用,288GB HBM3e和CUDA路径适合近期部署;MI400计划2026年下半年出货,以432GB HBM4、19.6 TB/s带宽争取大模型推理。采购时还要算上交期、ROCm迁移和整机成本。
阅读全文 前沿研究
WWDC 2026 上,Siri AI 加入屏幕感知、个人上下文理解和跨 App 执行。苹果补上了语音助手最明显的短板,但据钛媒体,复杂推理仍依赖谷歌 Gemini,每年授权费约 10 亿美元,新功能也设有硬件门槛。入口
阅读全文 开发者生态
2026年3月,国产开源模型在Agent、代码生成和推理效率上的表现引发关注,模型间Token成本差距被概括为10—20倍。选型还要把微调、部署、重试、人工复核和迁移成本放进同一张账单。
阅读全文 产业动态
2026年7月,8000P智算中心暑期满档,酒仙桥园区闲时利用率升至48.3%。本文拆解混合部署的真实账本:边缘计算如何通过“带宽+冷却”倒逼的成本优化,承接实时推理与长尾微调,实现云边协同的泛在算力网络。
阅读全文 产业动态
北京酒仙桥8000P集群完成30天共享调度试验。按园区运营方披露,闲时利用率由22%升至48.3%,新增负荷主要来自实时推理和长尾微调。利用率上升后,散热、带宽和并发限制开始成为新问题。
阅读全文 前沿研究
北京酒仙桥、亦庄等算力园区用一年的时间,把一台8000P集群的空闲率从六成压到了三成。本文进入调度现场,拆解推理任务从训练集群"挤"出来的真实路径,以及中小企业如何用推理时段的便宜算力,避开"资源被套利"的二房东。
阅读全文H100、B200在中国云上又降了一档,但企业真要下单时,决定买卡还是租卡的关键不在单价。本文拆解阿里云、华为云与本地IDC的实际报价、电费摊销与训练/推理分场景的回收周期,给出中小企业可以照搬的算力账本。
阅读全文 前沿研究
Sora把60秒视频带进公众视野,ECCV 2026的303道测试题却暴露了另一面:画面已经很逼真,推理一致性仍未同步跟上。工业用户最终要算的是跨镜头稳定性、物理规则和失败重试后的总成本。
阅读全文 技术应用
2026年,车载AI Agent开始从语音问答走向多模态感知、工具调用和主动服务。放到停车场剐蹭场景,它可以帮车主找记录、理清时间线、生成陈述,但责任认定仍取决于证据效力和外部处理流程。
阅读全文