 前沿研究
R1开源后,手机跑30B模型先撞上散热墙
24GB内存的骁龙8 Gen 5旗舰机,已经能本地运行INT4量化的Qwen-32B:首字2.1秒,起步约8 tokens/s。持续推理后,机身升至46°C、速度掉到3 tokens/s,12分钟耗电23%。30B上手机
阅读全文关键词:手机推理
前沿研究
24GB内存的骁龙8 Gen 5旗舰机,已经能本地运行INT4量化的Qwen-32B:首字2.1秒,起步约8 tokens/s。持续推理后,机身升至46°C、速度掉到3 tokens/s,12分钟耗电23%。30B上手机
阅读全文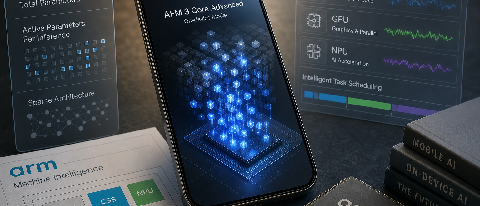 产业动态
苹果把AFM 3 Core Advanced做到约200亿参数,却通过稀疏架构控制单次推理的激活规模。结合Arm对CPU、GPU、NPU协同的强调,手机端侧选型需要重新评估实际计算量、部署适配和任务调度。
阅读全文 前沿研究
Arm正把SME2扩展到更多CPU平台,并强调内存、功耗和持续运行能力。但现有公开素材没有给出7B模型首Token延迟,也不足以证明手机端已达到150—300毫秒。
阅读全文