32GB 显存跑 70B,先算清 4-bit 的账
70B 模型做 4-bit 后,权重理论值仍约 35GB,单张 32GB 显卡还没给 KV Cache 和框架开销留空间。更现实的办法是用 GGUF 分层卸载、选择更低比特,或改用 32B 模型。
阅读全文关键词:70B模型
70B 模型做 4-bit 后,权重理论值仍约 35GB,单张 32GB 显卡还没给 KV Cache 和框架开销留空间。更现实的办法是用 GGUF 分层卸载、选择更低比特,或改用 32B 模型。
阅读全文一次从 A100 集群到昇腾 910D 的 70B 模型迁移,最耗时间的不是启动报错,而是 CPU 静默回退、HBM 碎片和 HCCL 长尾。按单卡、单机、多机逐级锁定基线,能少走不少弯路。
阅读全文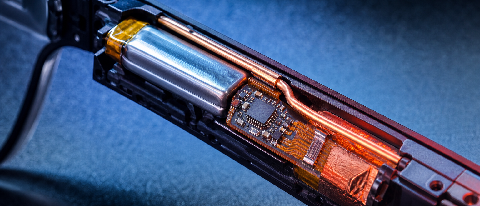 前沿研究
2026年AI眼镜密集上新,70亿参数模型已在手机端跑通,但塞进眼镜远不只是把芯片换小。异步量化推理能压内存,光波导和电池却卡住了系统调度。本文从算法、芯片、光学和功耗四条线索,拆解为什么"能跑"离"好用"还差一套工程协
阅读全文70B模型用FP16存权重约140GB,压到INT4仍约35GB,还没算KV Cache和其他车载任务。Thor为跨域计算留出更大余量,8775更看重座舱部署。真正影响选型的,是持续散热、算子覆盖、量化和故障隔离。
阅读全文 开发者生态
FlashMLA GitHub Star破7.2K,中小团队私有化部署进入实战期。实测RTX 4090双卡跑70B模型,拆解昇腾910D的HCCL优化与PPIO的PD分离架构,看清本地部署的真实算力账。
阅读全文DeepSeek蒸馏模型在香橙派和玄铁C920上的快速适配,展示了端侧算力优化的方向。LPDDR5X/6的普及让手机运行量化大模型成为可能,但42℃的温度墙和能耗比限制了其实用性。端侧AI更多是隐私保护和高频轻量任务的补
阅读全文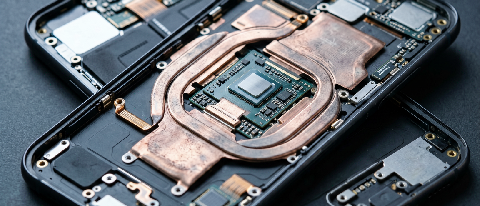 前沿研究
iPhone 19 Pro Max搭载A19 Pro芯片,实测连续运行70B本地大模型15分钟背部温度稳定61℃,全程无降频。VC均热板和二级缓存翻倍是散热质变的关键。标准版仍有限制,重度AI用户建议Pro Max。
阅读全文实测iPhone 19 Pro Max搭载M5芯片,本地70B大模型首字响应仅1.2秒,数据不出端。但连续高负载10分钟即触65℃温控红线,延迟飙至5秒,远不及三星S26 Ultra的20分钟稳定。跨App多步任务因切换
阅读全文北京国贸建筑工作室实测Vision Pro 3:M5芯片本地跑70B模型,首字延迟1.8秒,眼动追踪+手势操控把CAD和BIM图纸直接悬浮在眼前。跨国会议中全息标注让沟通轮次减少40%,但3499美元定价和600克重量是
阅读全文在弱信号电梯里拆封即测iPhone 19 Pro Max的Apple Intelligence 2.0。70B模型首字1.2秒,离线全功能可用。但持续生成10分钟,手机发烫、降频至2.8秒,逻辑题答错两道。轻任务够用,复
阅读全文WWDC 2026上,苹果宣布iOS 20将80%的AI推理任务默认在本地NPU执行,隐私数据不出设备。通过动态精度切换、智能内存交换和1x1卷积替换三个“野路子”,70B模型推理功耗降低30%,首字响应压至0.9秒。端
阅读全文iPhone 17 Pro 本地跑 70B 模型 10 分钟就烫到降频怎么办?本文实测三种非常规优化手段:动态精度切换(保持 95% 精度功耗降 25%)、iOS 20 智能内存交换(省带宽 20%)、以及用 1x1 卷
阅读全文