“玻璃杯掉在地上会碎”,语言模型通常能顺着这句话回答。真让机器人端起玻璃杯,题目马上变了:它要看清杯子与桌沿的位置,选择抓取点,控制夹爪力度,还要在杯子开始滑动时调整动作。语言常识说对了,杯子仍可能掉下来。
物理人工智能(Physical AI)处理的,就是这段从“知道”到“做到”的距离。2026年2月的一篇相关报道将差别概括得很直白:生成式AI擅长写文案、画插画,面对现实中的物理规律却容易失手;Physical AI还要理解3D空间,并接收传感器信号。这里的“身体”,包括摄像头、力觉与触觉传感器、执行器,也包括把反馈送回系统的控制回路。
会说“轻轻拿”,还不够
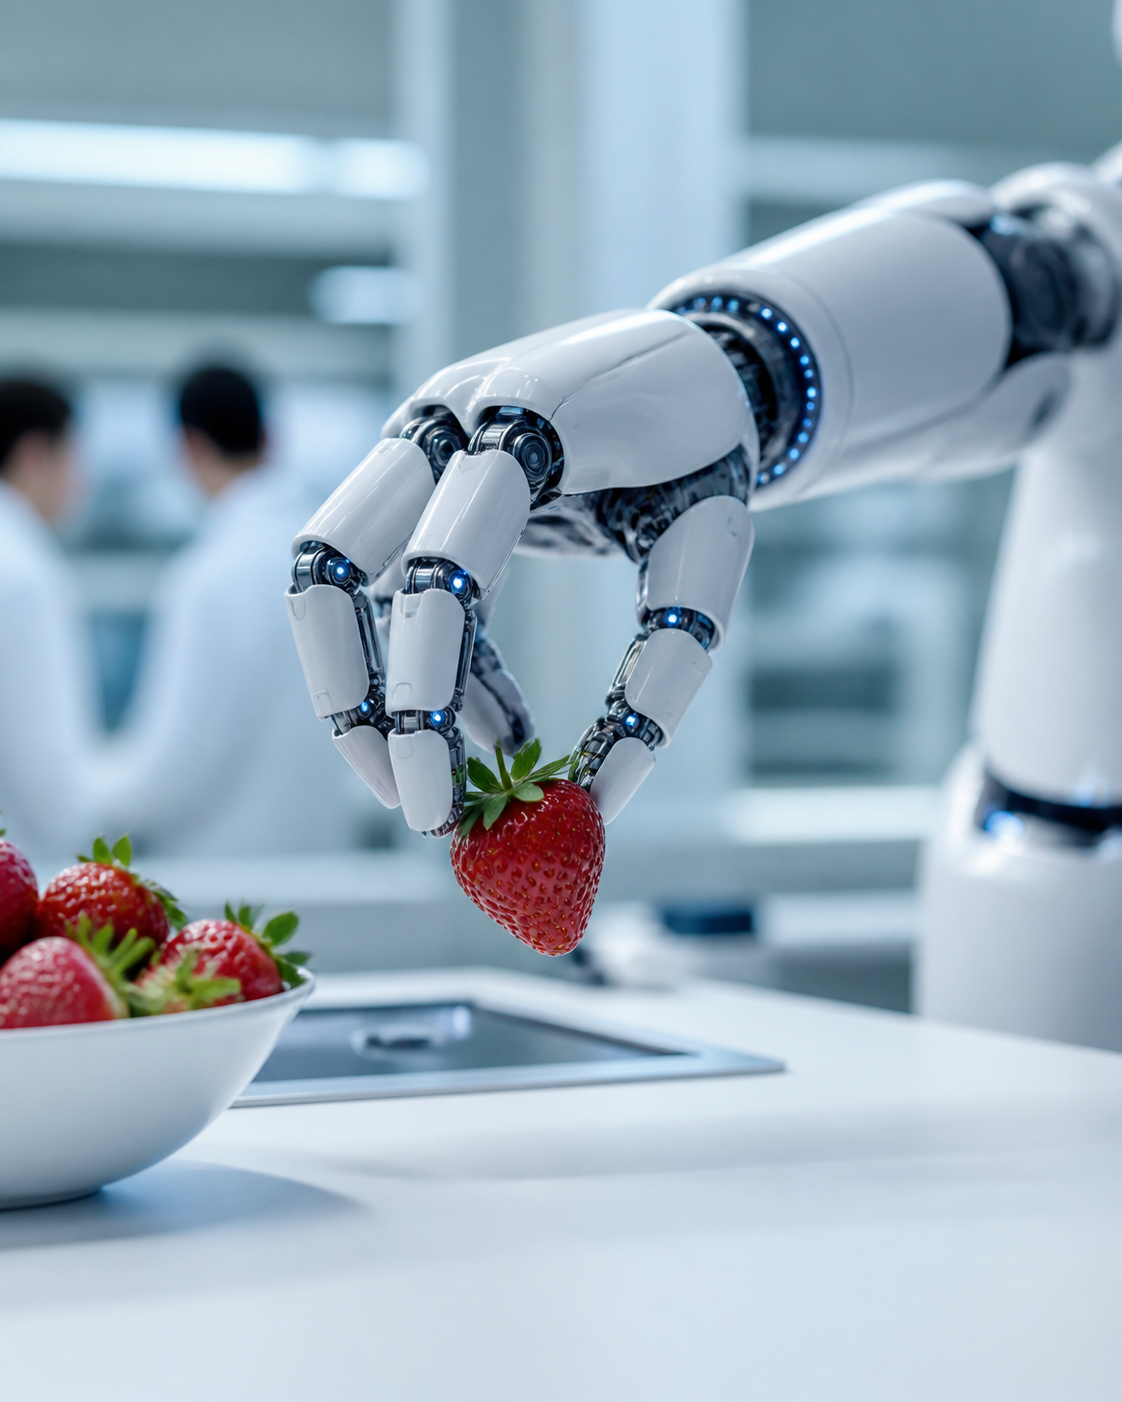
抓一颗草莓时,模型给出“轻轻捏住”的指令并不难。难的是把“轻轻”落实到接触力、移动速度、物体形变和是否滑动等状态上。文字里的形容词,到了机器人手里必须变成可以测量、可以调整的动作。
2025年6月,智源研究院院长王仲远接受采访时表示,人工智能正在加速从数字世界走向物理世界,“悟界”系列大模型承载了智源对这一趋势的判断。落到机器人上,模型处理的输入从Token扩展到连续的传感器信号,输出也从文字延伸到真实动作。
中国科学院高能物理研究所2025年1月11日发布的材料将意图理解、连续对话和交互修正列为大模型的重要能力。对机器人来说,交互修正的信号不只来自用户一句“做错了”,还来自相机画面、接触力和设备自身的状态变化。
世界模型要管动作之后
语言模型根据上下文判断接下来该说什么,世界模型更关心动作发生后,环境会变成什么样。
机械臂伸手之前,系统需要估计物体与夹爪的相对位置,以及接触后可能出现的移动和滑动。动作发生后,传感器再把真实结果送回来。预测与反馈对不上,控制器就要调整方向、速度或抓取力度,相关数据也可以留给后续训练和校准。
世界模型的价值落在后果估计。它不需要把每条物理定律都背成公式,但必须知道某个动作可能带来什么变化。《物理智能:打破数字壁垒,让AI触摸真实世界》把Physical AI概括为赋予AI影响现实环境的能力。一旦输出会改变物体的位置和状态,答错的代价就不再只是一段不通顺的文字。
摄像头看见位置,力觉判断是否到位
视觉擅长识别物体和判断空间关系,力觉与触觉则补上接触、滑动和形变信息。几类信号还要在时间上对齐,并经过稳定标定。否则,输入数量增加了,机器人依然可能抓得过松、压得过紧。
面对位置略有偏差、表面状态不同的非标零件,固定坐标往往不够用。机器人需要根据当前接触状态,判断零件是否卡住、是否插到位,以及要不要收回后重试。
一段演示看的是能不能做成一次,工业现场更关心能否反复完成、出现偏差后能否恢复、传感器漂移后是否还能校准。传感器融合最终要落到这些具体问题上。
“慢思考”该放在规划层
“整理桌面”是一条语义指令。大模型可以识别任务目标,安排物品顺序并选择放置位置;抓取力度、碰撞规避和平衡控制,则需要更靠近设备的本地回路持续处理。
更实际的系统通常采用分层控制:云端或较大的模型负责理解和规划,端侧模型与传统控制器负责执行,安全机制再限定动作边界。网络延迟和波动始终存在,现场控制不能把每一次修正都交给远端推理。
“慢思考”仍然有用,但要放对位置。它适合梳理任务约束、比较备选方案,不适合承担每一次快速姿态修正。规划可以多想一会儿,杯子开始滑动时,控制回路必须及时收手。
模拟器教动作,现场教分寸
模拟器提供了低成本试错的环境,可以调整摩擦、光照和物体位置。但真实现场还会出现材料差异、设备磨损和传感器噪声,训练时没有覆盖的小变化,就可能让原本成功的动作失效。这就是Sim2Real需要处理的问题。
现场失败数据因此很重要。物体滑落、零件没有插到位,都会暴露感知、预测或控制中的偏差。在生产环境里,更稳妥的做法是记录这些案例,经过训练和验证后再更新系统,而不是让机器人在现场不受限制地自行调整。
可靠,比会演示更难
判断物理AI是否真正可用,可以看一个很小的场景:它能否拿起易碎物体,发现滑动后及时调整,失败时找到问题,并在下一次动作中减少同类错误。做到这一步,“玻璃杯会碎”才从一句常识变成了可执行的约束。
Token吞吐量依然重要,但进入物理世界后,控制精度、环境适应力和失败恢复能力也成了直接指标。所谓大模型“长出身体”,最终要落在一条清楚的链路上:看见,预测,行动,校正。