长 Prompt 最先坏在异常分支
假设一个客服 Agent 的系统 Prompt 已经写到 2000 字:退款规则、说话语气、工具权限、异常处理都塞在一起。标准退款可以顺利完成,用户一旦改口说“只有部分商品破损”,支付网关又恰好超时,模型就得同时判断退款范围、工具调用结果和下一步动作。
继续补条件,短期内或许能修好这个请求,却会让下一次修改更危险。团队很难回答几个基本问题:任务现在走到哪一步?支付接口是否已经调用?这次超时能否安全重试?哪条规则触发了当前结果?
Prompt 适合描述角色、边界和单步任务,用它兼任流程引擎,状态就只能藏在上下文里。InfoQ 在复杂旅游规划实践中提到,单体 LLM 的 ReAct(Reason+Act) 模式进入长链路、多异构数据源场景后,会暴露出响应极慢、状态易崩、逻辑与执行深度耦合等问题。用户只问“故宫的历史背景”,同一条任务链也可能出现知识重复抓取。
这类故障很难靠一句“请严格遵守以上规则”修复。流程本身需要一个可检查、可恢复的载体。
状态机管的是业务进度,不是聊天措辞
有限状态机(FSM)只回答几件事:系统当前处于什么状态,发生了什么事件,接下来允许转移到哪里。
映射到 Agent 工作流后,三个概念都很具体:
- 状态(State):已经完成的业务检查点,例如“需求已解析”“等待支付”“支付失败,等待重试”。
- 事件(Event):用户补充信息、API 返回成功、工具超时、预算超限等信号。
- 转移(Transition):当前状态收到某个事件后,进入哪个状态,并执行什么动作。
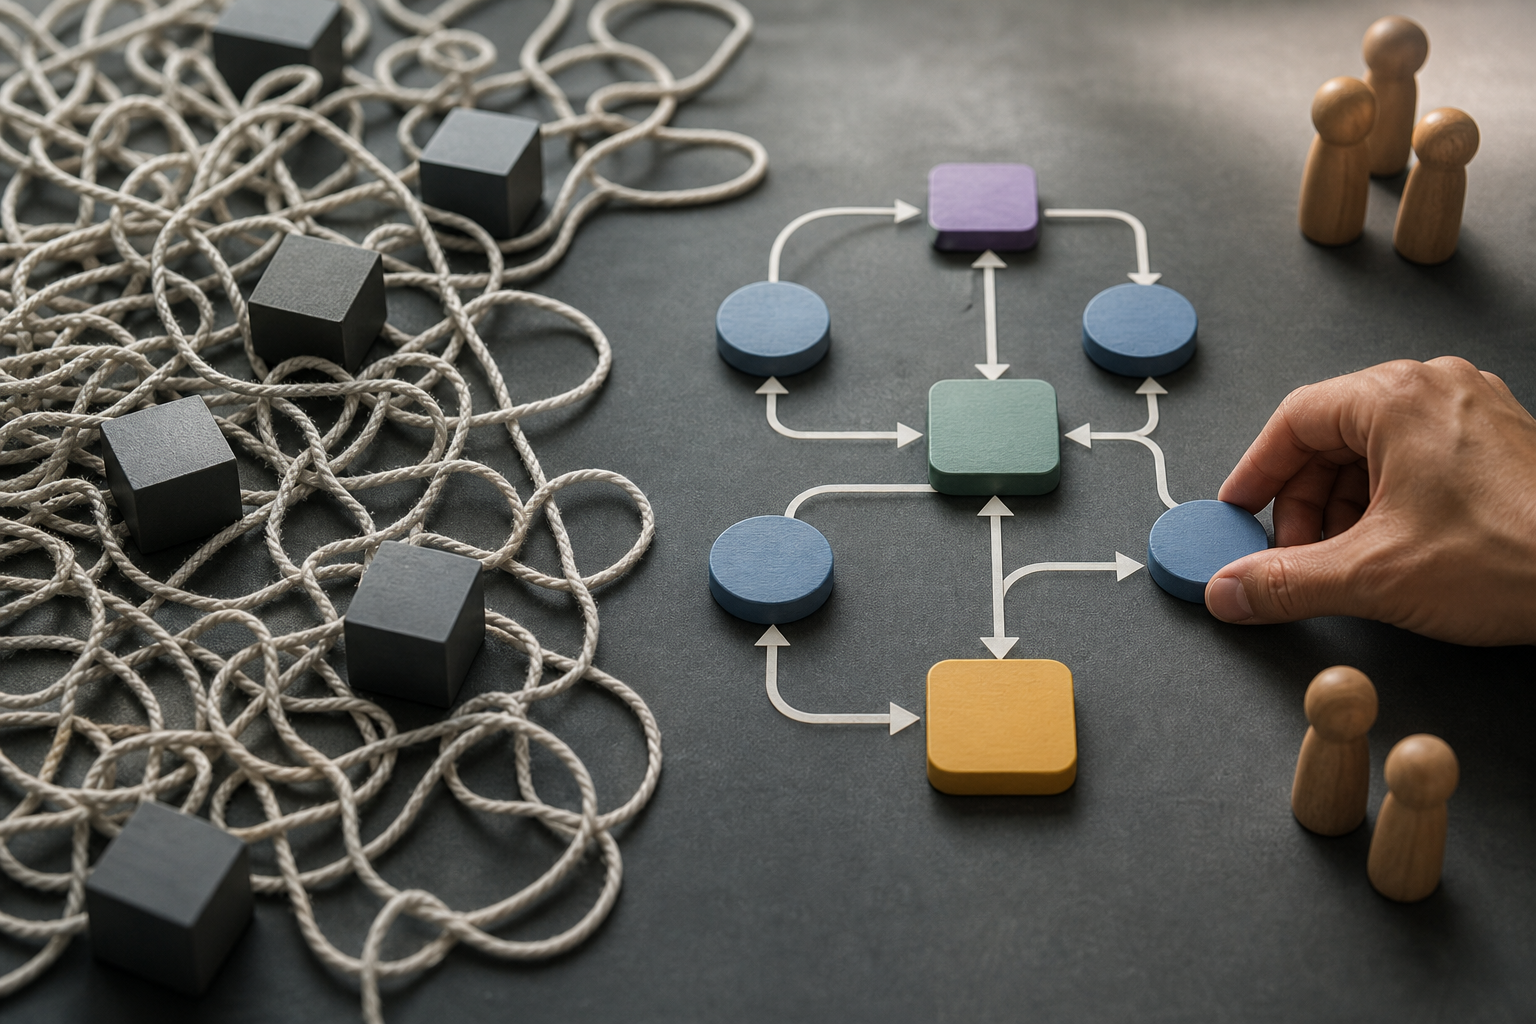
状态机不会让 LLM 的输出突然变得确定。它解决的是流程可见性:即使模型在某个节点输出错误,错误也会被限制在当前节点,外层代码可以校验结果、拒绝非法转移,并记录失败原因。
这和把所有规则写进 Prompt 的差别很直接。前者能明确看到 S1 收到 API_TIMEOUT 后进入重试;后者只能从一段对话里猜测模型是否记得超时分支。
北京三日游,可以这样拆
以“为用户规划北京三日游”为例,任务同时涉及需求解析、景点搜索、路线安排、酒店查询、预算确认和支付。可以先定义这些状态:
S0:初始需求解析,提取人数、日期、预算和偏好。S1:景点池搜索与筛选,调用搜索工具并整理候选景点。S2:行程路线编排,安排每日路线并考虑交通时间。S3:住宿预订查询,根据位置和预算查询酒店。S4:总预算核算与确认。S5:订单生成与支付。SFinal:任务完成或失败。
状态不必切得越碎越好。一个状态应该对应可验证的业务产物:S0 要输出结构化需求,S1 要留下景点列表,S4 要给出可核对的预算结果。
部分转移规则可以写成下面这样:
| 当前状态 | 事件 | 下一状态 | 处理动作 |
|---|---|---|---|
S0 |
REQUIREMENTS_READY |
S1 |
保存人数、日期、预算和偏好 |
S0 |
FIELD_MISSING |
S0 的追问子状态 |
只询问缺失字段 |
S1 |
SEARCH_OK |
S2 |
将景点列表写入工作记忆 |
S1 |
API_TIMEOUT |
S1 的重试子状态 |
累计重试次数 |
S1 重试子状态 |
重试 3 次仍失败 | SFinal |
标记为外部服务故障 |
S4 |
BUDGET_EXCEEDED |
S2 |
执行路线降级并重新核算 |
S5 |
PAYMENT_OK |
SFinal |
生成最终结果 |
预算超限后回到 S2,是一条写在代码里的业务规则。模型不需要在长上下文中回忆“是不是应该重新排路线”,也不能绕过预算检查直接进入支付。
让 LLM 只处理眼前这一步
进入 S1 后,LLM 的输入可以收窄为用户偏好和工具返回的景点列表,任务也只保留一句:按照给定条件返回排序后的 Top 5 景点。它不负责决定是否查询酒店,也不处理预算超限和 API 重试。
进入 S2 后,再让 LLM 根据候选景点生成路线。外层程序检查输出字段,通过后触发下一个事件;格式错误或关键字段缺失,则停留在当前状态处理。
状态转移可以由确定性代码驱动,例如使用 Python 状态机库 pytransitions:
from transitions import Machine

states = [
    'S0', 'S1', 'S1_RETRY', 'S2',
    'S3', 'S4', 'S5', 'DONE', 'FAILED'
]

transitions = [
    {'trigger': 'requirements_ready', 'source': 'S0', 'dest': 'S1'},
    {'trigger': 'api_timeout', 'source': 'S1', 'dest': 'S1_RETRY'},
    {'trigger': 'retry_exhausted', 'source': 'S1_RETRY', 'dest': 'FAILED'},
    {'trigger': 'budget_exceeded', 'source': 'S4', 'dest': 'S2'},
    {'trigger': 'payment_ok', 'source': 'S5', 'dest': 'DONE'}
]
这段代码不负责生成景点或路线,只负责限制允许发生的转移。每次转移还应把当前状态、结构化需求、工具结果、重试次数和失败原因写入任务上下文。任务中断后,可以从已记录的状态恢复,不必让模型重新阅读整段聊天并猜测进度。
如果使用多智能体,景点筛选、酒店查询和预算核算也可以交给不同 Agent。它们仍通过同一个状态上下文交接,流程顺序不由多个 Agent 的自由对话决定。
先把失败路径画出来
顺利路径通常不难,生产问题集中在工具和数据不按预期返回的时候。每个工具节点都要提前写清成功、可重试失败、不可重试失败以及等待用户补充信息时的去向。
例如:
- 景点 API 超时,进入重试子状态,重试 3 次后结束任务并记录外部服务故障。
- 用户缺少日期或预算,回到追问状态,不启动后续搜索。
- 总预算超限,回跳到路线编排,而不是让模型临时决定删掉什么。
- 支付网关超时,由接口状态和业务规则判断是否重试,不能仅凭 LLM 再发一次请求。
重试上限、回跳条件和终止原因都应写在代码里。这样排查故障时,日志能直接显示失败发生在 S1 / API_TIMEOUT,而不是留下一句含糊的“模型可能理解错了”。
状态机也可能被写得过重。如果每次模型调用、每个字段检查都做成独立状态,流程图会很快失去可读性。更合适的粒度是业务检查点;重复出现的景点搜索或酒店查询,可以封装成子流程。
GRPO 能调模型,不能代替流程控制
GRPO 属于模型级优化,它可以让模型在多步任务中更倾向于生成符合目标的轨迹,但模型输出仍然带有不确定性。状态机处理的是系统级问题:哪些动作被允许、哪个状态可以进入、失败后是否重试、任务何时终止。
两者可以叠加。在 S2 中使用经过 GRPO 优化的模型生成路线,同时保留 BUDGET_EXCEEDED 的回跳规则。模型负责提高当前节点的输出质量,状态机负责守住业务边界。
单纯拆分工具也不够。如果工具已经分成景点搜索、酒店查询和支付接口,但调用顺序、重试次数和终止条件仍由 LLM 临场判断,控制逻辑依旧藏在 Prompt 里。
哪些任务值得改成状态机
单轮问答、开放式写作或没有硬约束的生成任务,直接使用 Prompt 或 ReAct 往往更轻便。状态机更适合这些工作流:
- 任务跨越多个步骤和工具,执行时间较长。
- 预算、支付、权限等条件不能被模型自行绕过。
- API 超时、字段缺失等问题需要重试或恢复。
- 团队需要知道任务卡在哪个节点,并能复现当时的输入与结果。
阿里云开发者社区将 Agent 的能力概括为环境感知、自主决策、任务执行与反馈迭代;H3C 的技术栈拆解也以“感知—规划—行动”闭环为主线。状态机的作用,是把这个闭环落到可记录、可校验、可恢复的业务节点上。
当一个 Prompt 开始反复出现“如果……那么……”“失败后……”“完成 A 再执行 B”,先别急着再加一段“请严格按照以下 20 步操作”。把这些句子逐条改成状态、事件、转移条件和终止状态。Prompt 继续负责理解与生成,任务链则交给代码。