客服工单最麻烦的,往往不是单一问题。用户可能在一句话里同时问:“订单为什么没到、设备为何报错、能不能退款?”单个 Chatbot 能生成一段完整回复,真正接入业务后,系统还要查订单、读取设备日志、追踪物流,并在某一步失败时保留前面已经拿到的结果。
LangGraph 适合处理的是这部分。腾讯云开发者社区的介绍将它概括为 LangChain 体系中的流程编排工具,通过节点、边和状态组织多 Agent 协作。重点不在于让几个 Agent 轮流发言,而是把执行顺序、工具调用和退出条件写清楚。
智能体开发者社区的一则材料把 2026 年 7 月 17 日 WAIC 现场的信号概括为 AI 从“能聊”走向“会干”,并援引 Gartner 预测称,到 2026 年底约 40% 的企业应用会内置 Agent。这个背景解释了 Agent 为何受到关注,但是否需要 LangGraph,仍要看业务里有没有分支、循环、共享状态和失败恢复。
与其追着“最新版本”的标签跑,不如先看几个稳定的结构:State、Node、Edge、条件路由和检查点。具体 API 可能变化,下面的代码应按结构骨架理解,接入时还要核对项目安装的 LangGraph 版本。
先别堆 Agent,先拆清工单
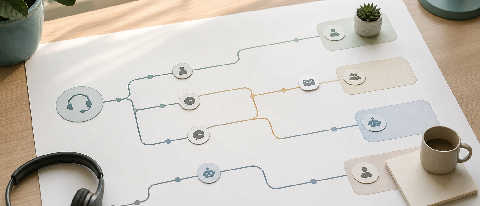
这套客服系统由一个 Router 和三个 Worker 组成:
| 节点 | 负责的任务 |
|---|---|
| Router | 识别用户意图,分发任务,复核 Worker 返回的结果 |
| Billing | 处理订单异常、账单与退款相关请求 |
| Tech | 处理技术支持,并调用设备日志工具 |
| Shipping | 查询物流状态,处理催单请求 |
Router 在这里不直接解决业务问题。它只负责判断下一步交给谁,以及工单是否可以结束。三个 Worker 各自使用有限的工具和上下文,避免一个 Agent 同时承担分类、查询、决策和回复。
如果几个 Agent 使用完全相同的提示词、数据和工具,拆分角色只会拉长调用链。多 Agent 真正有用的场景,是不同节点承担不同任务,且它们之间存在明确的交接关系。
状态不是聊天记录的另一个名字
LangGraph 用 State 保存节点之间需要共享的信息。客服案例可以先定义四个字段:
from typing import Annotated, List, TypedDict
from langchain_core.messages import BaseMessage
from langgraph.graph.message import add_messages

class AgentState(TypedDict):
    # add_messages 会追加新消息,而不是覆盖旧消息
    messages: Annotated[List[BaseMessage], add_messages]
    current_agent: str
    ticket_id: str
    resolution: str
messages 保存对话与工具返回内容,current_agent 标记当前由哪个节点处理,ticket_id 关联具体工单,resolution 留给最终处理结果。状态字段不必越多越好,只要足够支持路由、复核和恢复即可。
还要注意,定义 TypedDict 并不会自动获得持久化能力。要在故障后继续运行,需要在编译图时接入检查点或其他持久化实现。Billing 节点报错后能回到哪里,取决于检查点保存的位置,不能把它简单理解成任何场景都能自动完成“原子级回滚”。
用边把回路限制住
节点定义完成后,再用 StateGraph 写出它们之间的关系:
from langgraph.graph import END, StateGraph

workflow = StateGraph(AgentState)

workflow.add_node('router', router_node)
workflow.add_node('billing', billing_node)
workflow.add_node('tech', technical_support_node)
workflow.add_node('shipping', shipping_node)

workflow.set_entry_point('router')
workflow.add_conditional_edges(
    'router',
    route_decision,
    {
        'billing': 'billing',
        'tech': 'tech',
        'shipping': 'shipping',
        'end': END,
    },
)

workflow.add_edge('billing', 'router')
workflow.add_edge('tech', 'router')
workflow.add_edge('shipping', 'router')

graph = workflow.compile()
这段代码只展示图结构,router_node、billing_node、shipping_node 和 route_decision 仍要根据业务实现。route_decision 的返回值必须与映射表一致,并且要能识别已经处理完成的工单,否则三个 Worker 不断返回 Router,很容易形成循环。
原方案还提到 Worker 之间直接转交任务。例如 Shipping 发现订单需要退款,可以直接交给 Billing。实际落地时有两种写法:一是先把结果写回状态,再由 Router 转发;二是增加 Worker 到 Worker 的条件边。前一种多走一次路由,但处理路径更集中,也更容易检查。
ReAct 放在节点里,不要接管整张图
ReAct + LangGraph 的实践材料将 ReAct 概括为“思考—行动—观察—调整”的循环。放到客服节点里,就是让 Agent 先选择工具,读取工具结果,再决定下一步,而不是只凭模型已有信息直接作答。
技术支持节点可以先保留一个最小接口:
def technical_support_node(state: AgentState):
    response = tech_llm.invoke(state['messages'])
    return {
        'messages': [response],
        'current_agent': 'tech_support',
    }
这段代码还没有真正调用 get_device_logs,它只是节点外壳。工具需要绑定到模型,或者在节点内部单独执行,再把结果写回 messages。原方案列出的 Llama 4、Qwen 2.5-72B 可以作为模型层的候选,但是否适合,仍要通过实际工具调用测试判断。
模型可以替换,状态字段和路由关系应尽量稳定。这样更换模型时,不必连整套客服流程一起重写。
四个节点不等于并行执行
上面的图仍是串行路径:Router 分发给一个 Worker,Worker 完成后再回到 Router。节点数量变多,并不代表它们已经并行运行。
如果订单查询和物流追踪互不依赖,可以把它们拆成两个分支,同时执行,再交给汇总节点整理结果。但如果物流工具必须先拿到订单查询结果,就不能强行并行。两个分支同时写入 resolution 时也可能产生状态冲突,需要提前设计合并方式。
并行可能减少等待时间,实际收益仍取决于工具响应和汇总开销。没有链路测试,不宜直接写成“显著降低时延”。
上线前,先给循环装刹车
这套图最容易出问题的地方,是 Worker 返回 Router 后再次收到同一个任务。ReAct 节点内部也可能因为工具调用失败,反复执行“调用—报错—重试”。循环一长,API 调用和上下文都会继续增加。
至少要补上几道限制:
- 给路由设置明确的完成条件,例如检查
resolution是否已经写入; - 在运行配置中设置递归或迭代上限,具体参数按所用版本核对;
- 让工具错误以结构化结果返回,不要把异常文本当成普通回复继续传递;
- 记录每次节点跳转、工具调用和退出原因,必要时增加监控节点;
- 不要让每个 Worker 都重复读取与当前任务无关的全部历史消息。
成本排查可以对照站内的 LLM 推理账单排查清单,但不能套用缺少账单和调用记录支撑的固定浪费比例。
搬到昇腾 910D,先拆开推理链路
如果系统要从云端迁到本地昇腾 910D,模型权重能加载,并不代表多 Agent 客服已经可以正常运行。推理 Runtime、并发调用、工具协议和端到端响应都要重新验证。
更稳妥的顺序是先测单 Agent 推理,再接工具调用,然后加入 Router 和多个 Worker,最后检查并发与完整工单链路。相关问题可参看 客服 Agent 迁往昇腾 910D 的链路拆解。
什么时候值得用 LangGraph
下面几类任务更适合图编排:
- 一个请求需要经过多个工具或专业节点;
- 流程包含条件分支、复核或循环;
- 节点之间必须共享并保存业务状态;
- 出错后需要定位执行位置,选择重试、回退或人工接管。
如果任务只是固定顺序的短链路,普通 Chain、Dify 或 v0 往往更直接。低代码原型的搭法可参考 v0 和 Dify 的组合方式。当流程开始出现多次路由、状态恢复和工具权限边界时,再换到 LangGraph 更合适。
LangGraph 的价值不是让 Agent 数量变多,而是把路由、状态和失败边界写进一张可以检查、停止和恢复的图。多 Agent 系统能否稳定运行,最终要看三件事:每次分发有没有依据,工具结果能不能回到状态里,循环是否一定能停下来。