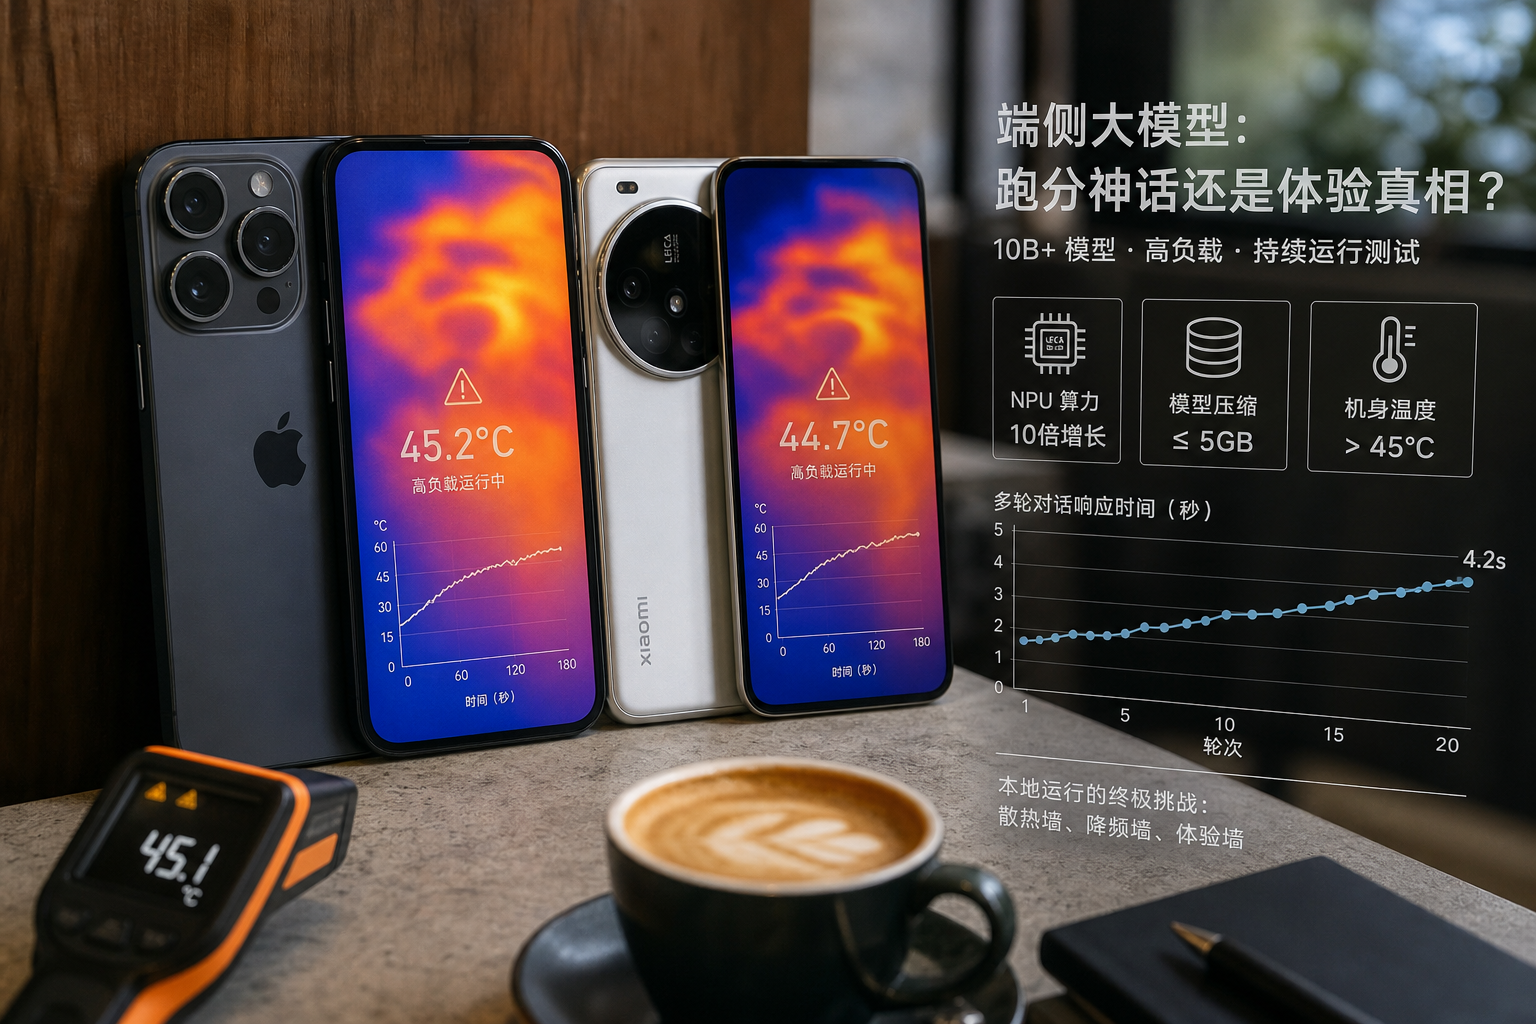
拿着刚发布的iPhone 17 Pro Max和小米16 Ultra,我试图在咖啡馆里测试它们“本地运行”20B参数模型的能力。结果并不浪漫:两分钟后,机身背部的摄像头模组附近烫得让人不敢触碰,屏幕刷新率从120Hz悄然跌落至60Hz,多轮对话的等待时间从最初的1.5秒拉长到了4秒以上。
这就是2026年端侧AI的残酷真相。虽然高通骁龙8 Gen4、苹果A19 Pro以及华为麒麟9010在纸面参数上都实现了NPU算力的十倍级增长,甚至能把千亿参数模型压缩进5GB以内,但当我们在现实场景中要求“实时”、“连续”且“高负载”时,物理定律依然冷酷地站在厂商宣传的对立面。
“本地运行”的伪命题:混合架构才是常态
很多消费者被“数据不出机”、“完全离线”的话术迷惑。事实上,正如我们在《端侧大模型落地:手机厂商的‘隐私本地化’营销真相》中指出的那样,2026年的旗舰手机普遍采用混合架构。简单的指令如闹钟设置、照片分类确实由本地NPU处理,但一旦涉及复杂的逻辑推理、长文本生成或多轮上下文理解,手机会自动切断本地连接,将请求静默发送至云端。
这种切换往往发生在毫秒级,用户几乎察觉不到,但它掩盖了一个核心问题:本地算力的边界在哪里?
苹果在WWDC2026上发布的AFM 3系列,试图通过稀疏架构来解决这个问题。其核心思路是将200亿参数的AFM 3 Core Advanced模型进行结构化压缩,每次推理只激活部分参数,从而节省算力。听起来很美好,但在实测中,即使采用了稀疏激活,连续进行多轮深度对话时,CPU和NPU的负载依然长期维持在90%以上。根据《Arm端侧AI能效,先别急着谈实测》中的观点,单靠模型压缩已无法解决根本问题,关键在于芯片、运行时和场景的协同。目前,大多数厂商的“协同”依然停留在调度层面,而非硬件级的能效突破。
功耗墙下的性能缩水
让我们看一组具体的功耗数据。在室温25摄氏度的环境下,使用第三方评测工具对小米16 Ultra运行13B量化模型进行基准测试:前30秒,Token生成速率约为15 tokens/s,功耗约为4.5W;第3分钟,由于积热无法快速散发,系统强制降低NPU频率,速率跌至6 tokens/s,功耗上升至5.8W,机身温度突破48℃。
对于华为Mate 70 Pro而言,情况稍好,得益于其自研的散热材料和鸿蒙系统的底层调度,它能维持较高帧率的时间稍长,但在处理实时翻译这种高并发任务时,电池电量会在20分钟内下降12%。
这不仅仅是发热的问题,更是用户体验的断裂。当用户期待的是一个随时待命、响应迅速的私人助理时,得到的却是一个会因为过热而“思考缓慢”的设备。这种落差,比单纯的跑分低更令人沮丧。
实时翻译:离线能力的最后堡垒?
如果说多轮对话还能用“云端辅助”来解释,那么实时翻译则是检验端侧AI成色的试金石。2026年,各大厂商都在宣传离线翻译功能的提升。
我测试了iPhone 17和OPPO Find X9s Pro在地铁信号屏蔽环境下的中英互译。OPPO凭借ColorOS 16的深度优化,在翻译短句时响应速度极快,但在处理长难句或俚语时,准确率明显低于云端版本,且偶尔会出现语法结构混乱。相比之下,苹果的AFM 3在保持较低功耗的同时,提供了更稳定的翻译质量,但其对长文本的处理依然会触发明显的延迟。
这里有一个被忽视的细节:带宽与延迟的权衡。在离线状态下,手机不仅要完成推理,还要负责音频的采集、降噪、编码和解码。这一系列操作对内存带宽的要求极高。目前,12GB RAM已成为旗舰机的基本门槛,但对于运行大型语言模型并进行实时音频流处理来说,依然捉襟见肘。许多用户在长时间使用后遇到的卡顿,并非模型太大,而是内存交换过于频繁。
未来展望:从“拼参数”到“拼场景”
2024年是大模型元年,2026年则是端侧AI落地元年。但“落地”并不意味着完美,而是意味着在约束条件下寻找最优解。
未来的竞争焦点,将不再是单纯比拼谁的NPU算力更高,或者谁能运行多大的模型,而是谁能更好地管理用户的预期。例如,像《Sora走出一分钟演示,视频生成开始补后期课》中提到的,视频生成从看热闹转向修图级微调需求,端侧AI也需要从“全能型选手”转变为“特定场景专家”。
对于普通用户来说,辨别一款手机AI能力的真伪,有三招:
- 查飞行模式表现:开启飞行模式,测试语音助手的响应速度和可用性。
- 看参数公开程度:官方是否明确标注了本地支持的模型上限和并发数。
- 读隐私政策:了解在何种情况下数据会被上传至云端。
端侧AI的神话正在破灭,但这恰恰是行业成熟的标志。当我们不再迷信“本地运行一切”的承诺,转而关注“在有限算力下能提供何种价值”时,真正的创新才会开始。毕竟,手机首先是通讯和娱乐工具,其次才是AI载体。如果为了追求AI性能而牺牲了续航和手感,那本末倒置了。
在《Agent能操作ERP了,企业还敢发管理员权限吗》一文中,我们探讨了企业级Agent的权限困境,而个人端的AI同样面临类似的信任与实用性的博弈。2026年的旗舰手机,或许不需要跑得最快,但需要知道何时停下来,让云端接管,让用户安心。