芯片厂商们终于不再把全部发布会时间留给 TOPS 这个参数了。
在2026年初 Arm 公布的20项技术预测中,一个明确的信号是:计算模式正从集中式云架构向覆盖各类设备、终端及系统的分布式智能架构演进。但更刺骨的现实在5月28日的上海张江科学会堂被摆到了台面上——在第十届集微大会“端侧AI峰会”上,安谋科技产品战略总监张冰直言,端侧AI迎来爆发拐点,但本质绝非“云侧AI小型化”那么简单。
跑不快的病根不在算力乘法,而在访存除法。
被 TOPS 掩盖的“带宽刺客”
翻开任何一张2026年主流移动 NPU 的参数表,INT8 算力动辄飙至几十上百 TOPS。这在纸面上足以应付 3B 参数量级的端侧模型实时推理,但硬件跑 benchmark 和跑真实大模型完全是两个世界。
端侧推理在一次 token 生成中,计算部分的耗时占比其实极低。真正的物理时间消耗在等待权重从 LPDDR 内存搬运到 NPU SRAM 的总线上。芯片内部的内存带宽(如表显的 136 GB/s 或更高)看起来庞大,但需要被多模块共享。大模型推理时需要密集加载海量权重,实际有效带宽往往只有标称值的 60% 甚至更低。这就导致 NPU 的 TOPS 空有峰值,却因喂不饱数据而在时钟周期里空转。
一旦模型塞进手机,烫手和超时就成了常态。关于功耗墙的成因,我们在《端侧 7B 模型让手机发烫退掉单:功耗墙怎么破》中曾拆解过骁龙 8 Gen 4 机型的运行日志——手机烫得拿不住、推理超时退单,7B 模型塞进旗舰机后的真实翻车案例比比皆是。底层的起因高度一致:算力单元全速狂飙,但总线带宽被拉满,缓存命中率暴跌,DRAM 频繁开启自刷新,功耗瞬间失控。
架构层面的“绕墙”战术
既然内存带宽是物理硬墙,2026年芯片和终端厂商的解法开始走向分化。
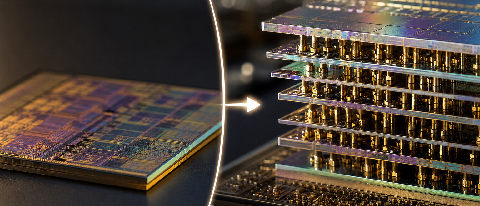
一种思路是向芯片内部要空间。Arm 在年初预测中明确提出,2026年的芯片创新将更多来自新型材料应用与先进封装技术,如3D堆叠和芯粒集成。其核心目的就是缩短算力与存储之间的物理距离,通过增加片上 SRAM 容量来提升缓存命中率,把 DRAM 访问频率压到最低。
另一种思路是直接动模型架构的刀。6月9日 WWDC2026 上发布的苹果 AFM 3 系列就是典型。据36氪报道,苹果发布了约200亿参数的端侧主力 AFM 3 Core Advanced,把模型本体做大,但通过稀疏架构,每次推理只激活其中一部分参数。这种设计从根本上为端侧省算力和省带宽而生:控制激活参数的规模,等于直接控制了跨总线读取权重的数据量,在不改变物理内存带宽的前提下实现了推理效率的提升。
与之相对的是谷歌 Gemini Nano 的蒸馏路线。早期 Gemini 技术报告提及,该模型由更大的 Gemini 模型蒸馏而来,意在压瘦身段,减少模型总参数量,从而在较小的访存带宽约束下跑出可用速度。这种路线本质是在做总盘子上的减法,以退为进。
全栈协同拼的是命中率
无论架构如何演进,3B 模型取代 7B 成为端侧主力已经是今年的行业共识。但这并不意味着 3B 模型不需要架构优化。
张冰在那个演讲中精准点出了症结:端侧 AI 本质是“本地大模型 + 智能路由 + 云边协同”的全新统一智能架构。在这个架构里,光有跑在 NPU 上的算子是不够的,还需要 CPU、VPU 及安全 IP 的全栈端侧 AI 技术布局来切分任务、降低功耗。
我们回看真正卡带宽的场景:深度网络的逐层计算中,中间激活值的读写占据了巨大带宽。端侧模型上下文一旦拉长,KV Cache 将呈线性甚至指数级膨胀,对带宽的吞噬是毁灭性的。在《MoE 架构跑通万亿参数了,但显存碎片正在拖垮推理速度》一文中,我们曾详细拆解访存瓶颈对推理延迟的拖累,这一规律在移动端链路上被成倍放大。如果 NPU 只是暴力预取或者不区分冷热地全量调度缓存,手机瞬时功耗将直接突破热设计上限。
端侧优化的必经之路,是对总线和缓存做精细的颗粒度调度。给高频重用的 KV Cache 分配片上 SRAM 常驻区,对冷门上下文做量化压缩并踢回 DRAM,是当前提升有效带宽利用率的核心手段。在量化层面,不仅是传统的权重 INT8 量化,逐步向 4-bit 权重量化推进正在成为标配。可以降低 50% 以上访存带宽负担的权重共享调度,已经在 Arm v9 指令集以及主流 NPU 框架的最新工具链中被默认开启。
落地链条上的软件堵点
Arm 高管的洞察直指出,2026年端侧战事拼的是软件栈与硬件架构的咬合度。硬件厂家把带宽提到了 120 GB/s 以上,但 ML compiler 对算子融合和内存复用的优化如果不到位,带宽利用率极有可能掉到 30% 以下。
这也解释了既定趋势:为什么从 2025 到 2026 年,产业链中主打底座能力建设和模型编译优化的企业活得最好,而单纯卖 TOPS 纸面数据的二线芯片厂在迅速掉队。端侧大模型落地的障碍早已不在算法,而是架构层面的工程账本。正如《让客服机器人‘听懂’方言,比训练大模型更难的是收集数据》一文揭示的产业 AI 共识——“落地比参数重要”,今天端侧 AI 的硬通货,正在从 TOPS 这个单纯的数字堆叠,深刻让位于真实带宽基础设施和调度效率。
端侧推理之战的白热化意味着违背物理定律的倒推已到尽头。与其迷信算力峰值,不如查查你的芯片到底跑出了多少内存带宽的有效净值。