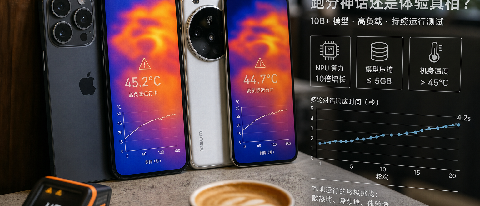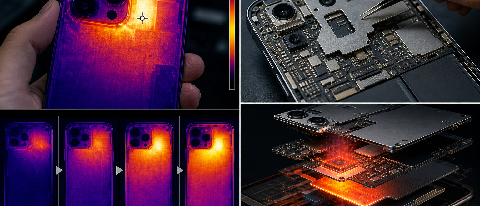
上个月拿到三台骁龙8 Gen5量产机跑14B模型,热成像仪拍到摄像头模组飙到47.2℃。不是峰值,是连续推理15分钟后的稳定温度。这件事我们在上一篇《骁龙8 Gen5实测翻车:14B模型跑顺了,但摄像头被烤到47℃》里拆过——NPU调度确实把整机功耗压到了5.8W,但热点从中框横向串扰到了摄像头区域。
这不只是握持体验的问题。CMOS传感器在40℃以上噪点开始失控,47℃意味着你一边用端侧AI修图,一边在毁掉成像质量。手机厂商的散热团队现在面对一个没人预料到的课题:从单热点设计转向双热点分区方案。
但发热只是第一个坑。
内存带宽:14B模型跑得动,但跑不稳
14B模型在端侧运行需要持续占用8-12GB内存。当前旗舰机的LPDDR5X带宽在60-70GB/s区间,听起来够用,但这是理论峰值。实测中,模型推理时的内存访问模式是高度随机的,实际有效带宽往往只有峰值的40%-50%。
据《端侧NPU调度优化》一文拆解,2026年6月落地的混合精度量化和稀疏激活技术把模型压进了更小的内存窗口,但真正让模型跑稳的是编译器指令集调整、动态批处理和内存池化。这些优化不是芯片厂一家能做的,需要手机厂商和模型开发者一起下场。
问题就在这——开发者根本下不了场。
一套没人能用的SDK
硅谷端侧AI公司Nexa AI在GitHub上发布的Nexa SDK,把适配困局摆上了台面。据界面新闻报道,当前端侧部署有两个核心痛点:一是跨平台适配壁垒——在高通PC上能跑的多模态模型无法自动移植到高通车载端;二是NPU普遍只能跑一年前发布的旧模型,Mistral3、Qwen3-VL这类新模型需要等很久才能得到支持。
这意味着什么?开发者花三个月调优了一个端侧模型,等到手机量产时,NPU驱动可能还不支持它。手机厂商自己推的端侧功能——本地翻译、屏幕内容理解——走的是定制化模型,跟第三方开发者用的开源模型是两条技术栈。
OPPO在2025年世界人工智能大会上展示的成果很具体:据投资界2026年1月报道,峰值出字速度200 token/s,支持128K超长文本,单设备能本地处理约300页书籍内容。但这是Demo机上的数据,用的是OPPO自研调度和定制模型。普通开发者拿开源模型往上放,连一半速度都跑不出来。
联发科在2025年9月提出从“架构、算法等多方面的底层技术创新”来提升端侧AI能力,方向是对的,但高通、联发科、Google Tensor团队各自在推自己的工具链,安卓端的碎片化没有收敛迹象。iPhone阵营相对封闭,苹果对Core ML和ANE的控制力更强,但这也意味着第三方开发者很难绕过苹果的审核和优化节奏。
本地记忆入口:谁在抢,谁在怕
当14B模型能在手机端离线运行后,一个新的战场正在形成:本地记忆入口。
我们在《端侧14B普及后,手机厂商开始争夺'本地记忆'入口》里写过,苹果、华为、安卓厂商都在用端侧RAG技术构建个人知识库——聊天记录、浏览历史、日程安排、位置轨迹,全部在本地向量化存储,由端侧模型检索和推理。这不是“手机能不能跑大模型”的问题,而是“谁掌握了用户数据的本地索引权”。
但隐私计算的安全账没那么好算。《GPT-5权限翻车之后》一文拆解过,某跨国物流巨头因权限配置失误导致预算数据泄露。手机端的个人数据更敏感,一旦本地RAG的向量库被其他应用越权读取,后果比云端泄露更难追溯。权限分层、向量库分段、Agent沙箱这三招在企业端已开始落地,但手机端还没看到成熟的工程方案。
2026下半年的三个硬指标
判断一台手机AI能不能用,跑分表上的TOPS数字已经没意义了。该看的是:
连续推理30分钟,摄像头温度不超过42℃。 不是SoC温度,是摄像头模组温度。这需要散热架构从根上重做,不是加一层石墨烯就能解决。
本地RAG检索延迟低于200ms,完全离线。 这意味着向量库的索引更新、模型加载和推理必须在同一块芯片上完成,中间不能切到云端。目前能做到这点的只有苹果的ANE+Core ML闭环,安卓端还在拼凑。
第三方模型适配周期不超过两周。 Nexa SDK的思路是对的——把跨平台适配抽象成统一接口。但需要高通、联发科开放更底层的NPU指令集。如果继续各自为战,端侧AI应用会永远停留在厂商自研的演示功能层面。
iPhone 18 Pro传用台积电2nm芯片,A20 Pro的NPU算力可能突破50 TOPS。Tensor G5押TPU与Gemini Nano垂直整合。骁龙8 Gen5在通用算力上继续堆料。三条路线没有谁绝对领先,但谁能先把发热、适配和权限这三件事同时搞定,谁才算把端侧AI从Demo带进了日常。
47℃的摄像头和一套没人能用的SDK,比任何跑分都更诚实。