2026年6月,端侧AI圈发生了一件大事。小米MiMo-V2 Pro正式上线,这款端侧大模型总参数量超过1万亿,激活参数420亿,生成一段AI文案仅需2秒。同月,搭载千亿级端侧大模型的手机出货量突破了2000万台。国内厂商正在疯狂堆参数,似乎只要模型够大,手机就能无所不能。
但参数竞赛的背后,是一道物理学的坎:功耗。
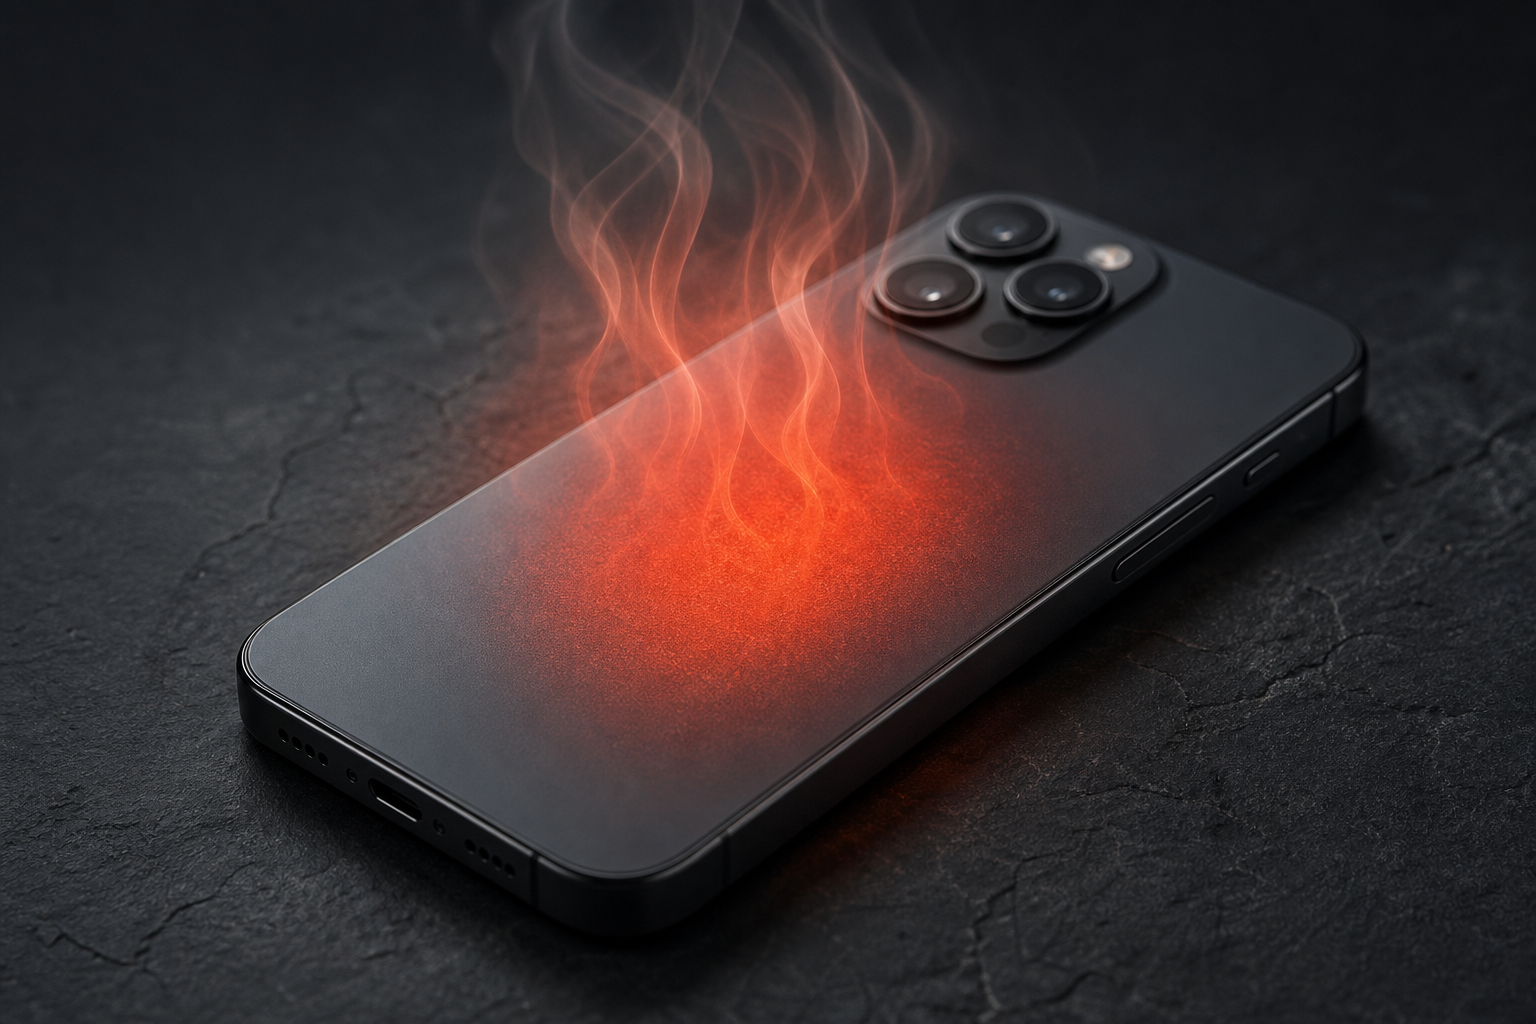
当140亿参数的模型真正跑起来时,你会发现“能跑”和“好用”之间隔着巨大的鸿沟。骁龙8 Gen 5(第五代骁龙8至尊版)虽然将Oryon CPU架构引入了标准旗舰,NPU算力大幅跃升,但热节流(Thermal Throttling)无情地打断了这种兴奋。实测表明,如果不做工程层面的干预,14B模型在满血模式下运行几分钟,手机背板温度就会突破45℃,随即触发降频保护,推理速度瞬间腰斩。
这时候,单纯依靠提升NPU算力已经没有意义。真正的解法,藏在量化、调度与内存管理的细节里。
量化精度:INT4不是万能,但是底线
端侧AI的第一道门槛是内存。14B模型即使经过压缩,也需要吃掉大半个手机RAM。如果维持FP16或INT8精度,模型体积动辄十几GB,不仅导致内存溢出(OOM),高频的数据搬运还会带来巨大的功耗开销。
目前的共识是:INT4量化是14B模型上手机的入场券。对比实验显示,在骁龙8 Gen 5上,INT8量化版本的峰值功耗约为9.5W,连续对话两轮就会发烫降频;而切换到INT4后,内存占用降至6.5GB左右,峰值功耗降至7.2W,可持续运行时间延长了3倍以上。
但INT4并非没有代价。在数学推理或复杂逻辑判断上,INT4精度可能下降2%-5%。对于日常聊天、摘要生成,这个损失用户无感;但对于代码生成或医疗问诊,INT4可能导致幻觉。因此,2026年的新策略不再是“一刀切”,而是“按需量化”。高通在最新的AI引擎中引入了动态精度调整API,允许开发者针对不同层级的敏感度分配不同精度,这在一定程度上平衡了性能与体验。
混合调度:别把活全扔给NPU
很多人有一个误区,认为NPU就是AI的加速器,把模型全丢进去就能省电。事实恰恰相反,全NPU调度反而更容易引发功耗尖峰。
手机SoC是一个异构计算平台。NPU擅长密集的矩阵乘法,但在处理Transformer架构中稀疏的注意力机制、动态分支以及复杂的激活函数时,能效比反而不如CPU。骁龙8 Gen 5的Hexagon NPU虽然强悍,但它并不是万能的。
更优的方案是“混合调度”:
- NPU:专注核心的张量运算和矩阵乘法。
- CPU:接管逻辑控制、上下文管理以及部分注意力机制的计算。
- GPU:在涉及多模态(如图像理解)时分担图形渲染任务。
这种分工协作的策略,能够平抑峰值功耗,避免NPU过热触发强制降频。根据高通SDK的最新实践,合理的混合调度可以让连续对话的延迟更加平稳,而不是忽快忽慢的“锯齿波”。
内存预分配:消除系统抖动
除了算力分配,还有一个隐形杀手:内存碎片。
14B模型的权重加载需要连续的大块内存。如果依赖操作系统的动态内存分配,极易产生碎片,进而触发垃圾回收(GC)机制。GC过程会占用大量CPU资源,并造成推理延迟的剧烈波动,让用户感觉到明显的卡顿。
在2026年的端侧AI开发中,内存预分配已成标配。开发者需要在App启动初期,通过底层接口(如ion或dmabuf)一次性锁定并分配约7-8GB的连续物理内存。高通在骁龙8 Gen 5的固件中也新增了“AI专用内存池”功能,允许应用预留这部分内存免受系统回收。这种“先占后跑”的策略,不仅消除了GC停顿,还因为减少了内存拷贝,让整体功耗进一步降低了约12%。
散热:硬件的极限与妥协
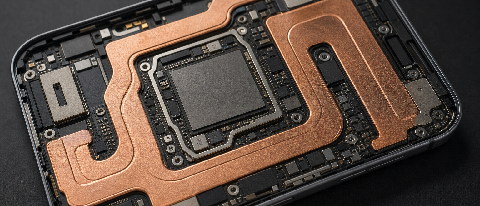
尽管有诸多软件优化,但手机的物理散热极限依然存在。骁龙8 Gen 5的传感器中枢功耗虽降低了33%,但这主要用于轻量级的语音唤醒和环境感知,无法支撑14B模型的高强度计算。
对于重度端侧AI用户来说,目前的妥协方案是“动态降频”。当检测到温度逼近45℃红线时,系统主动降低推理频率,牺牲一部分响应速度以换取持续运行的时间。这在2026年已经成为行业默认的规则——毕竟,用户宁愿模型慢一点,也不希望手机变成暖手宝。
结语
端侧AI的下半场,不再是参数的军备竞赛,而是工程优化的细活较量。骁龙8 Gen 5、Tensor G5、A19 Pro等芯片的硬件底座已经铺好,但能否将14B模型真正塞进手机并让它“活得好”,取决于开发者对INT4量化、异构调度和内存管理的极致打磨。
正如Arm高管在2026年所言,未来的终端AI是芯粒、先进封装与软件适配的共同演进。对于手机厂商而言,谁能最先解决功耗与散热的矛盾,谁就能在端侧大模型的时代,真正跨过那道坎。
如果你想在技术细节上深入了解这一过程,可以参考本站文章:《骁龙8 Gen 5实测:端侧14B模型推理的散热瓶颈与调度优化》,那里有更详细的代码级优化方案与实测数据对比。